02/数量データと因果推論

現代政治分析入門1

鈴木淳平

駒澤大学法学部政治学科

2026-10-06

出席登録をお願いします

今日の目次

  1. はじめに
  2. 因果関係
  3. モデルの特定化
  4. ランダム性と内生性
  5. ランダム化実験
  6. まとめ

はじめに

本日の目的と到達目標

目的

因果関係およびデータを用いた因果推論の枠組みを議論する。因果関係とはそもそも何かを定義したのち、データを使って因果推論するにあたっての難題として、ランダム性と内生性という概念を紹介する。ランダム化実験の強みと限界について理解する。

到達目標

  1. 因果関係と相関関係の違いを説明できる。 基本となる統計モデル(\(Y_i=\beta_0+\beta_{1}X_{i}+\varepsilon_i\))の各項を説明できる。
  2. 標本抽出のランダム性がなぜ因果推論を困難にするのかを説明できる。
  3. 内生性がなぜ因果推論を困難にするのかを説明できる。
  4. ランダム化実験がなぜ外生性を実現するのかを説明できる。
  5. ランダム化実験の3つの限界を列挙できる。

小テストの講評

TBD

因果関係

因果関係 (causality)

原因と結果の関係

  • 原因=独立変数
  • 結果=従属変数

因果関係の3条件(入門1より)

  1. 共変関係
  2. 他の変数の統制
  3. 原因の時間的先行

→内生性という概念で捉え直す

質問

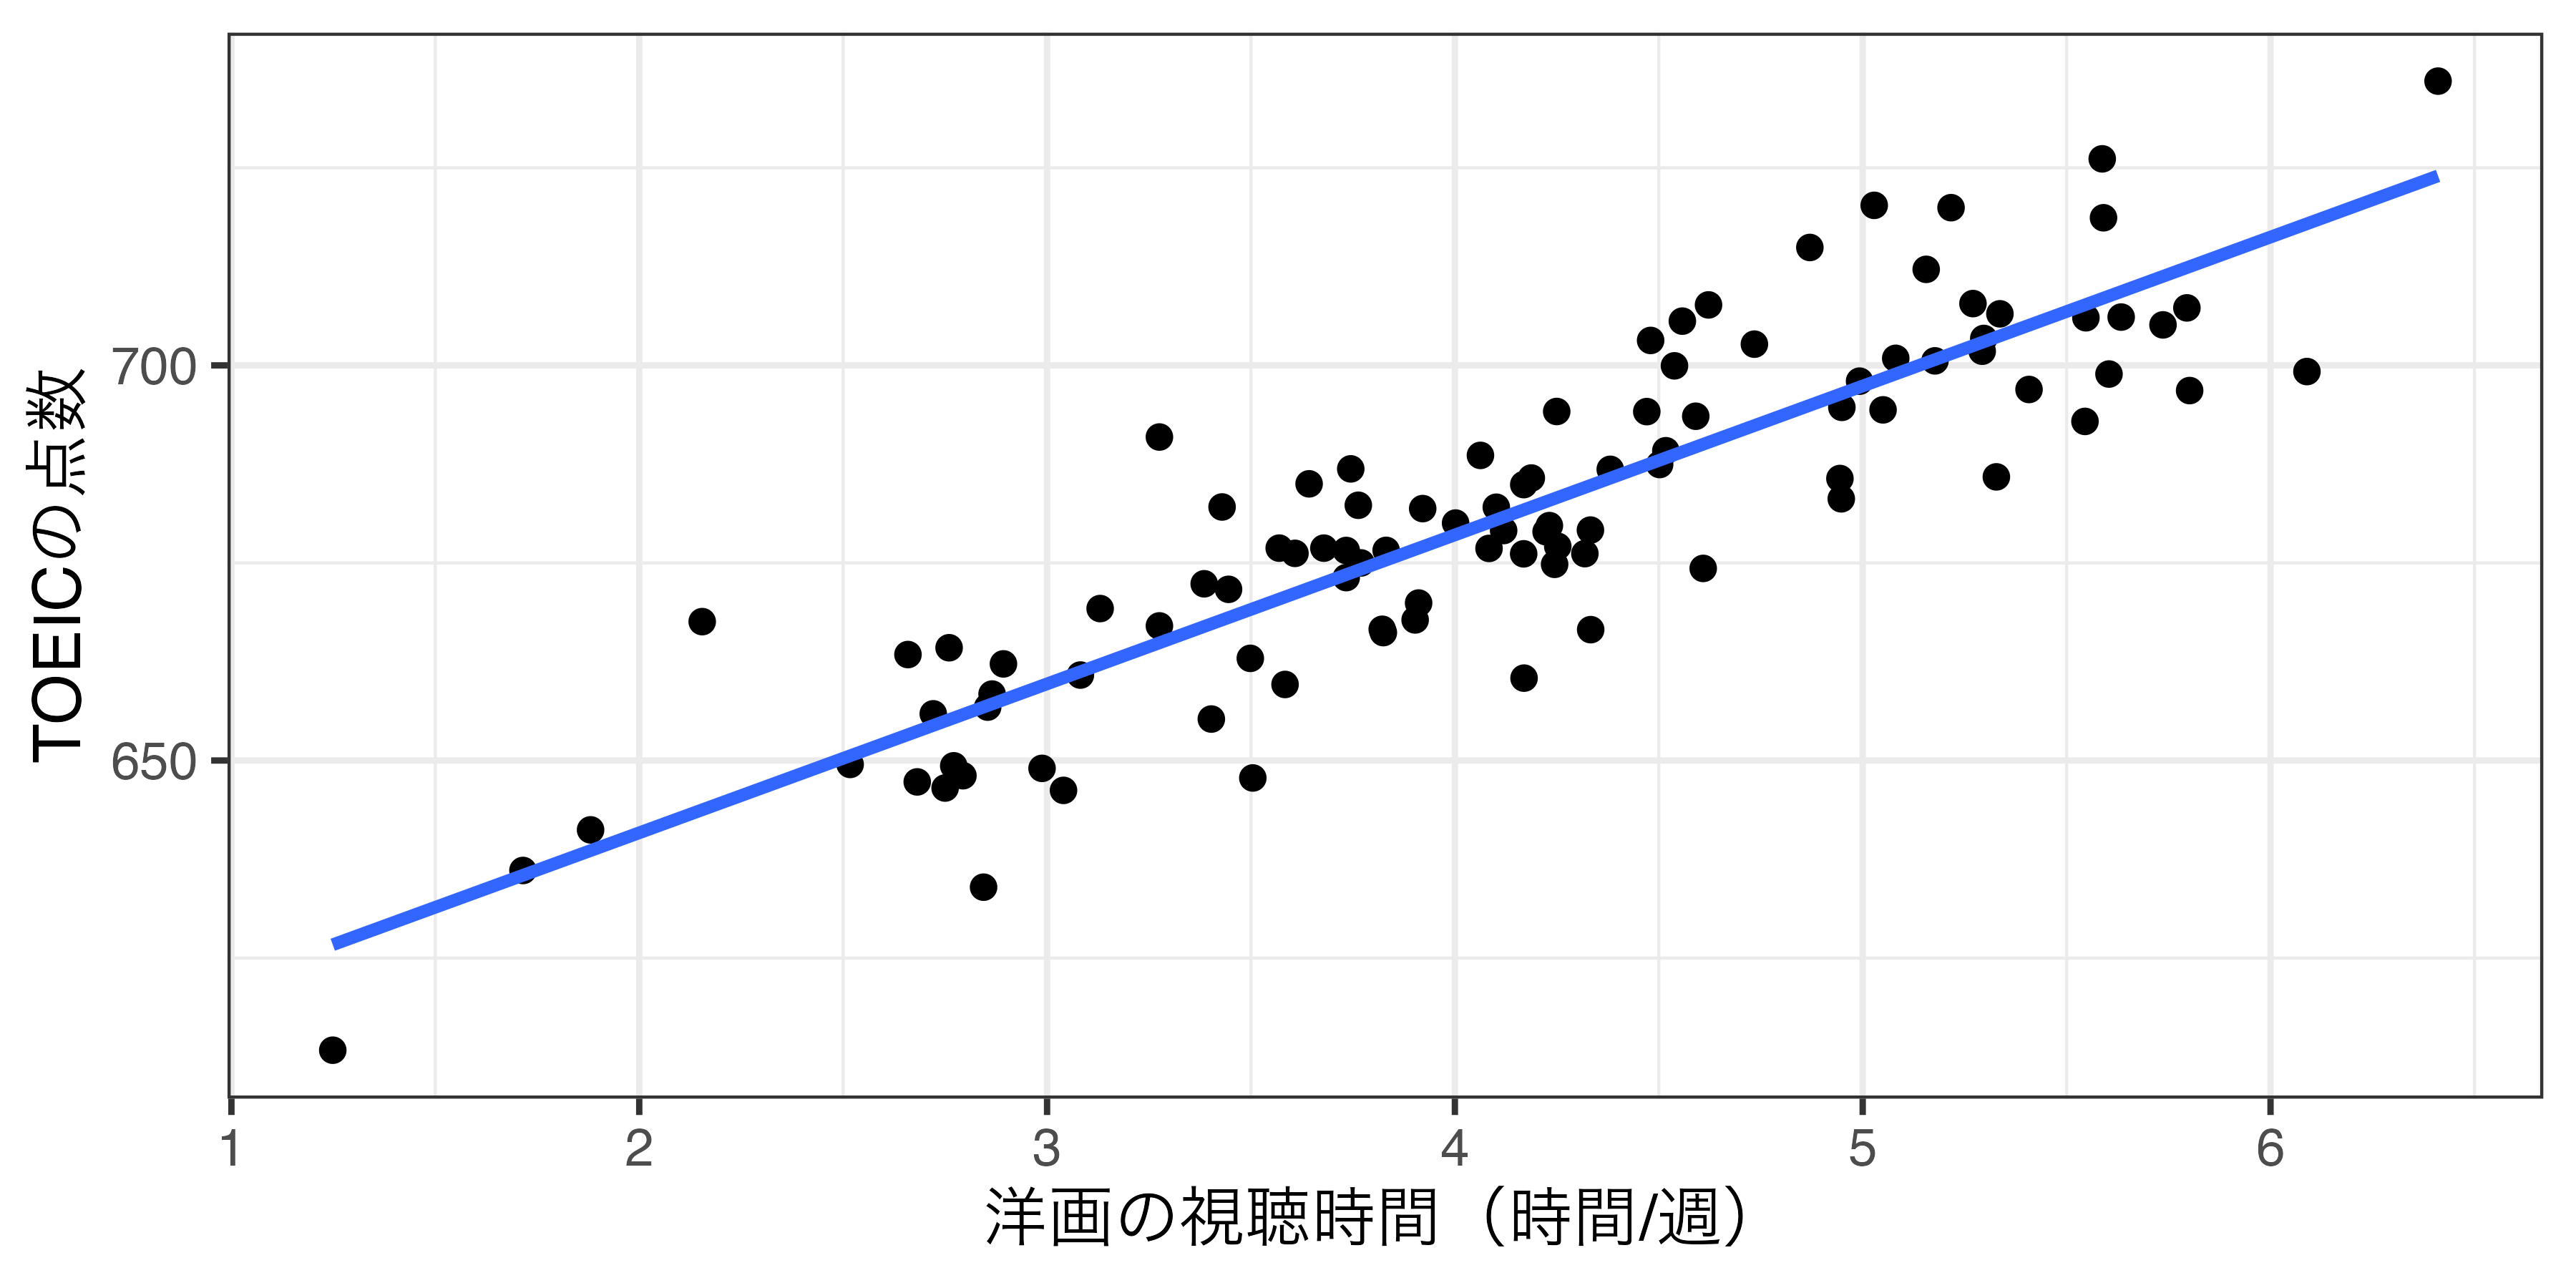
例:洋画視聴とTOEICの点数

「洋画視聴をすればTOEICの点数が伸びる」と言えるか?

モデルの特定化

モデルの特定化 (model specification)

変数同士の関係を数式で表すこと

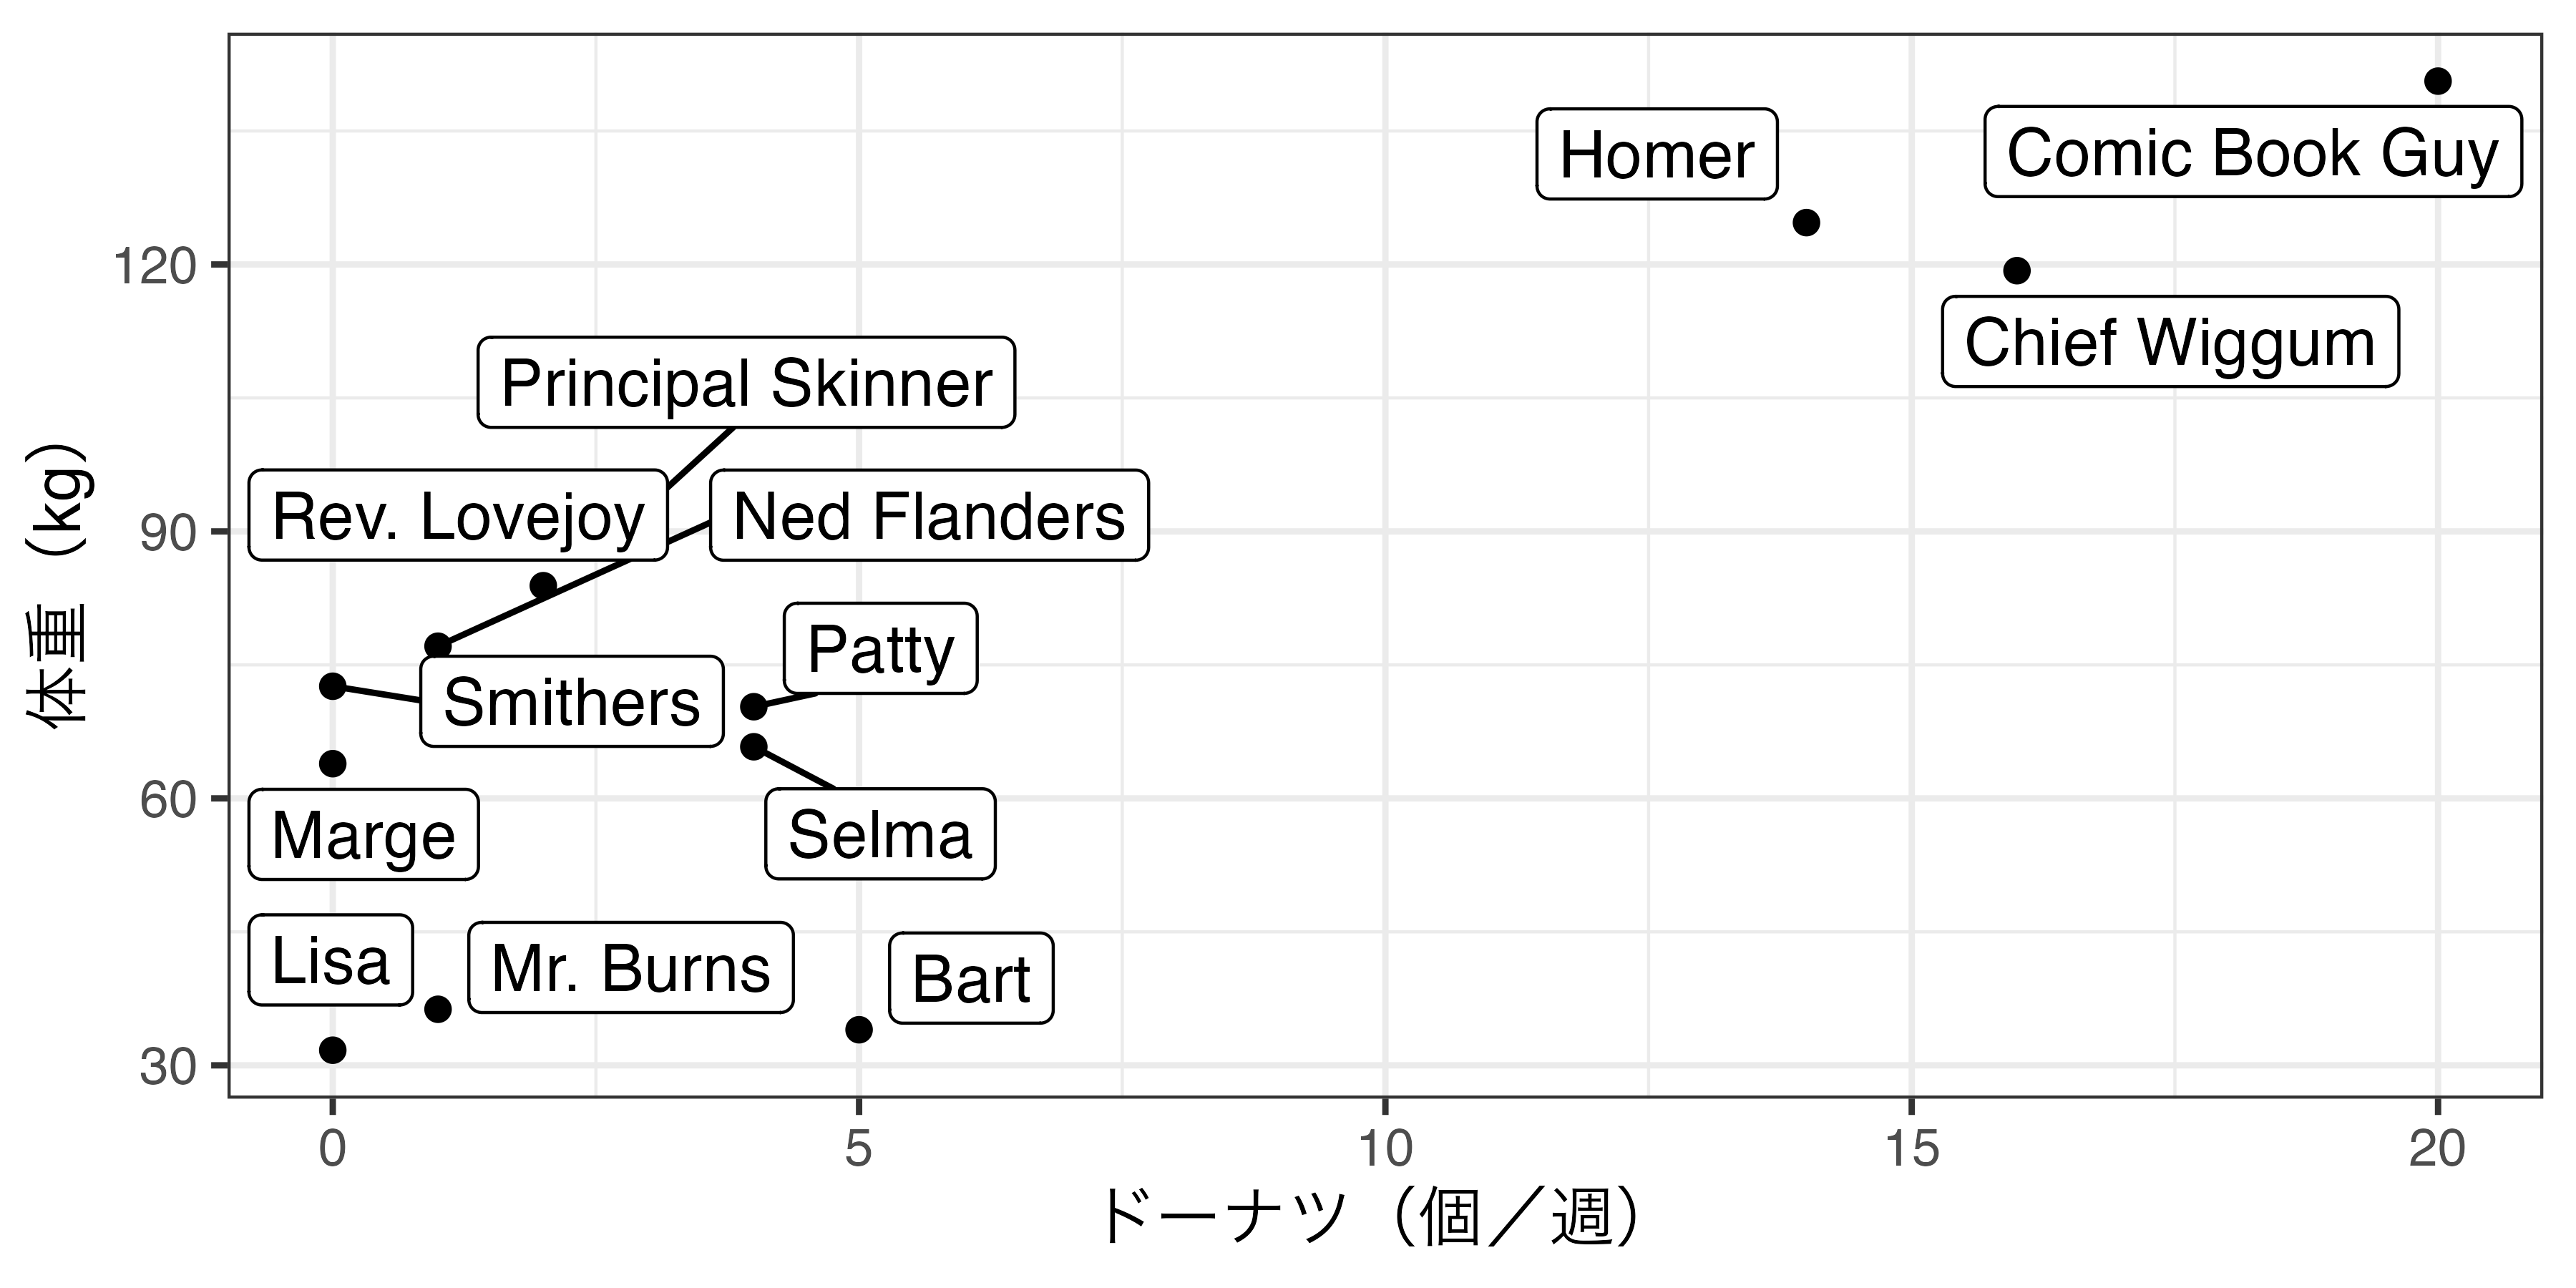
例:ドーナツを食べると体重は増えるか?

  • 原因:食べたドーナツ量→結果:体重
  • アメリカ人からランダムに選ばれた13人のデータを分析して検証
    • 名前(name):各個人の名前
    • ドーナツ(donuts):1週間で食べるドーナツ(個数)
    • 体重(weight):体重(kg)

データと散布図

id name donuts weight
1 Homer 14 124.7
2 Marge 0 63.9
3 Lisa 0 31.7
4 Bart 5 34.0
5 Comic Book Guy 20 140.6
6 Mr. Burns 1 36.3
7 Smithers 0 72.6
8 Chief Wiggum 16 119.3
9 Principal Skinner 3 93.0
10 Rev. Lovejoy 2 83.9
11 Ned Flanders 1 77.1
12 Patty 4 70.3
13 Selma 4 65.8

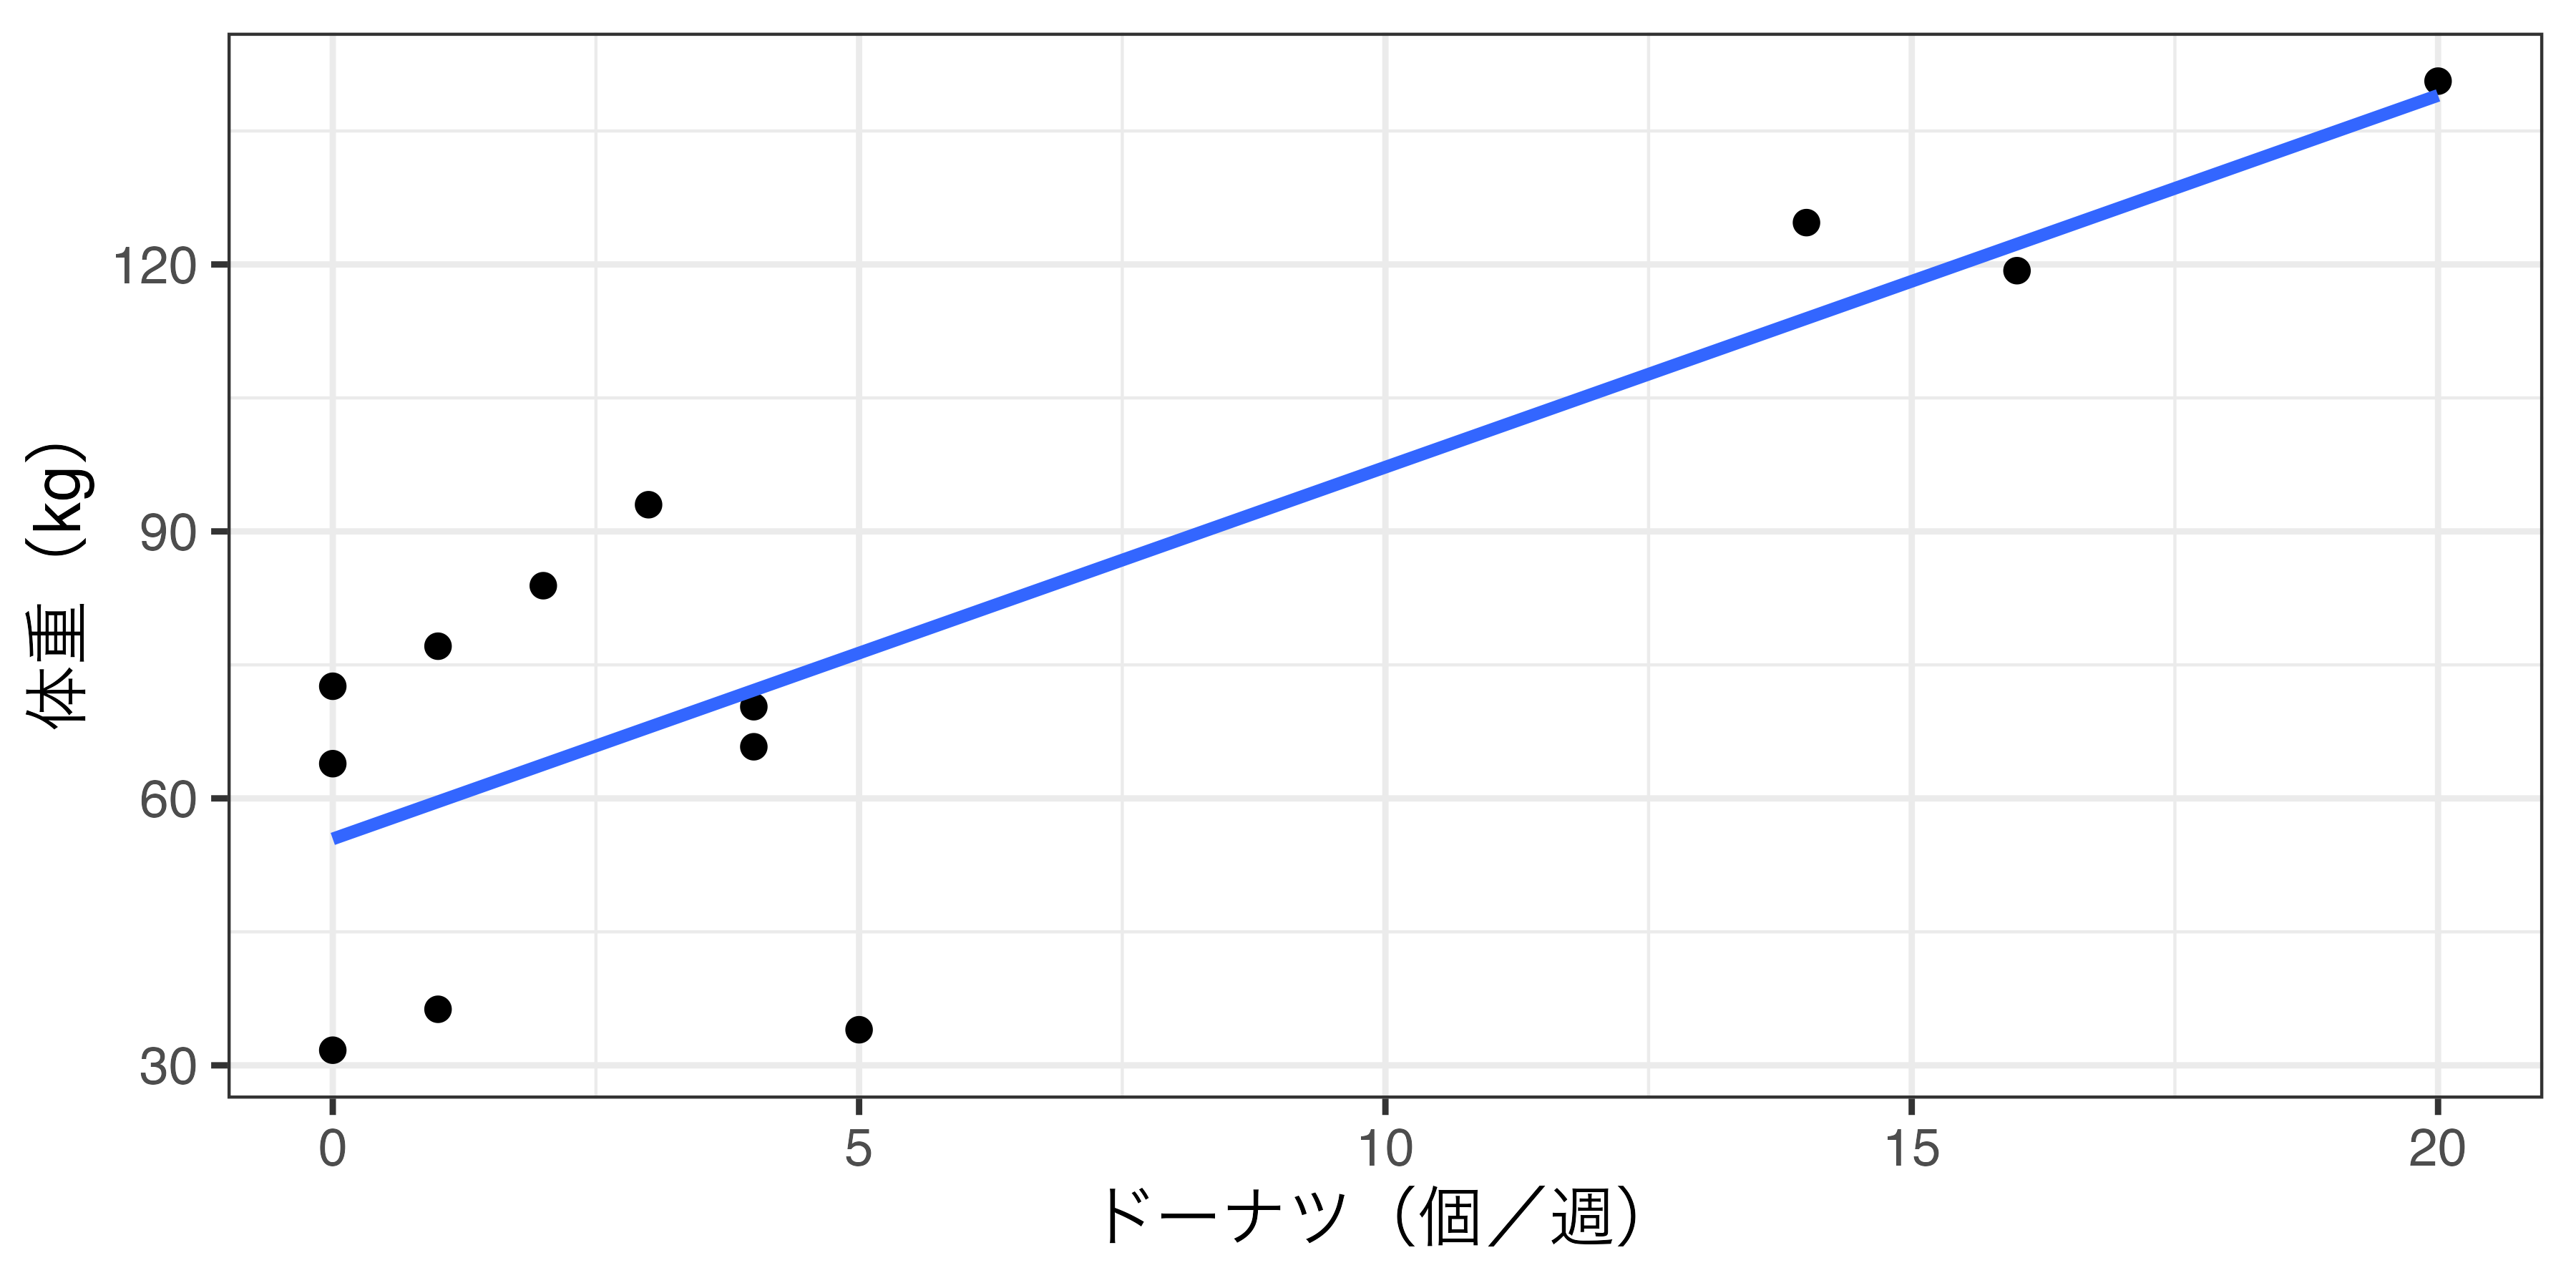
ここで以下のようなモデルを特定化:

\[ 体重_{i} = \beta_{0} + \beta_{1} ドーナツ_{i} + \varepsilon_{i} \]

  • \(体重_{i}\):\(i\)番目の人の体重(kg)
  • \(ドーナツ_{i}\):i番目の人が1週間で食べるドーナツ(個)
  • \(\beta_{1}\)(回帰係数):ドーナツを1個食べるごとに体重が何kg増えるか
  • \(\beta_{0}\)(定数):ドーナツを食べないときの体重
  • \(\varepsilon_{i}\)(誤差項):ドーナツでは説明しきれない体重の変動
    • 例:性別、身長、運動習慣…

→モデル\(体重_{i} = \beta_{0} + \beta_{1} ドーナツ_{i} + \varepsilon_{i}\)は直線を表す数式

一般的な基本モデル

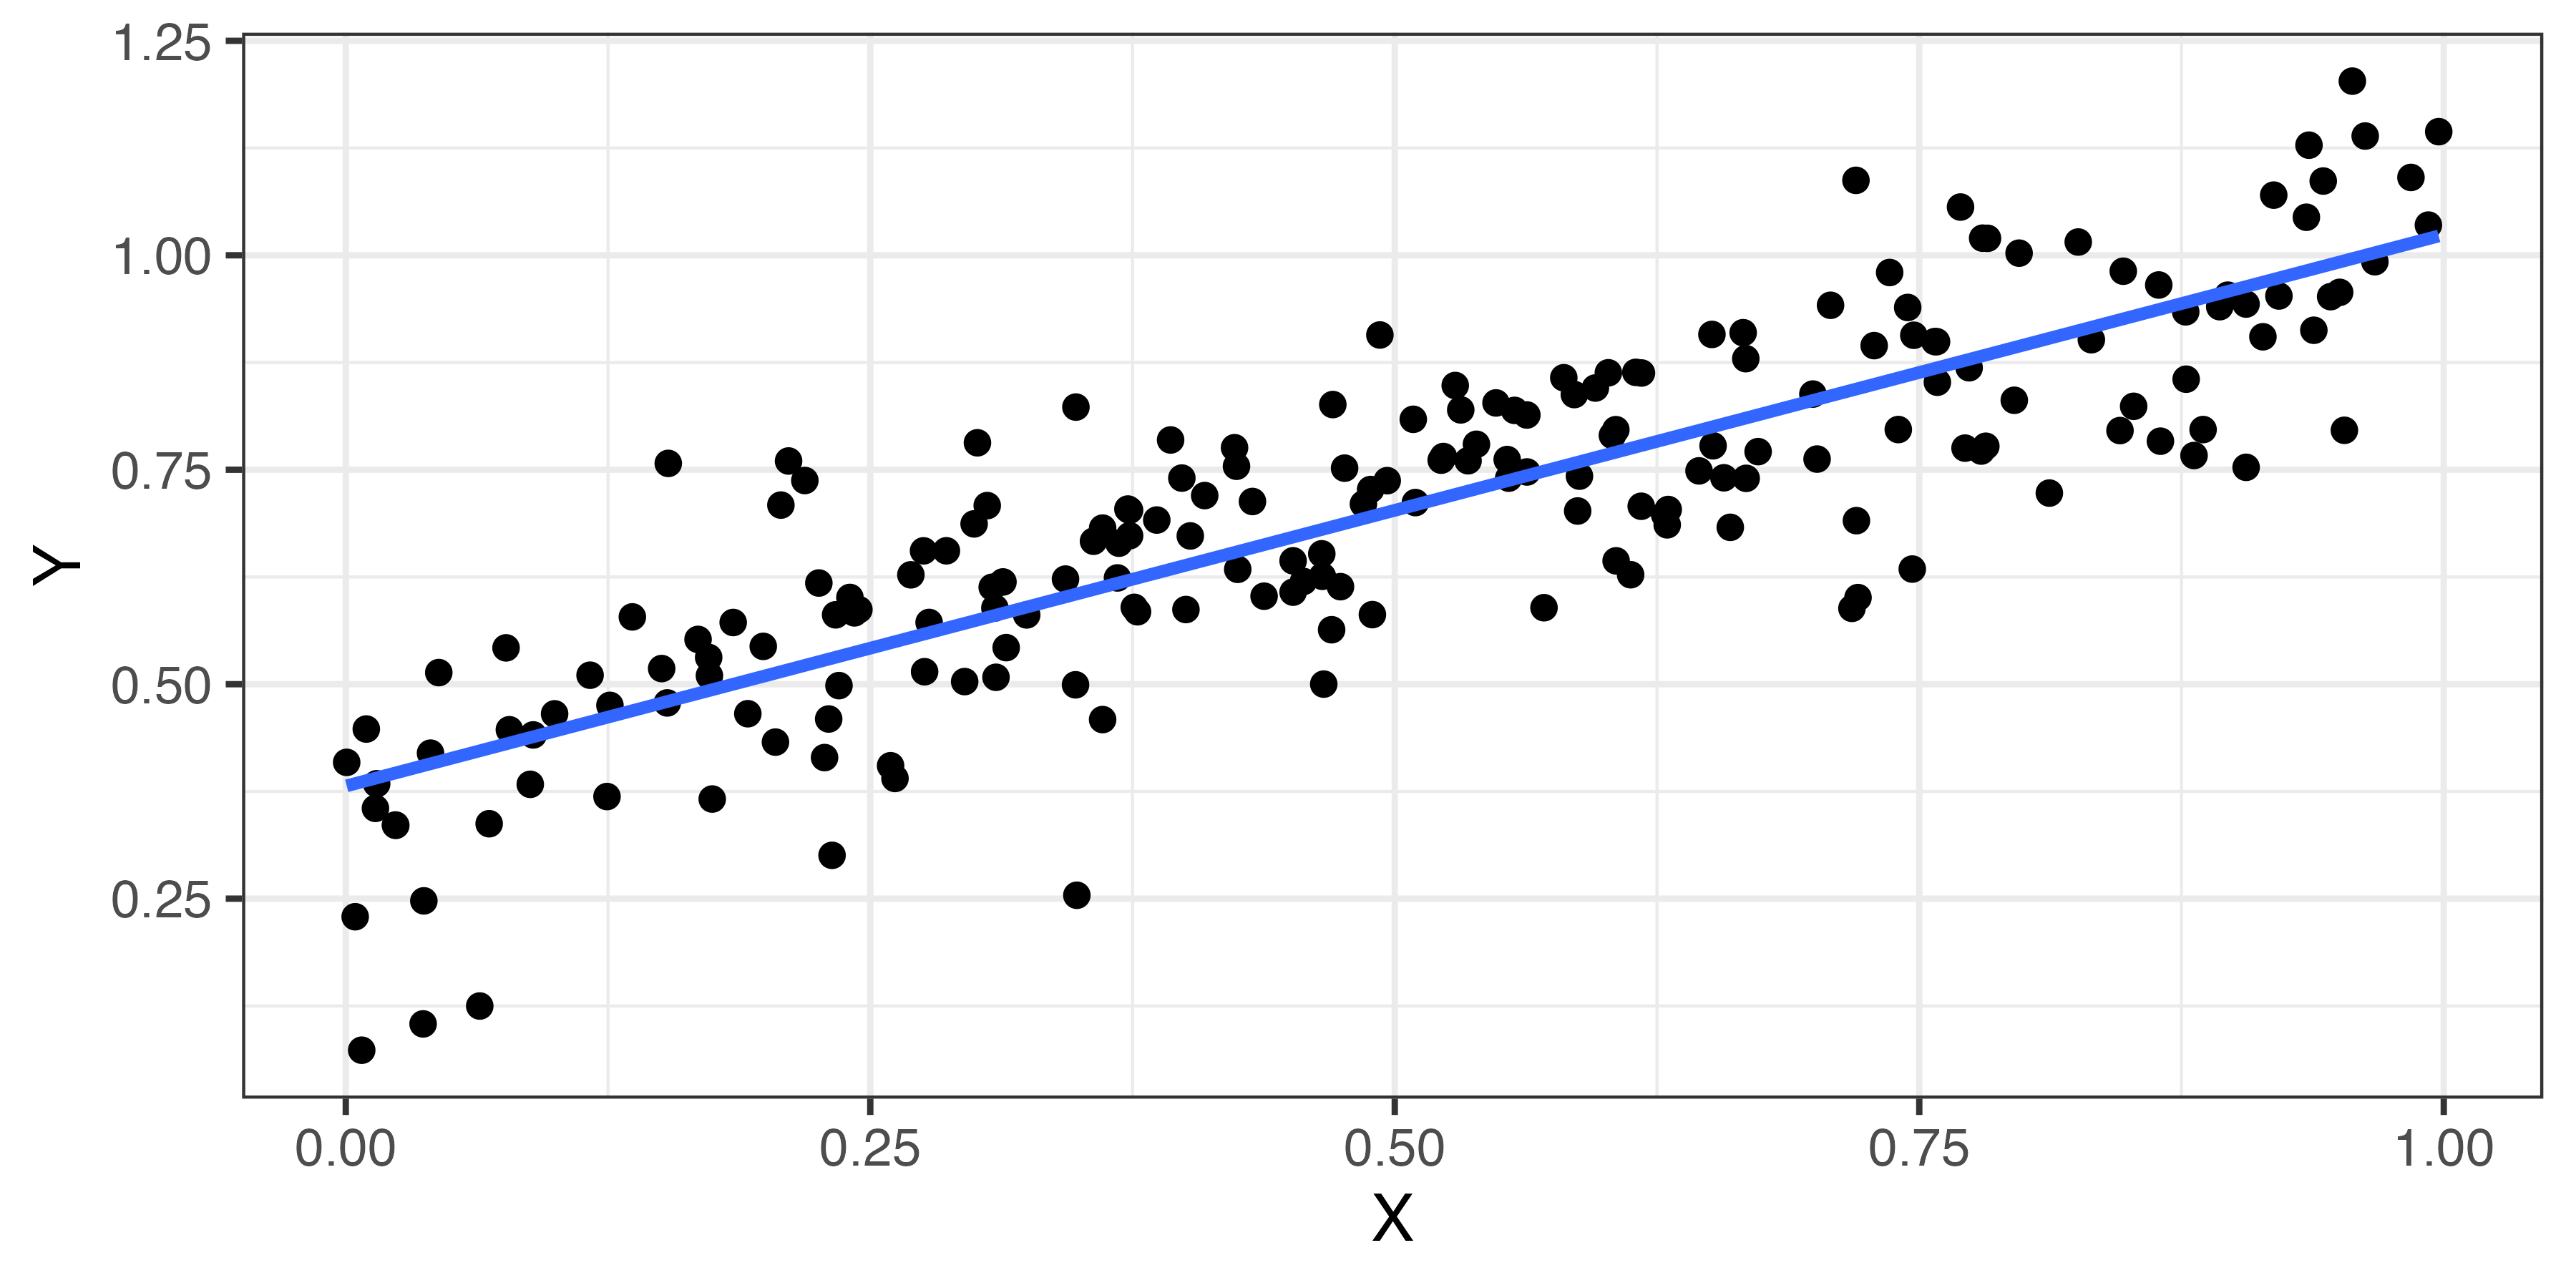
\[ Y_{i} = \beta_{0} + \beta_{1} X_{i} + \varepsilon_{i} \]

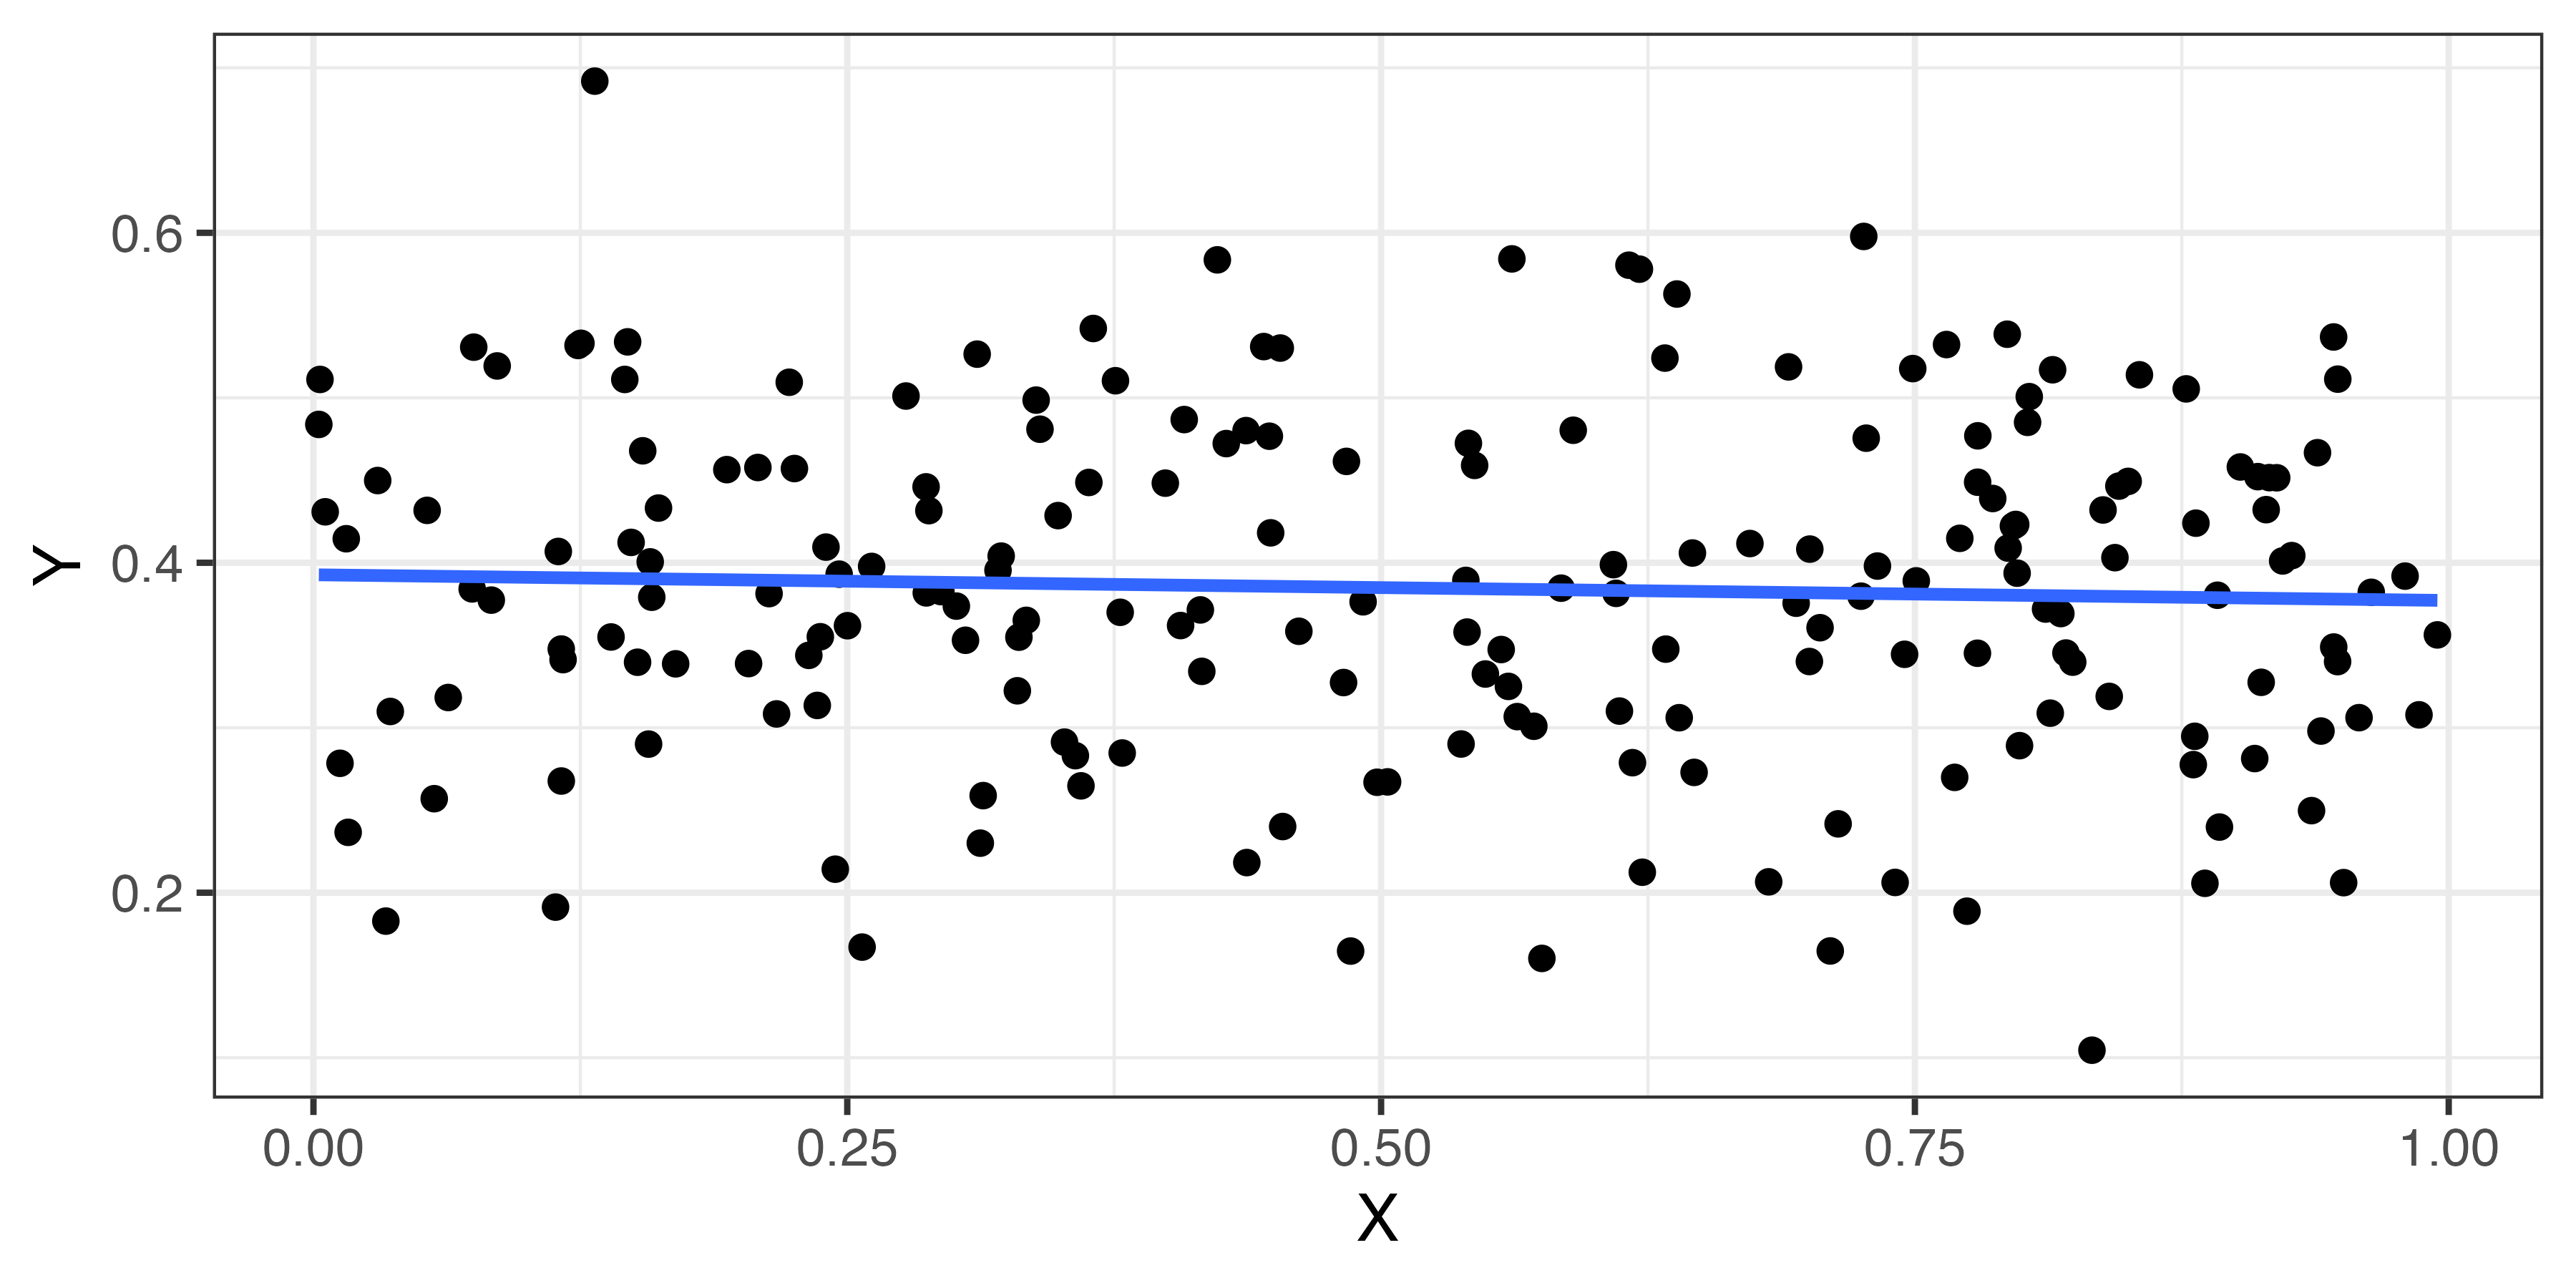
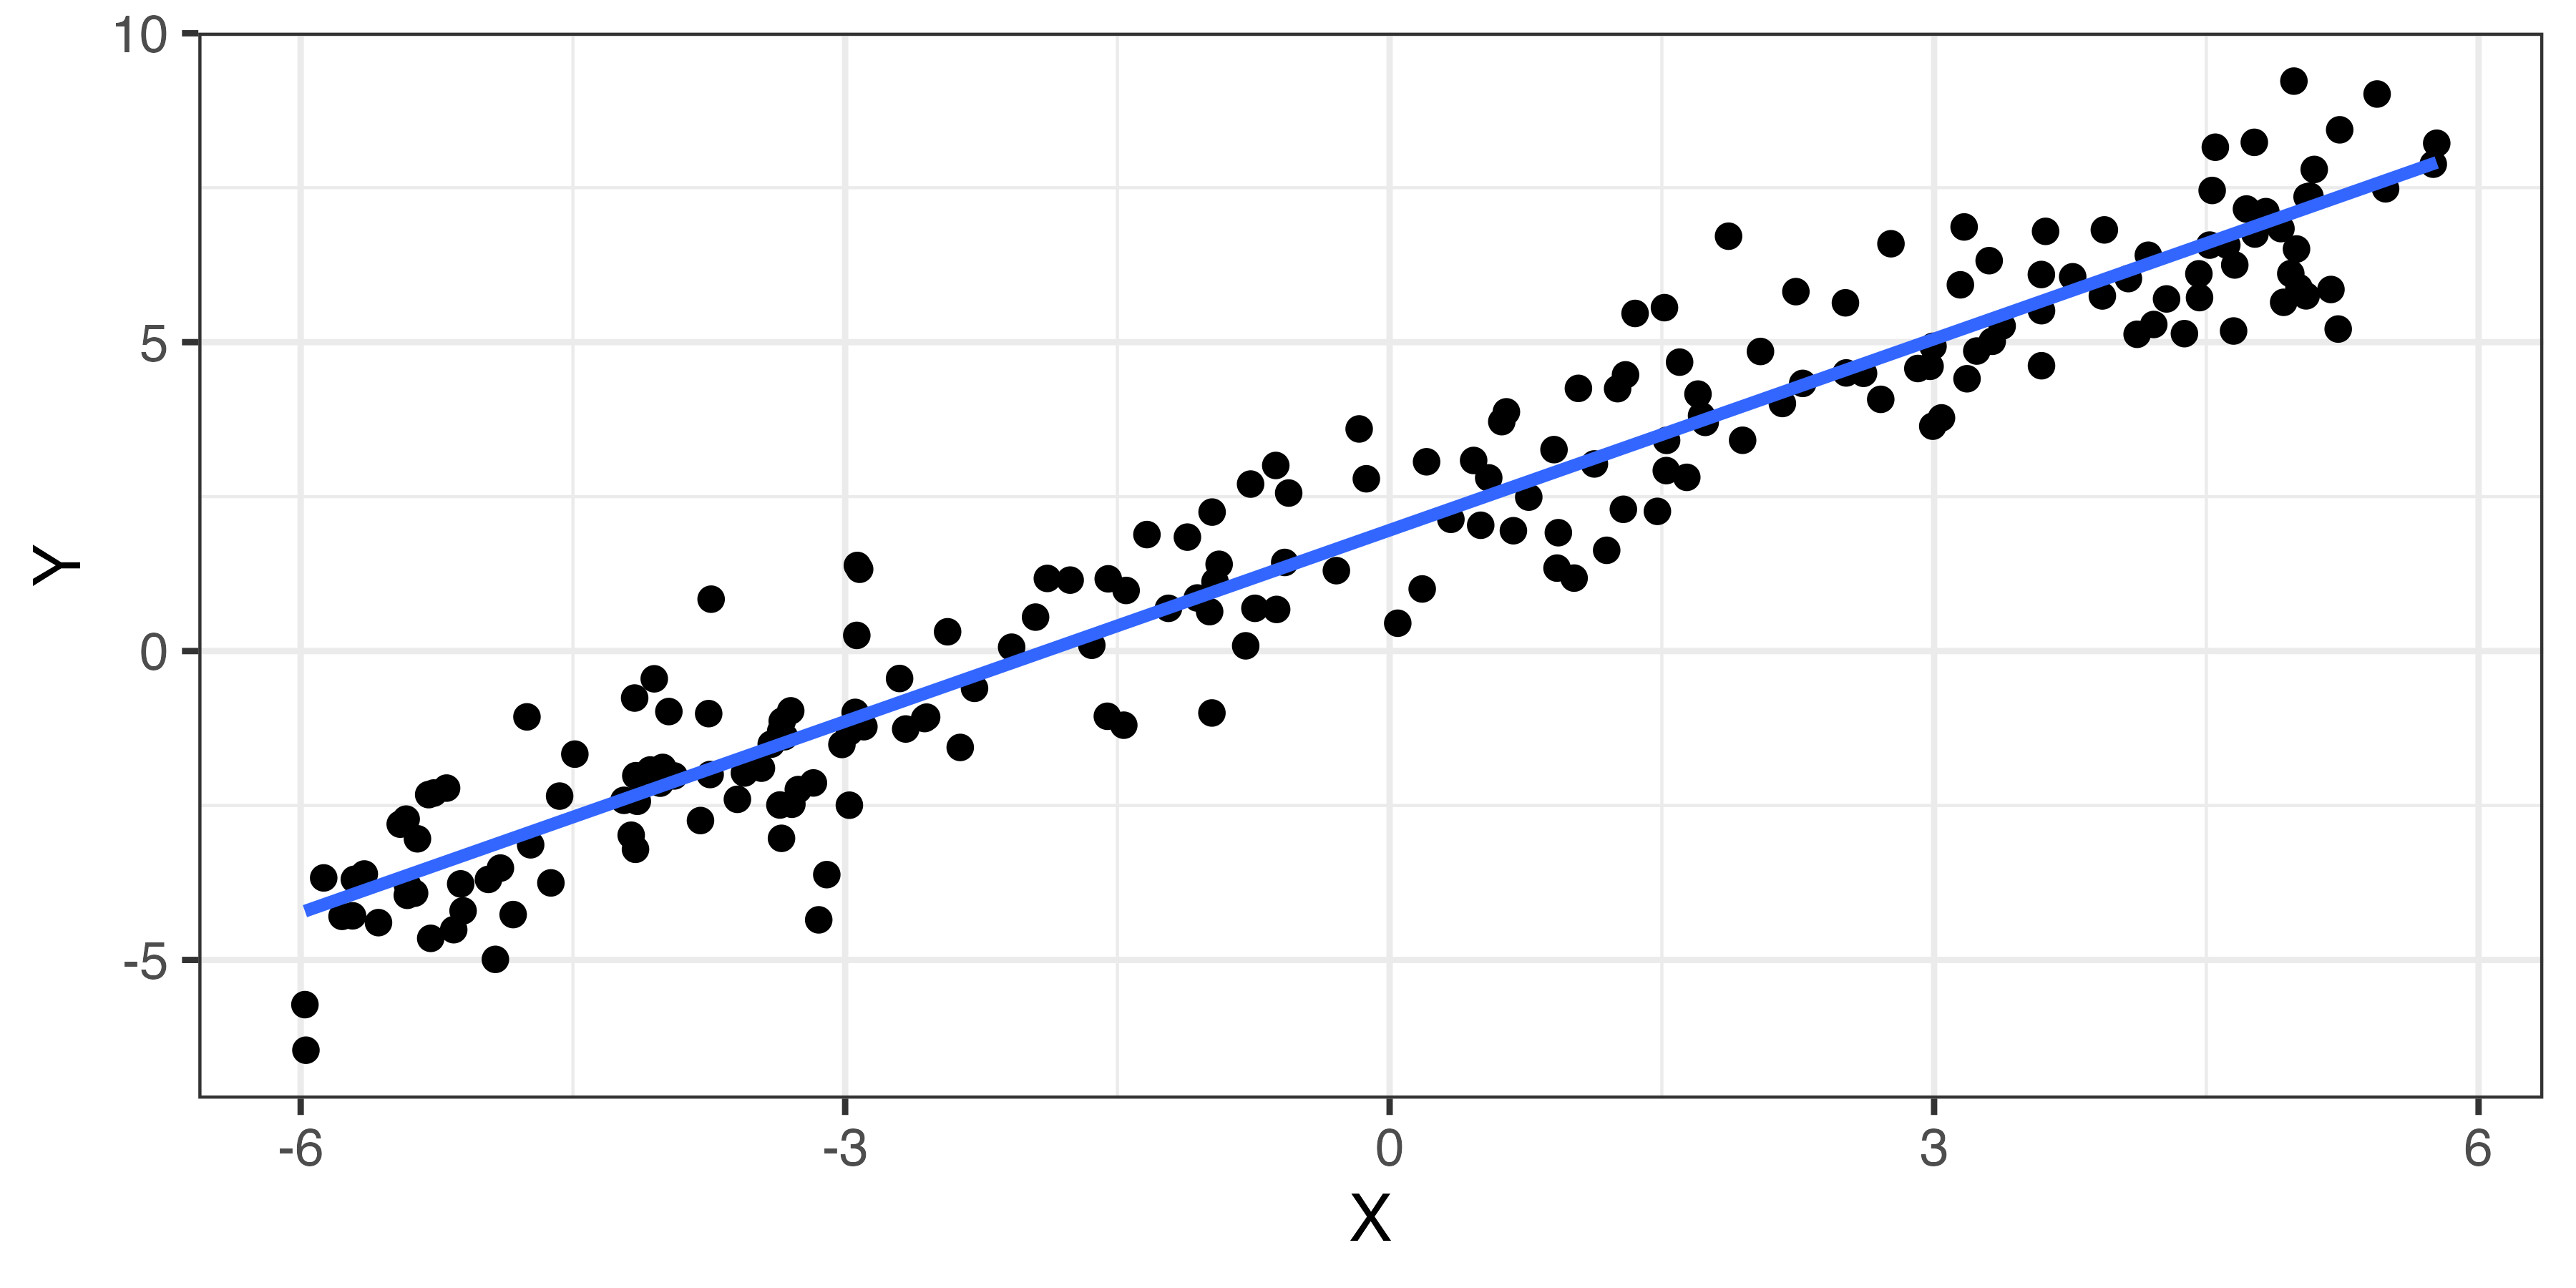
  • \(\beta_{1}\)(回帰係数):\(X\)(独立変数)が1増えた時に\(Y\)(従属変数)がどれだけ増えるか
    • 散布図上では直線の傾き
  • \(\beta_{0}\)(定数):\(X\)が0のときの\(Y\)の値
    • 散布図上では直線の切片
      • Y軸との交点のY座標
    • これ自体は重要でない
  • \(\varepsilon_{i}\)(誤差項):\(X\)では説明しきれない\(Y\)の変動
    • データにない→観測不能
    • 散布図上では直線と各点のずれ

クイズ

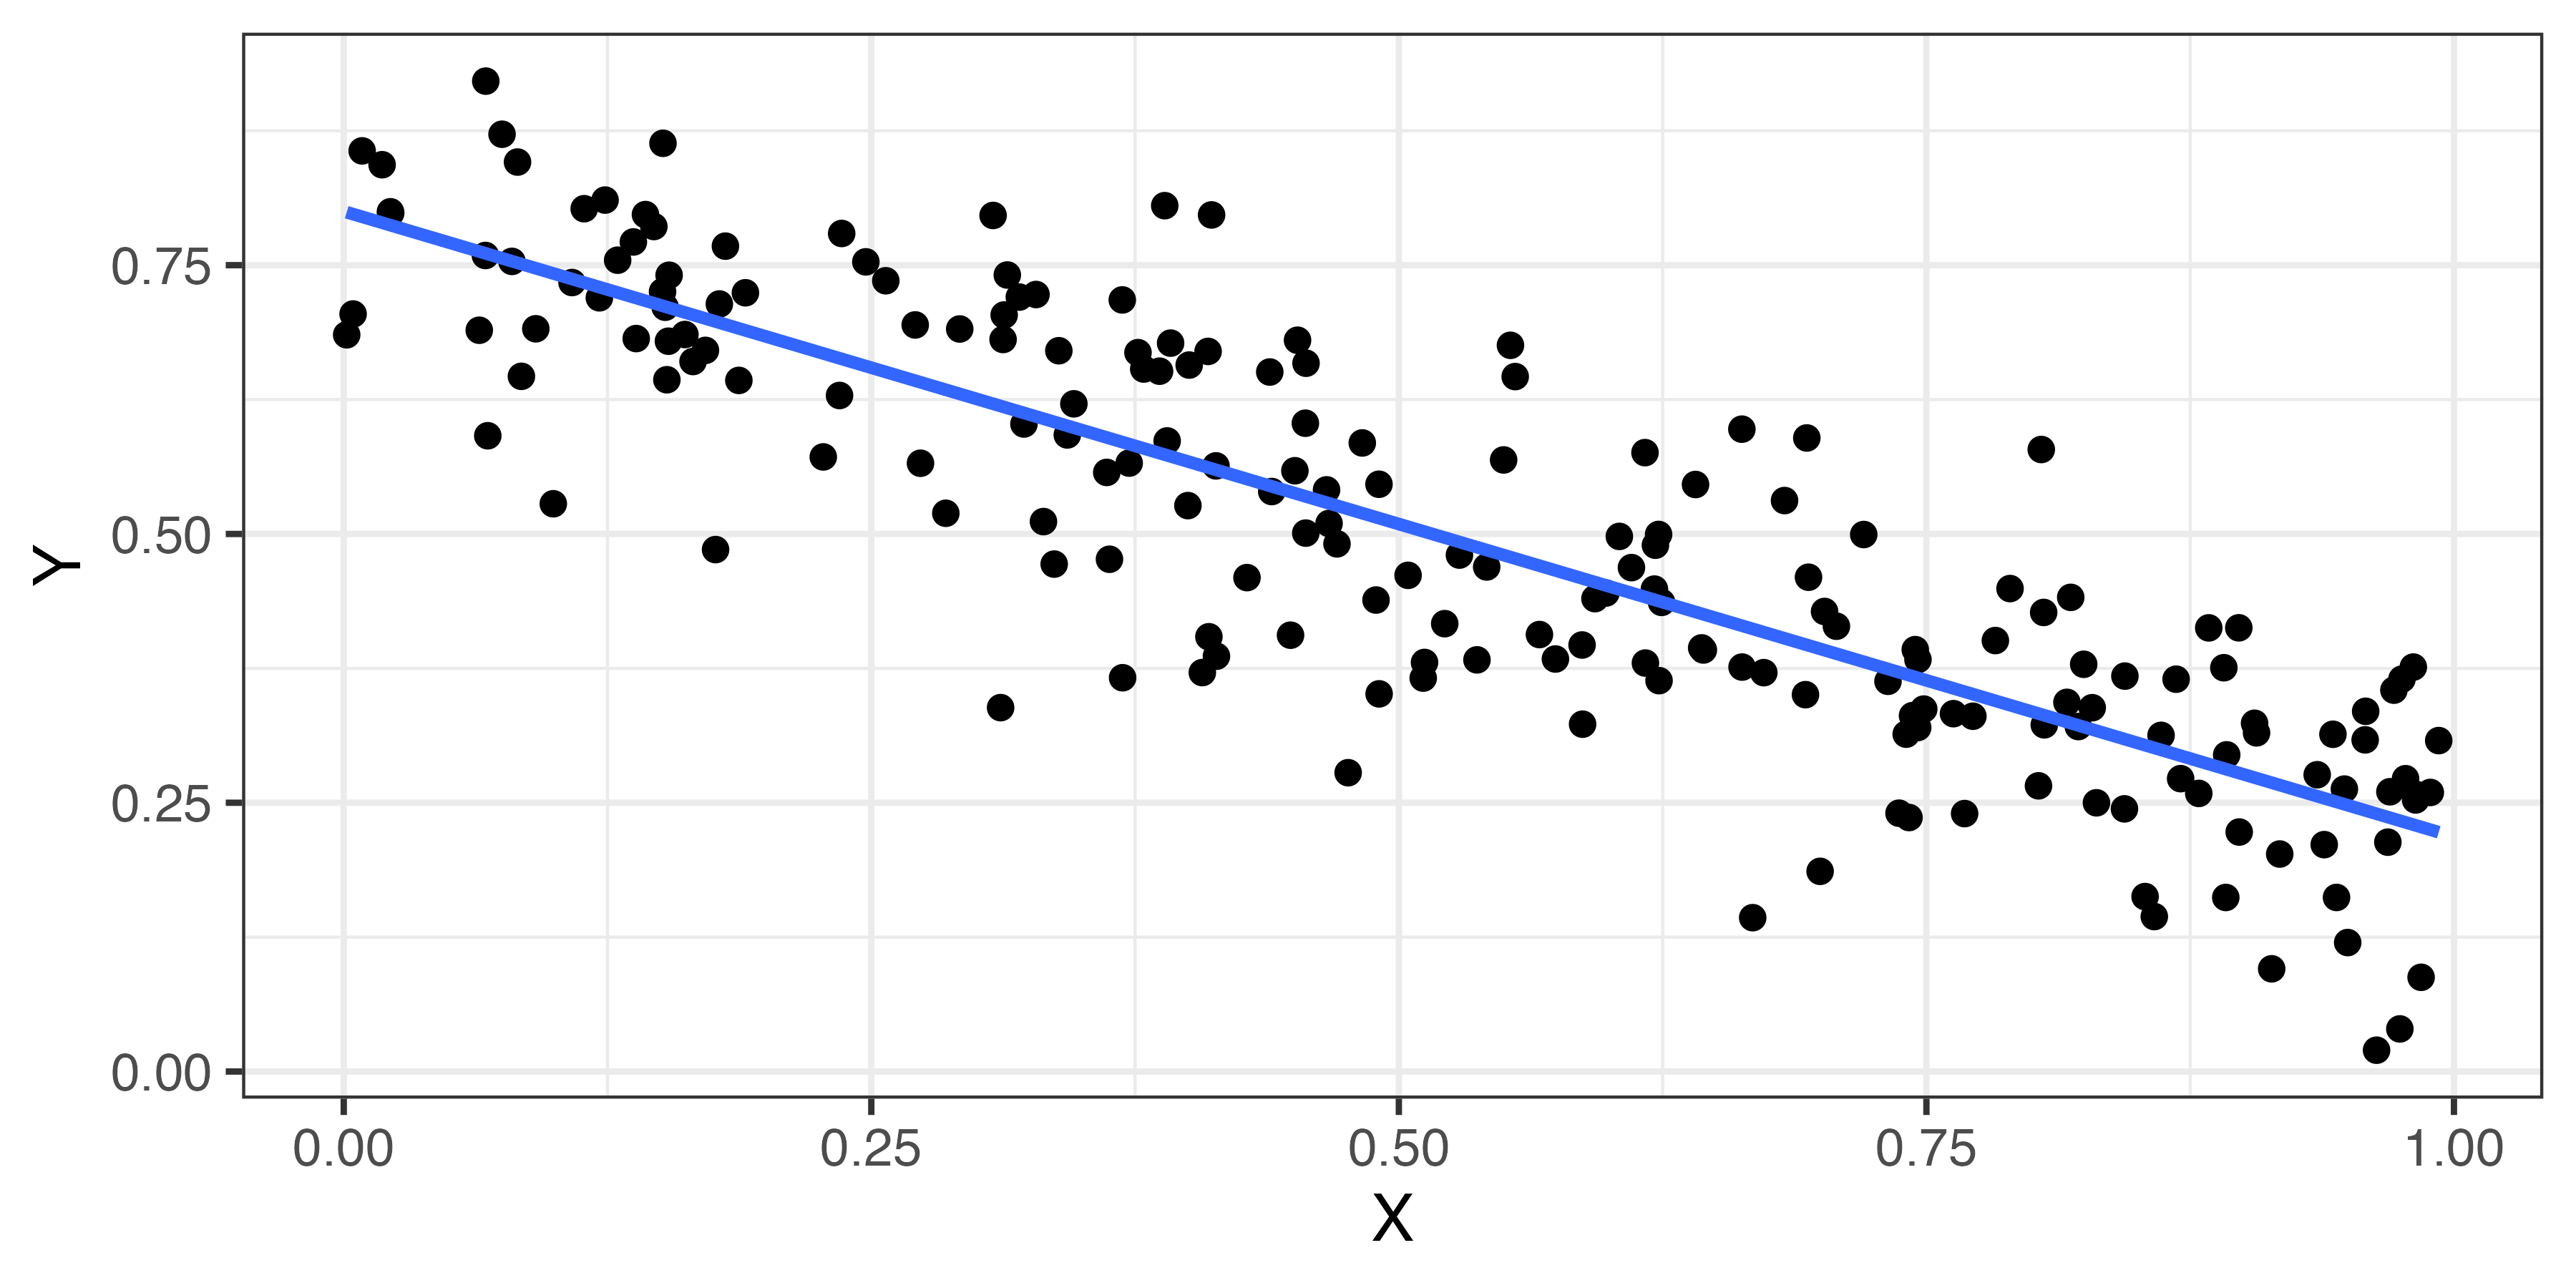
以下4つのグラフを見て、\(\beta_{0}\)と\(\beta_{1}\)とがそれぞれ0より大きいか、等しいか、小さいかを判断してください。
ランダム性と内生性

因果推論の課題

回帰係数\(\beta_{1}\)を計算できても直ちに因果効果だとは解釈できない。なぜなら…

  1. 標本のランダム性
  2. 内生性

標本のランダム性

データはランダムサンプリング

  • 母集団の一部をランダムに抽出して標本とすること

例:ドーナツと体重

  • \(\beta_{1}=4.13\)→たまたまそうなっただけ?
    • 本当はドーナツを食べても太らないかも(母集団で\(\beta_{1}=0\))
    • 本当はドーナツはもっと太るかも(母集団で例えば\(\beta_{1}=10\))

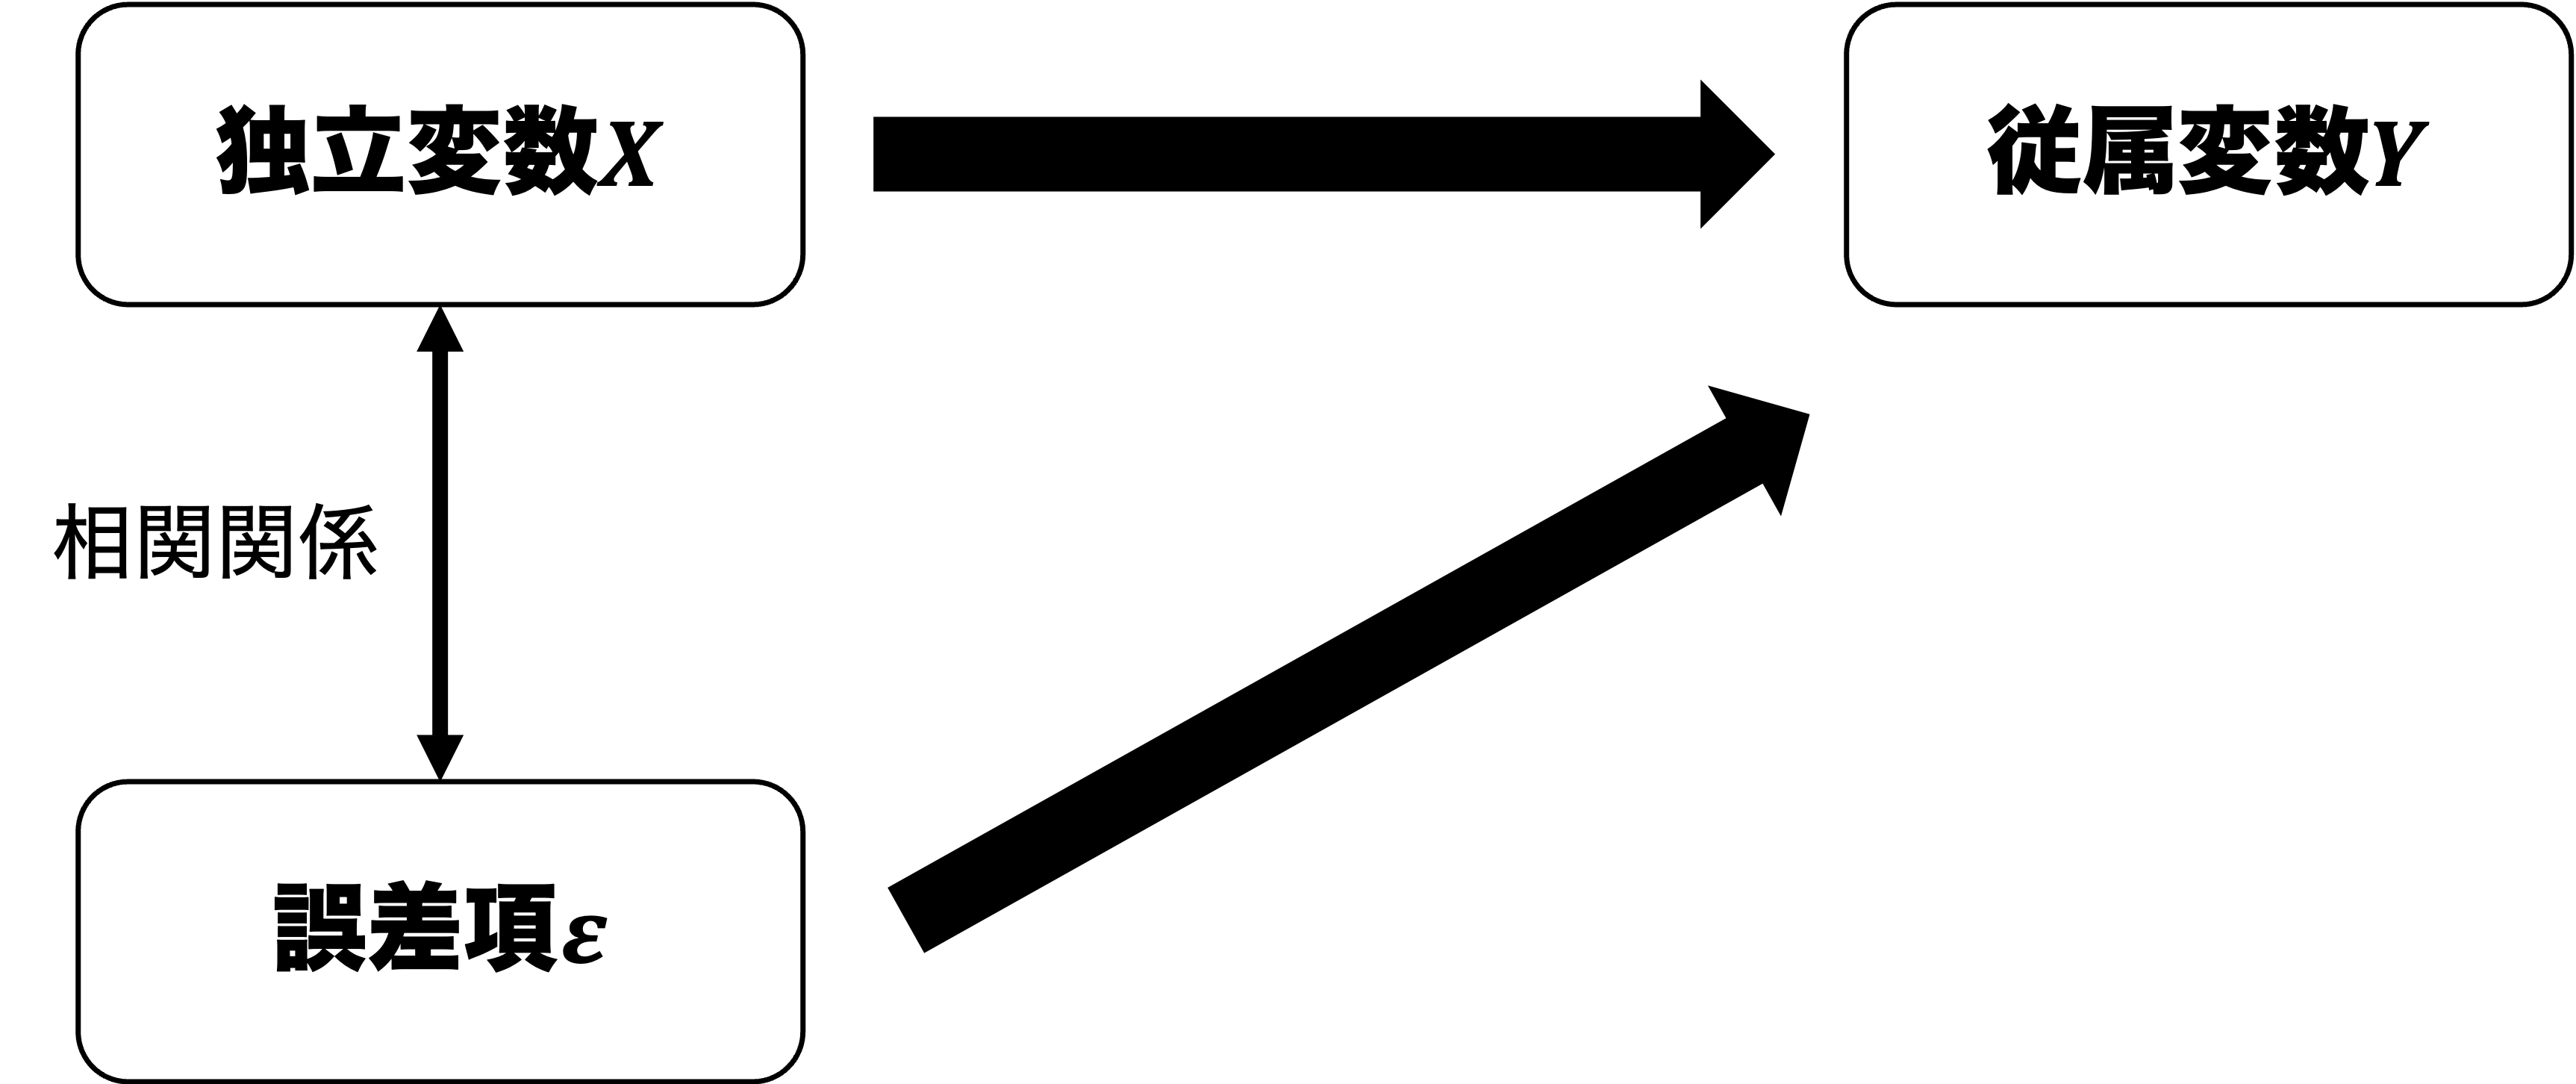
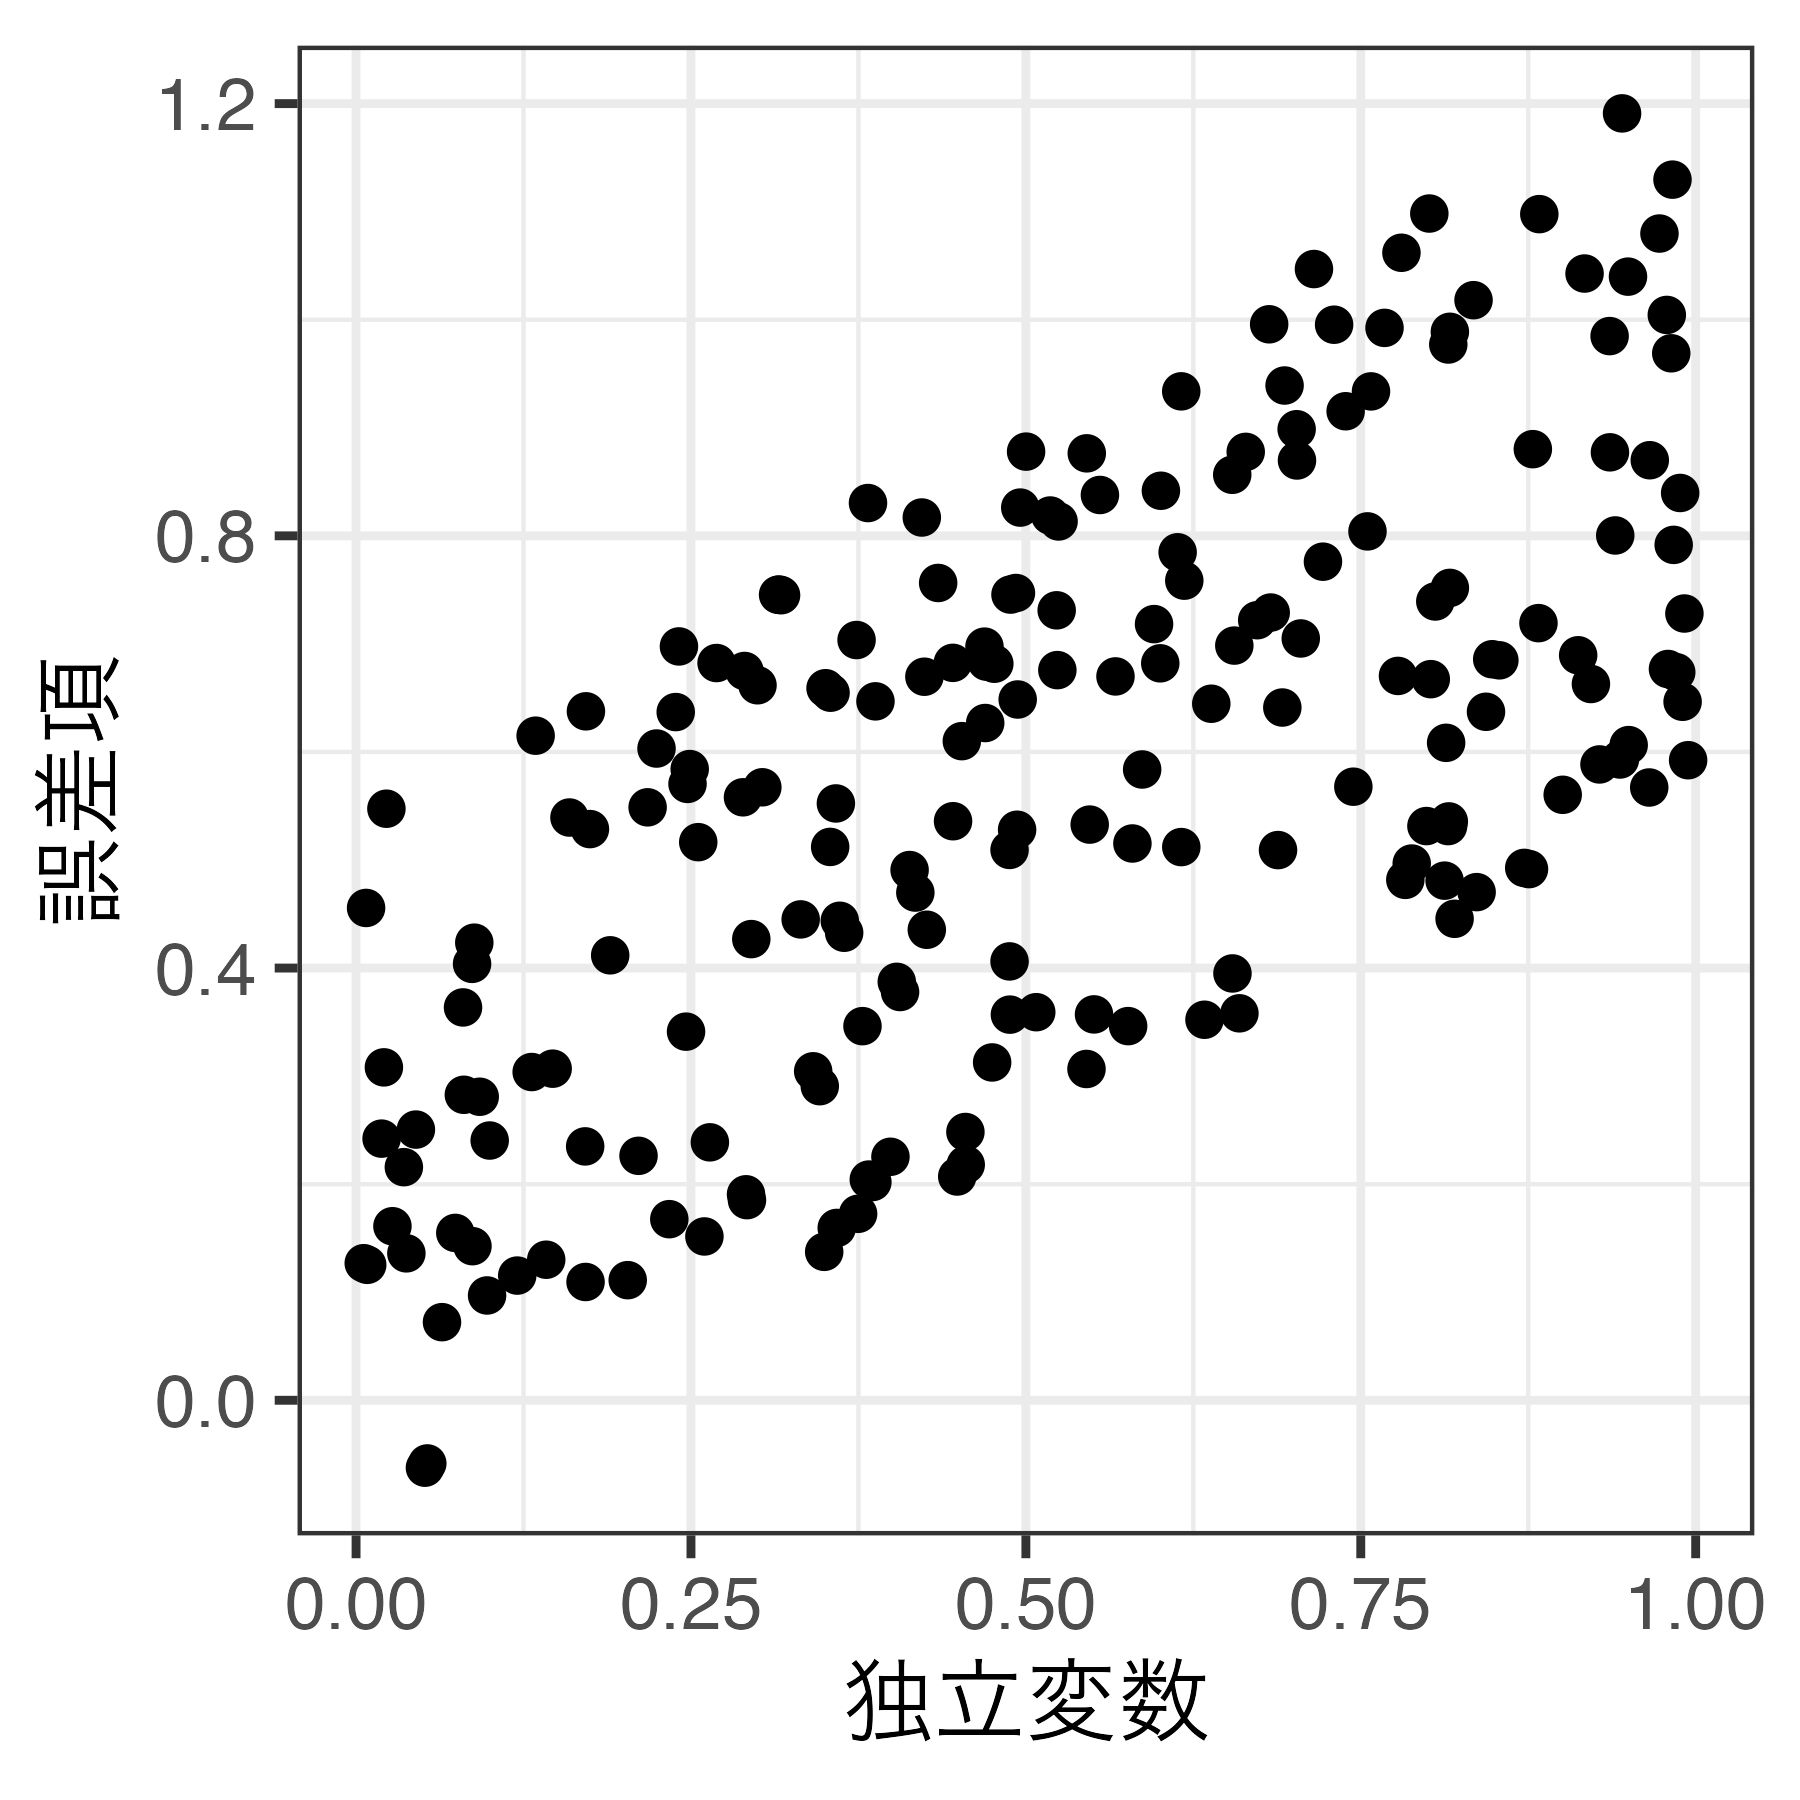
内生性(endogeneity)

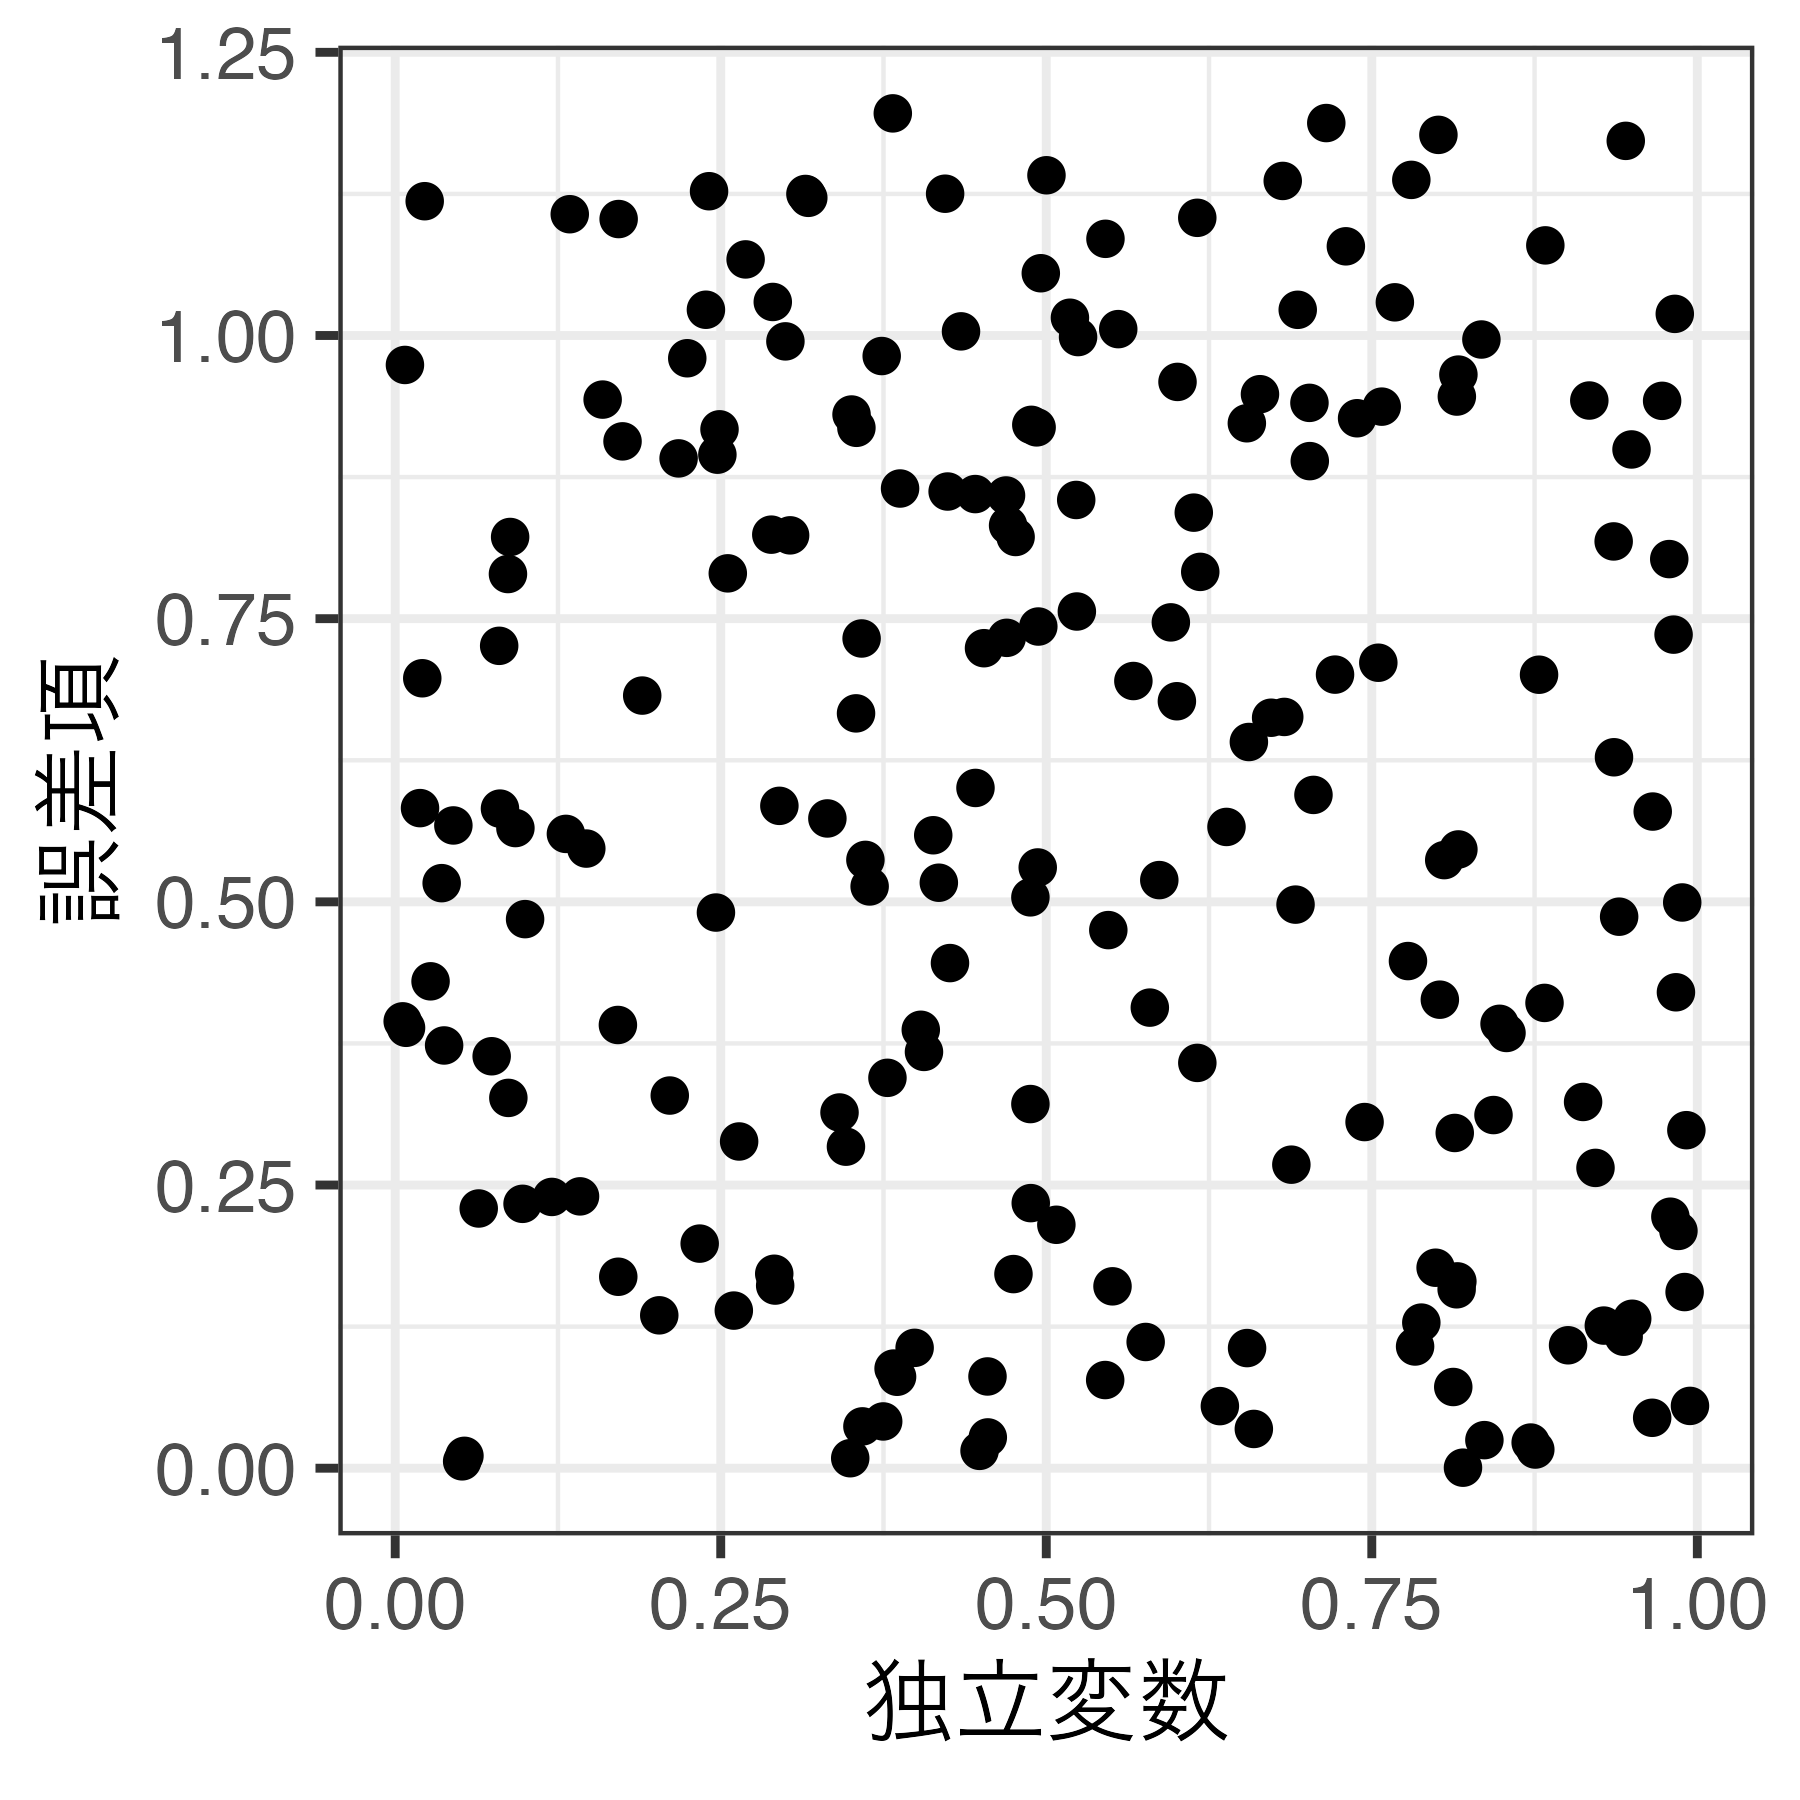
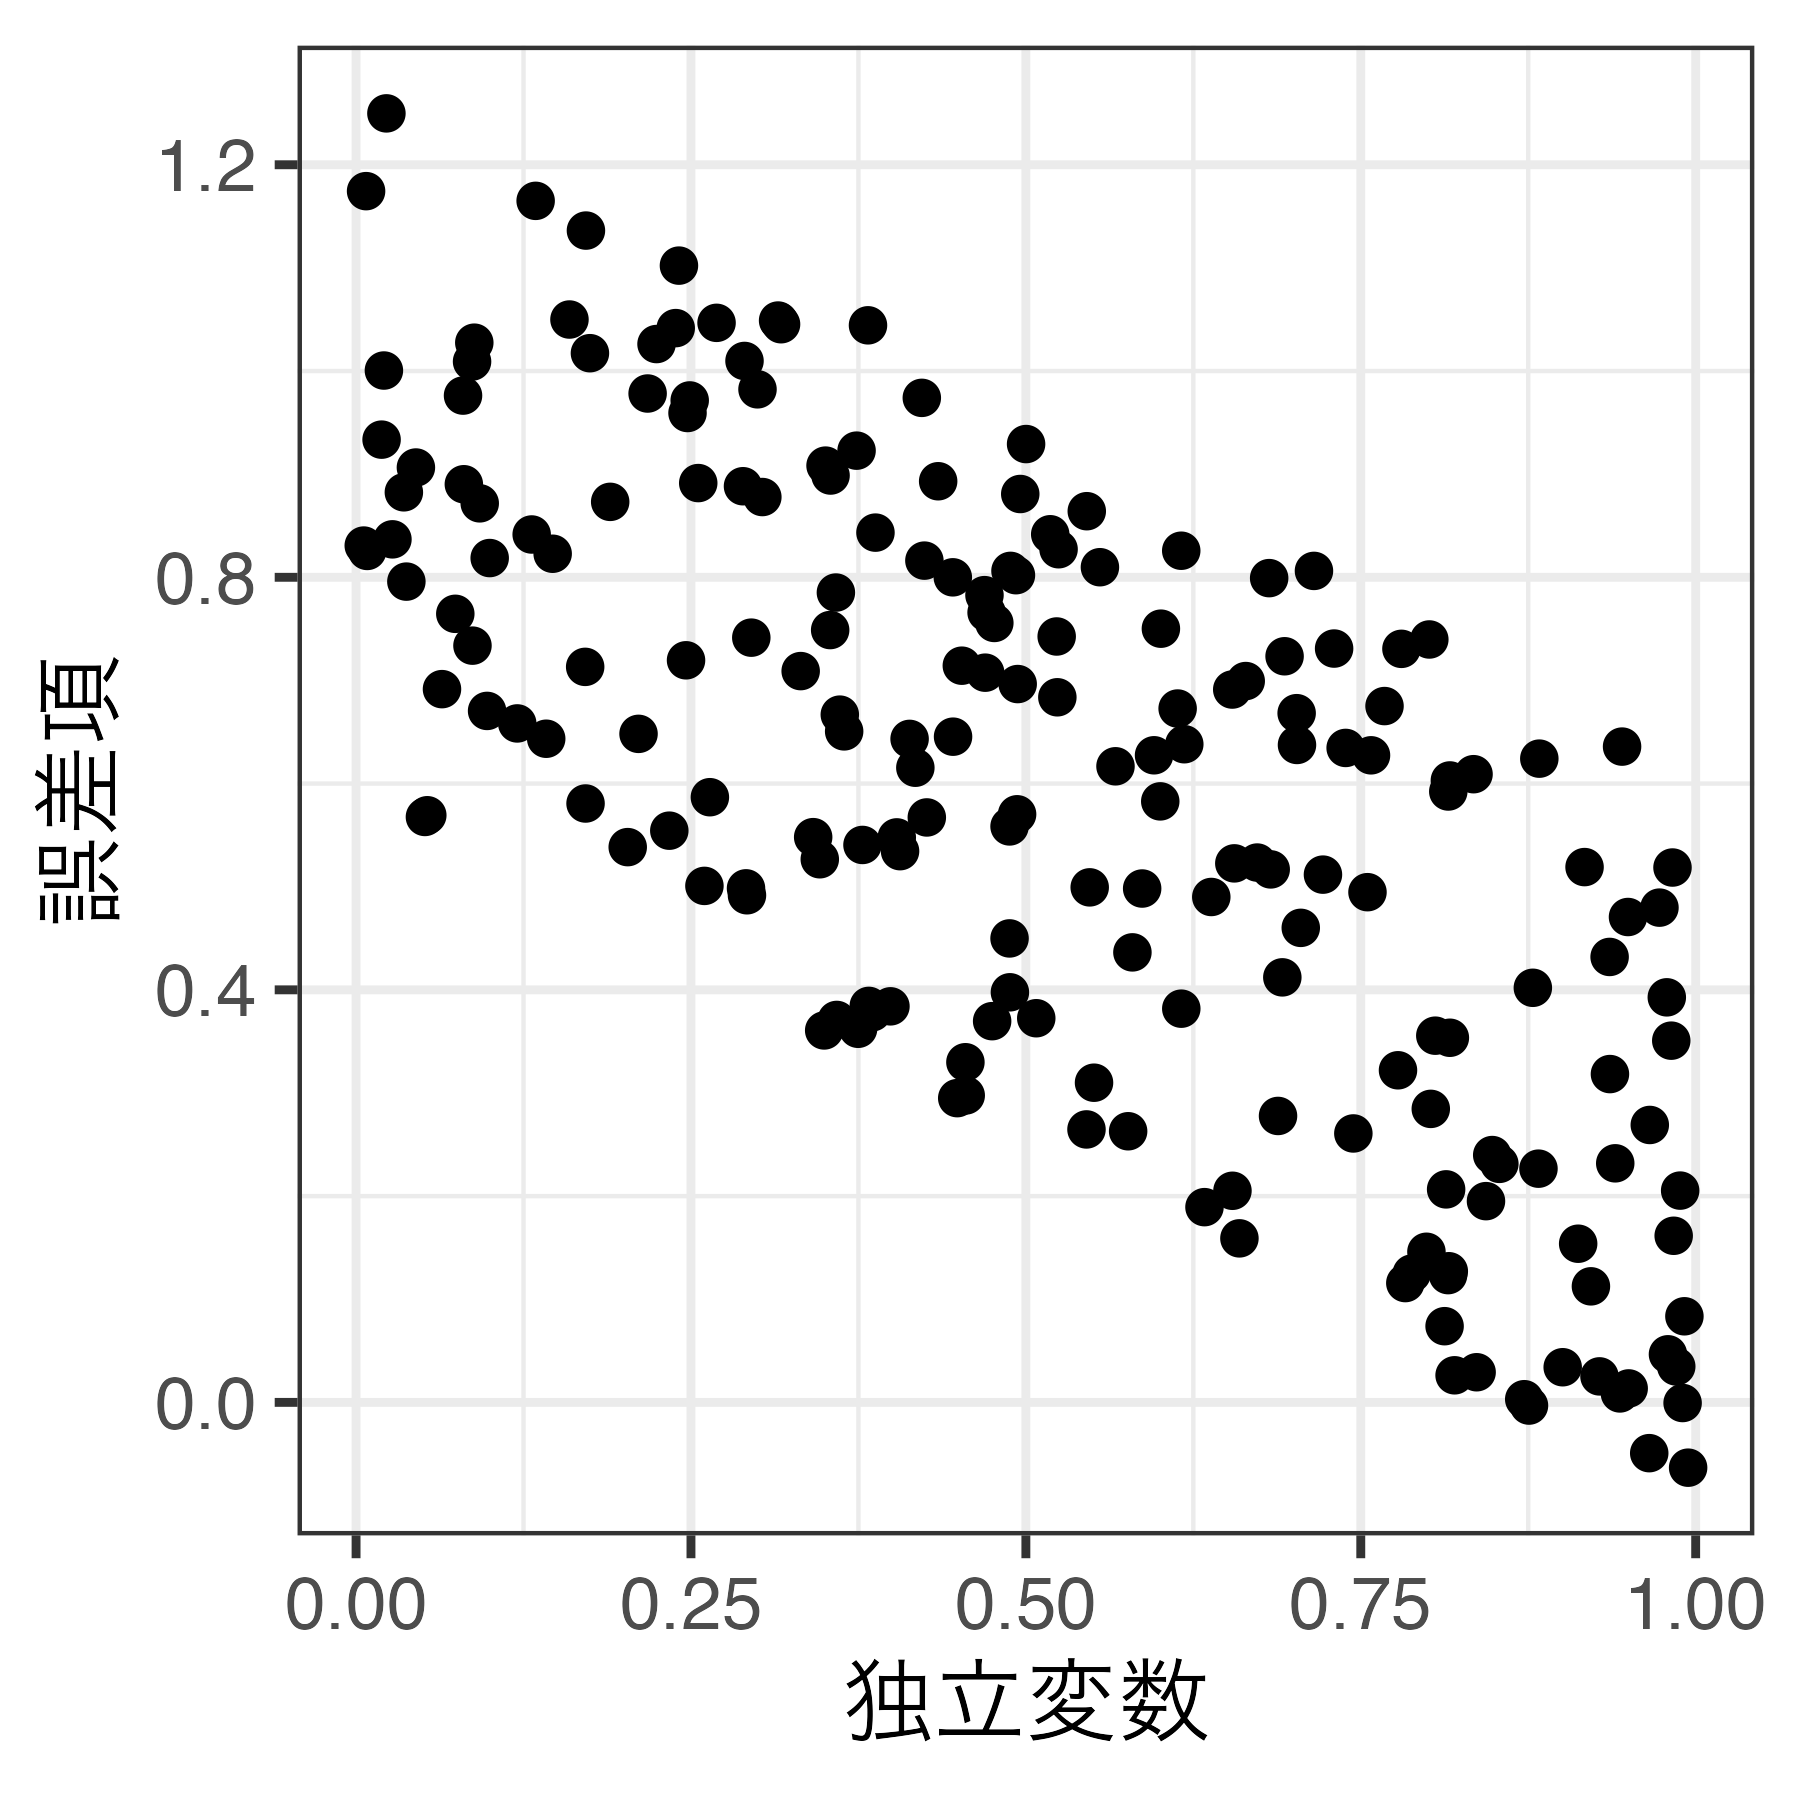
誤差項が独立変数と相関関係にあること

相関関係=共変関係:一方の変数の変化が他の変数の変化と連動すること
正の相関

無相関

負の相関

内生性の図解

内生性の基本的図式

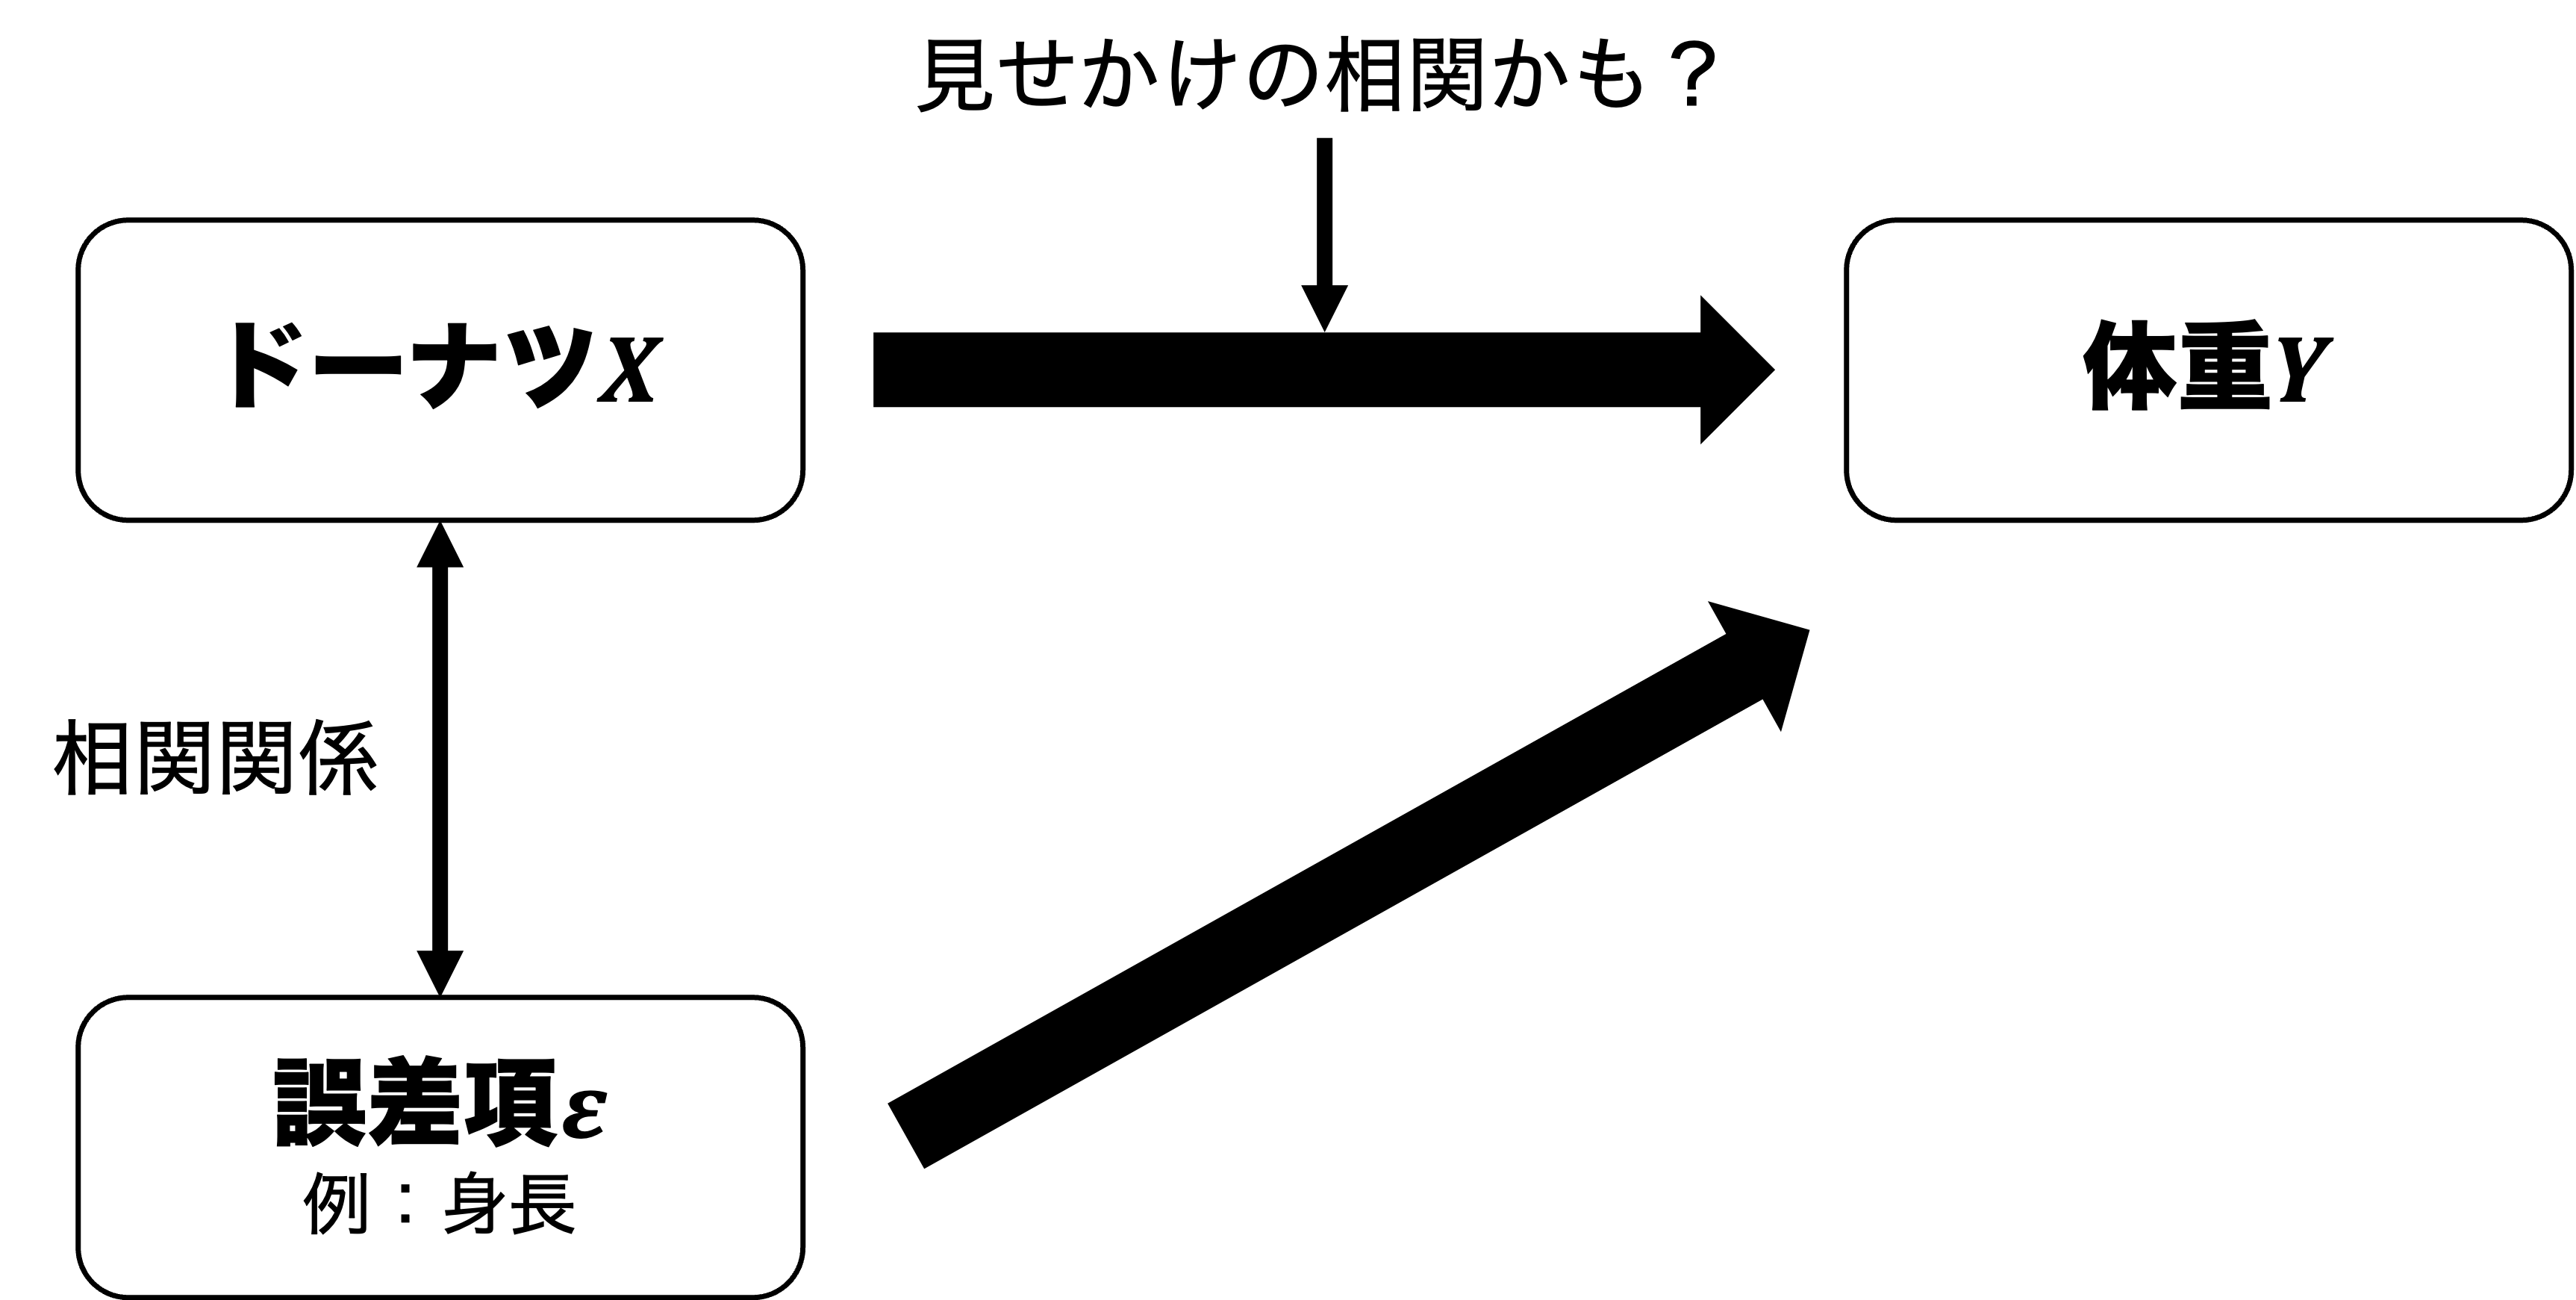
例:ドーナツと体重

ドーナツと体重の例における内生性

ランダム化実験

ランダム化比較試験

Randomized Controlled Trial: RCT

研究対象者をランダムにグループ分けし、治療法や介入などの効果を検証する方法

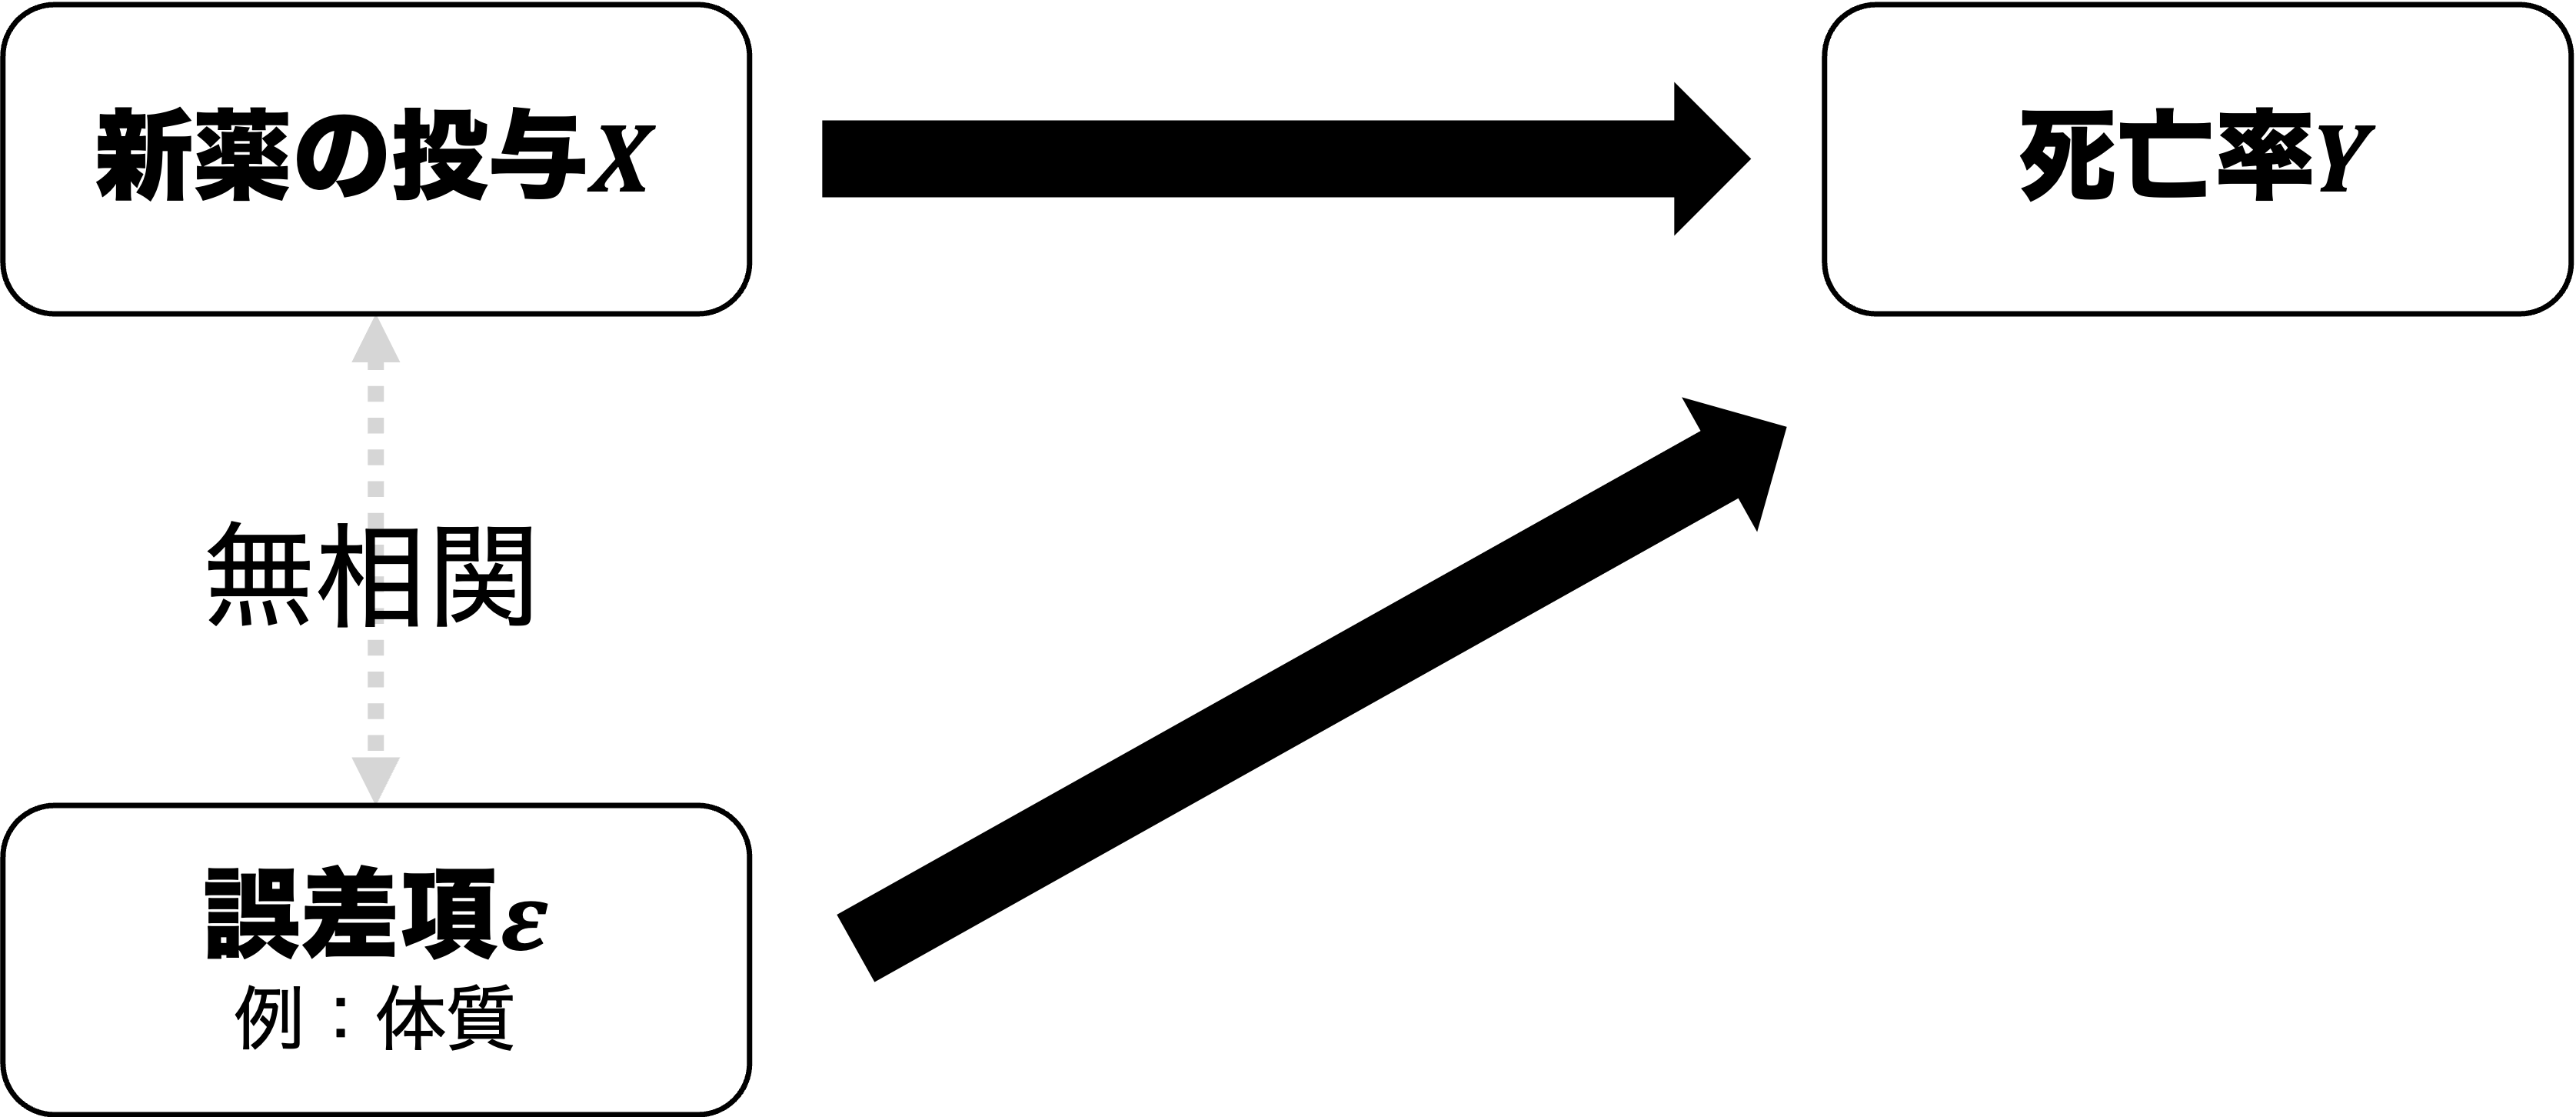
例:新薬の治験

  • 被験者をくじ引きでランダムに統制群と処置群に分割
  • 統制群にはプラセボ(偽薬)、処置群には本物の薬を投与
  • 二群間で死亡率を比較

外生性(exogeneity)

誤差項が独立変数と相関していないこと

RCTにおける外生性

RCTの限界

  1. 実施上の問題
    • 例:サーベイ実験→数十万-数百万円(金銭的コスト)
    • 例:ドーナツ摂取のランダム化(非遵守)
    • 例:民主化と経済成長(理論的に無理)
  2. 倫理上の問題
    • 例:タバコとガンの発症率を調べるRCT
  3. 外的妥当性の問題
    • 内的妥当性は高い→因果効果の厳密な推定
    • 外的妥当性は低い→実験結果を他の文脈に適用できるか?

まとめ

本日の目的と到達目標

目的

因果関係およびデータを用いた因果推論の枠組みを議論する。因果関係とはそもそも何かを定義したのち、データを使って因果推論するにあたっての難題として、ランダム性と内生性という概念を紹介する。ランダム化実験の強みと限界について理解する。

到達目標

  1. 因果関係と相関関係の違いを説明できる。 基本となる統計モデル(\(Y_i=\beta_0+\beta_{1}X_{i}+\varepsilon_i\))の各項を説明できる。
  2. 標本抽出のランダム性がなぜ因果推論を困難にするのかを説明できる。
  3. 内生性がなぜ因果推論を困難にするのかを説明できる。
  4. ランダム化実験がなぜ外生性を実現するのかを説明できる。
  5. ランダム化実験の3つの限界を列挙できる。

次回までに

事後学習

  • 授業資料を見直し、目標到達をセルフチェック
  • WebClass上での確認小テスト(金曜日まで)

事前学習

  • 教科書(2章)を読み、WebClass上でのチェックフォーム記入
  • 事前学習ビデオを視聴し、Posit Cloudの初期設定を完了をしておく

来週はオンラインによるR実習です。必ずPCで受講してください。