04/二変量回帰分析:基本編

現代政治分析入門1

鈴木淳平

駒澤大学法学部政治学科

2026-10-20

出席登録をお願いします

今日の目次

  1. はじめに
  2. 二変量回帰モデル
  3. 最小二乗法
  4. OLSのランダム性
  5. OLSの不偏性
  6. まとめ

はじめに

本日の目的と到達目標

目的

回帰分析の最も基本的な形である二変量モデルを紹介する。基本となる統計モデルについて復習した後に、回帰分析によって回帰係数を推定し、その推定値を因果効果として解釈するための基本的な方法として、最小二乗法(OLS)を学ぶ。確率分布の基本を学んだ後、OLSで得られた因果効果の推定量のランダム性を議論する。さらに内生性が推定結果をどのように歪めるのかについても検討する。

到達目標

  1. 二変量回帰モデル(\(Y_i=\beta_0+\beta_{1}X_{i}+\varepsilon_i\))の各項を説明できる。
  2. 仮想的な散布図を使って最小二乗法による回帰係数の推定を説明できる。
  3. 回帰係数の推定値\(\hat{\beta_{1}}\)の計算式を書き出し、その意味を説明できる。
  4. 回帰係数の推定値\(\hat{\beta_{1}}\)がランダム性を持つのはなぜかを説明できる。
  5. 回帰係数の推定値\(\hat{\beta_{1}}\)が不偏推定量であることの意味、そしてそれが成立する条件を説明できる。

小テストの講評

TBD

二変量回帰モデル

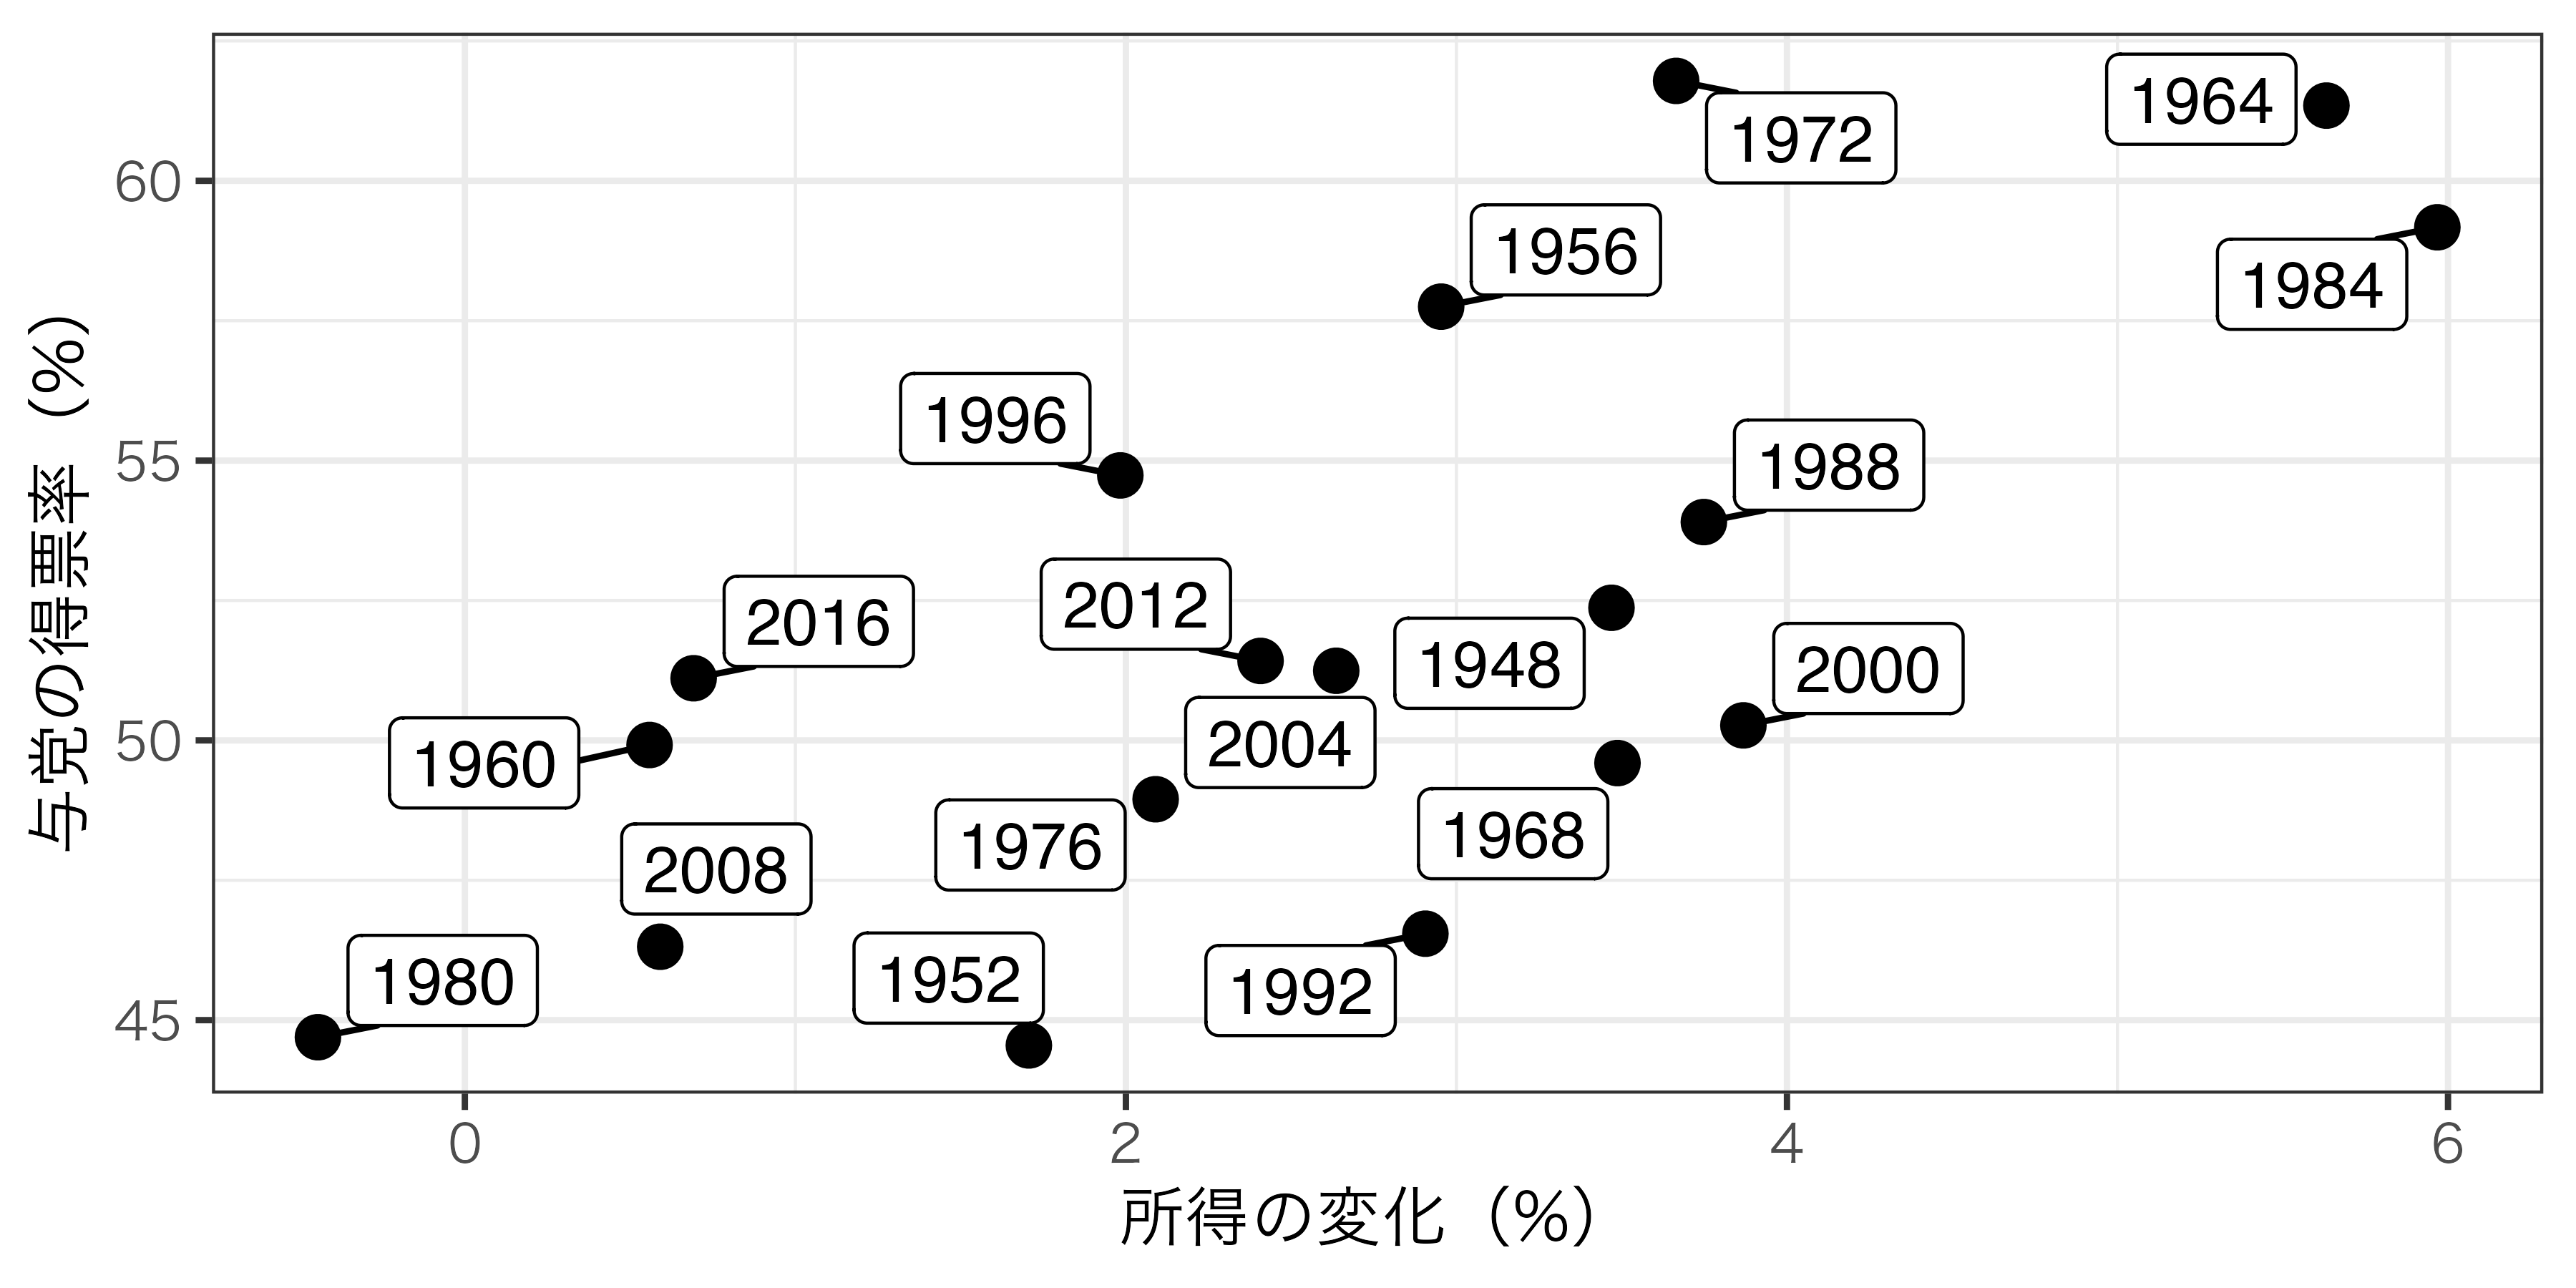
例:アメリカ大統領選挙

モデルの特定化

基本モデル \[ Y_i=\beta_{0}+\beta_{1}X_i+\varepsilon_{i} \]

この例では…

\[ 得票率_t=\beta_{0}+\beta_{1}所得の変化率_t+\varepsilon_{t} \]

  • \(\beta_{0}\):所得の変化率が0の時の与党の得票率
  • \(\beta_{1}\):所得の変化率が1単位増加したとき与党の得票率がどれくらい増えるか

最小二乗法

クイズ

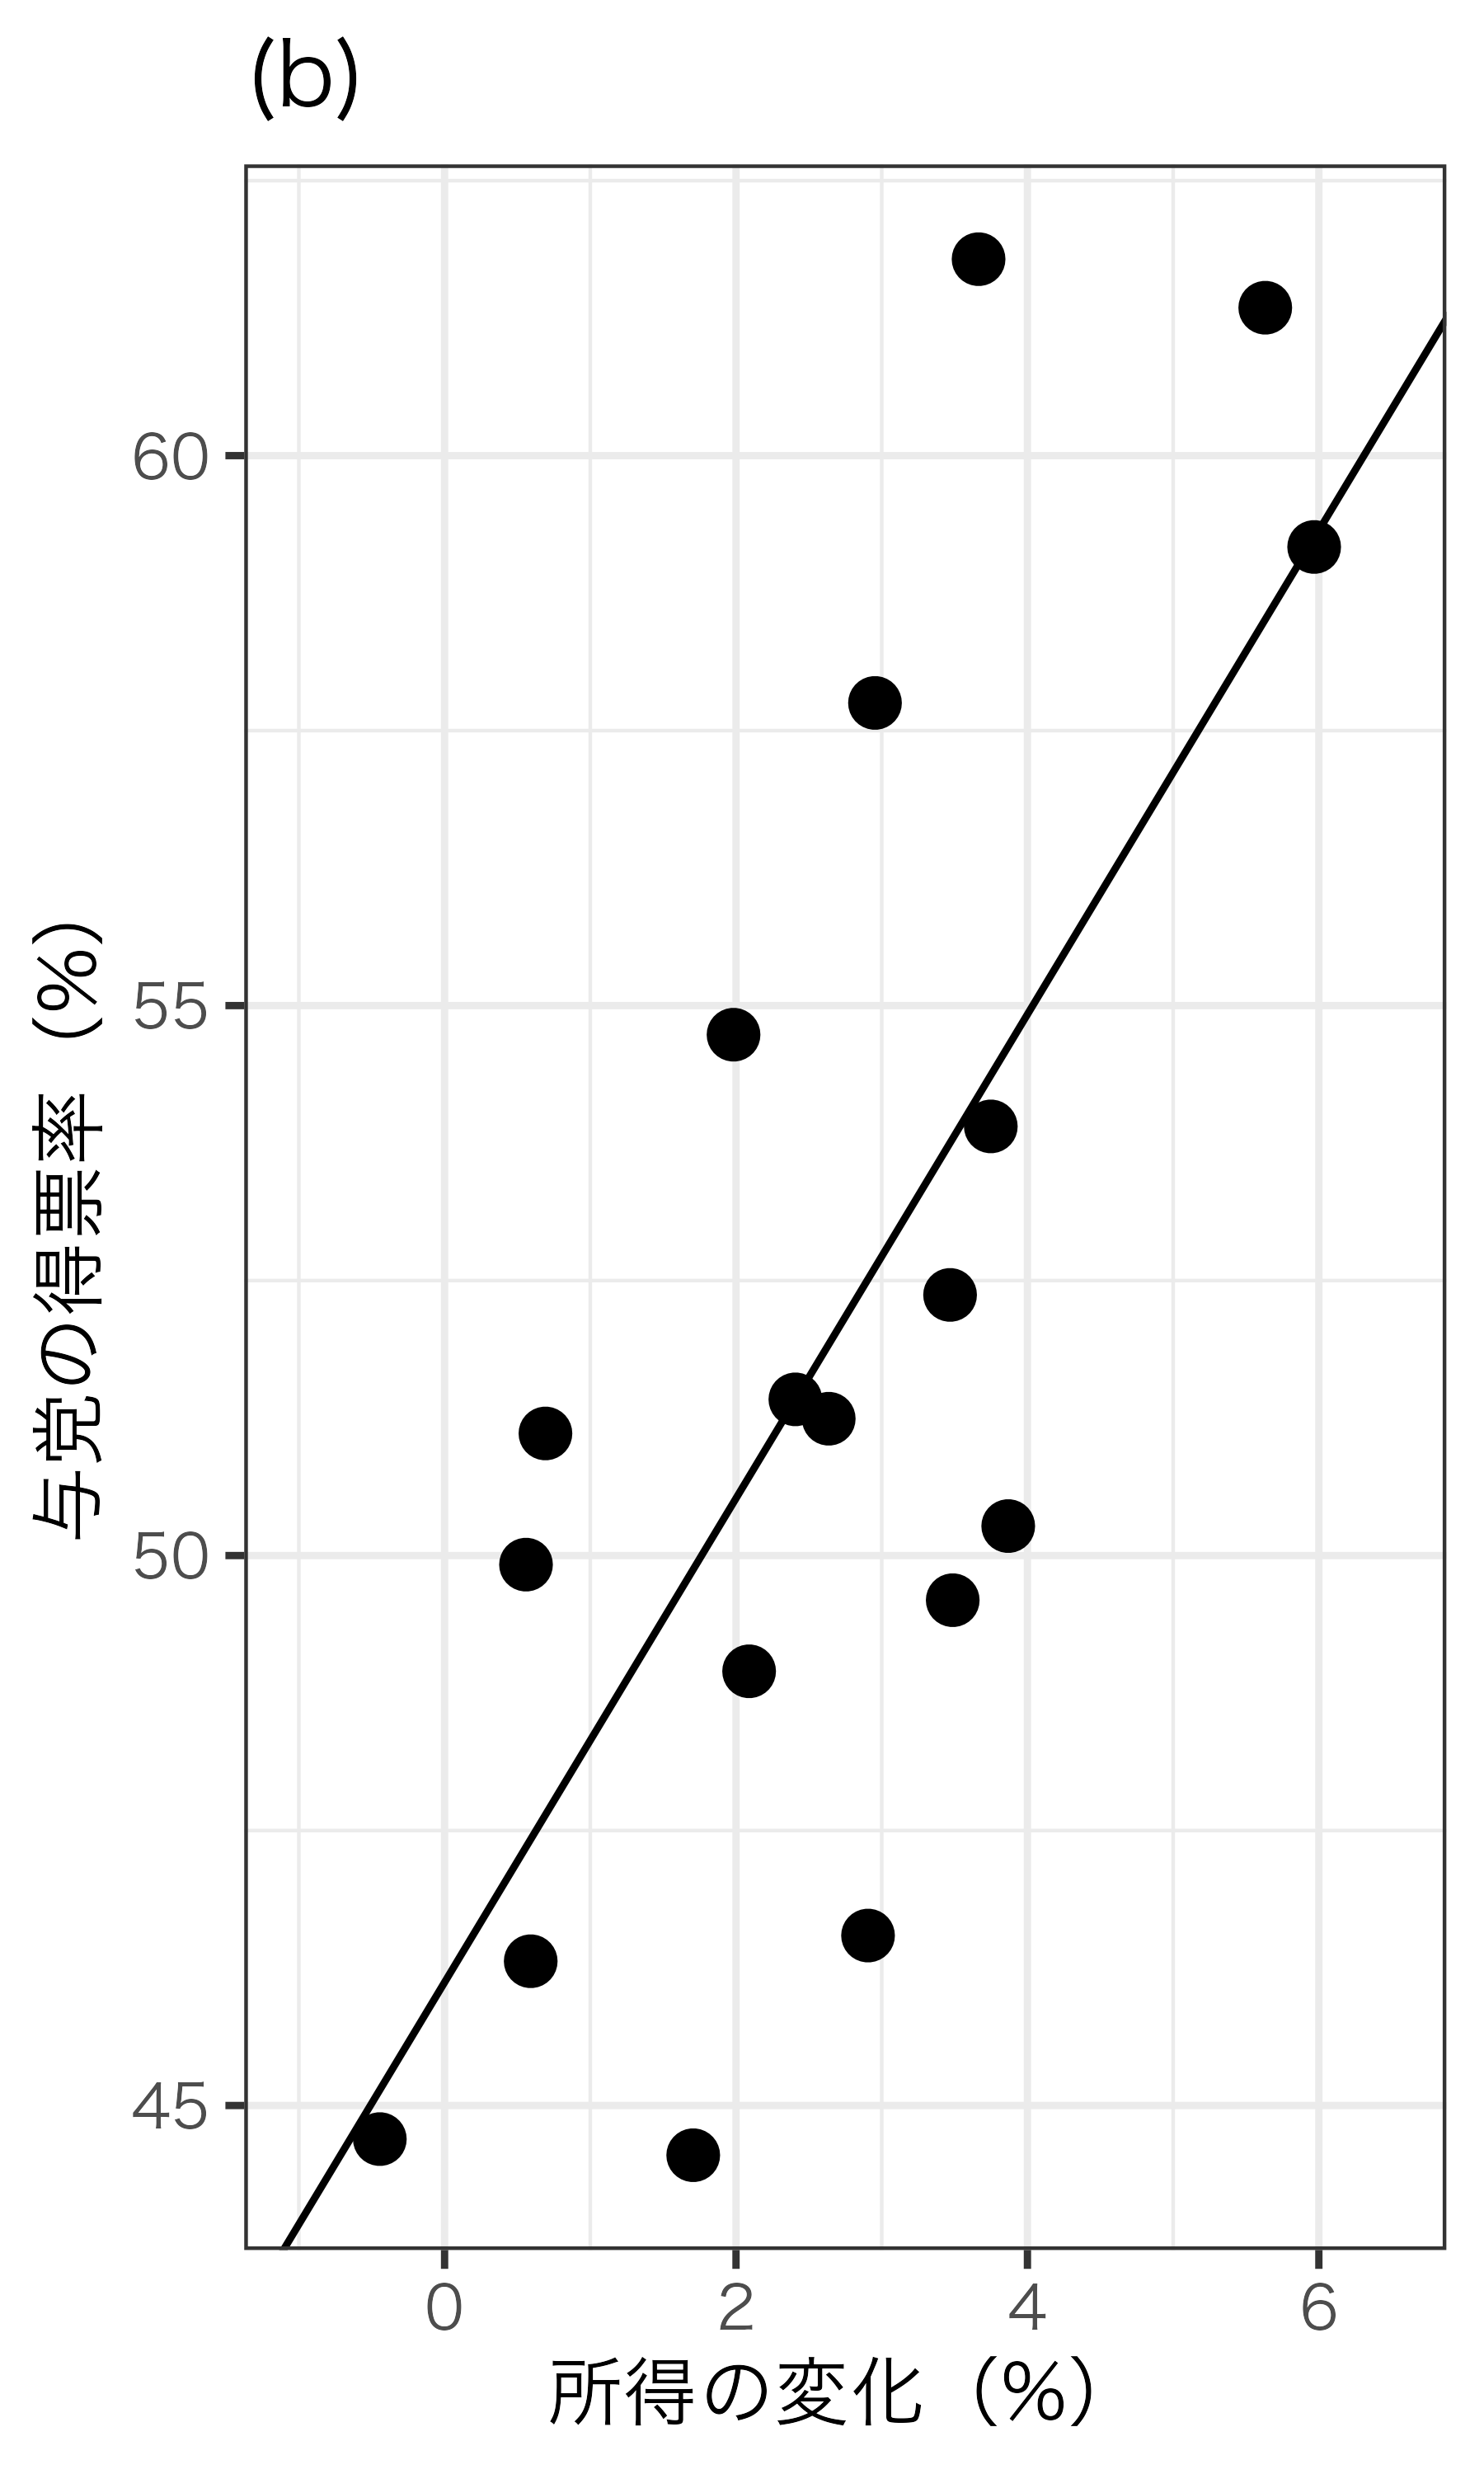
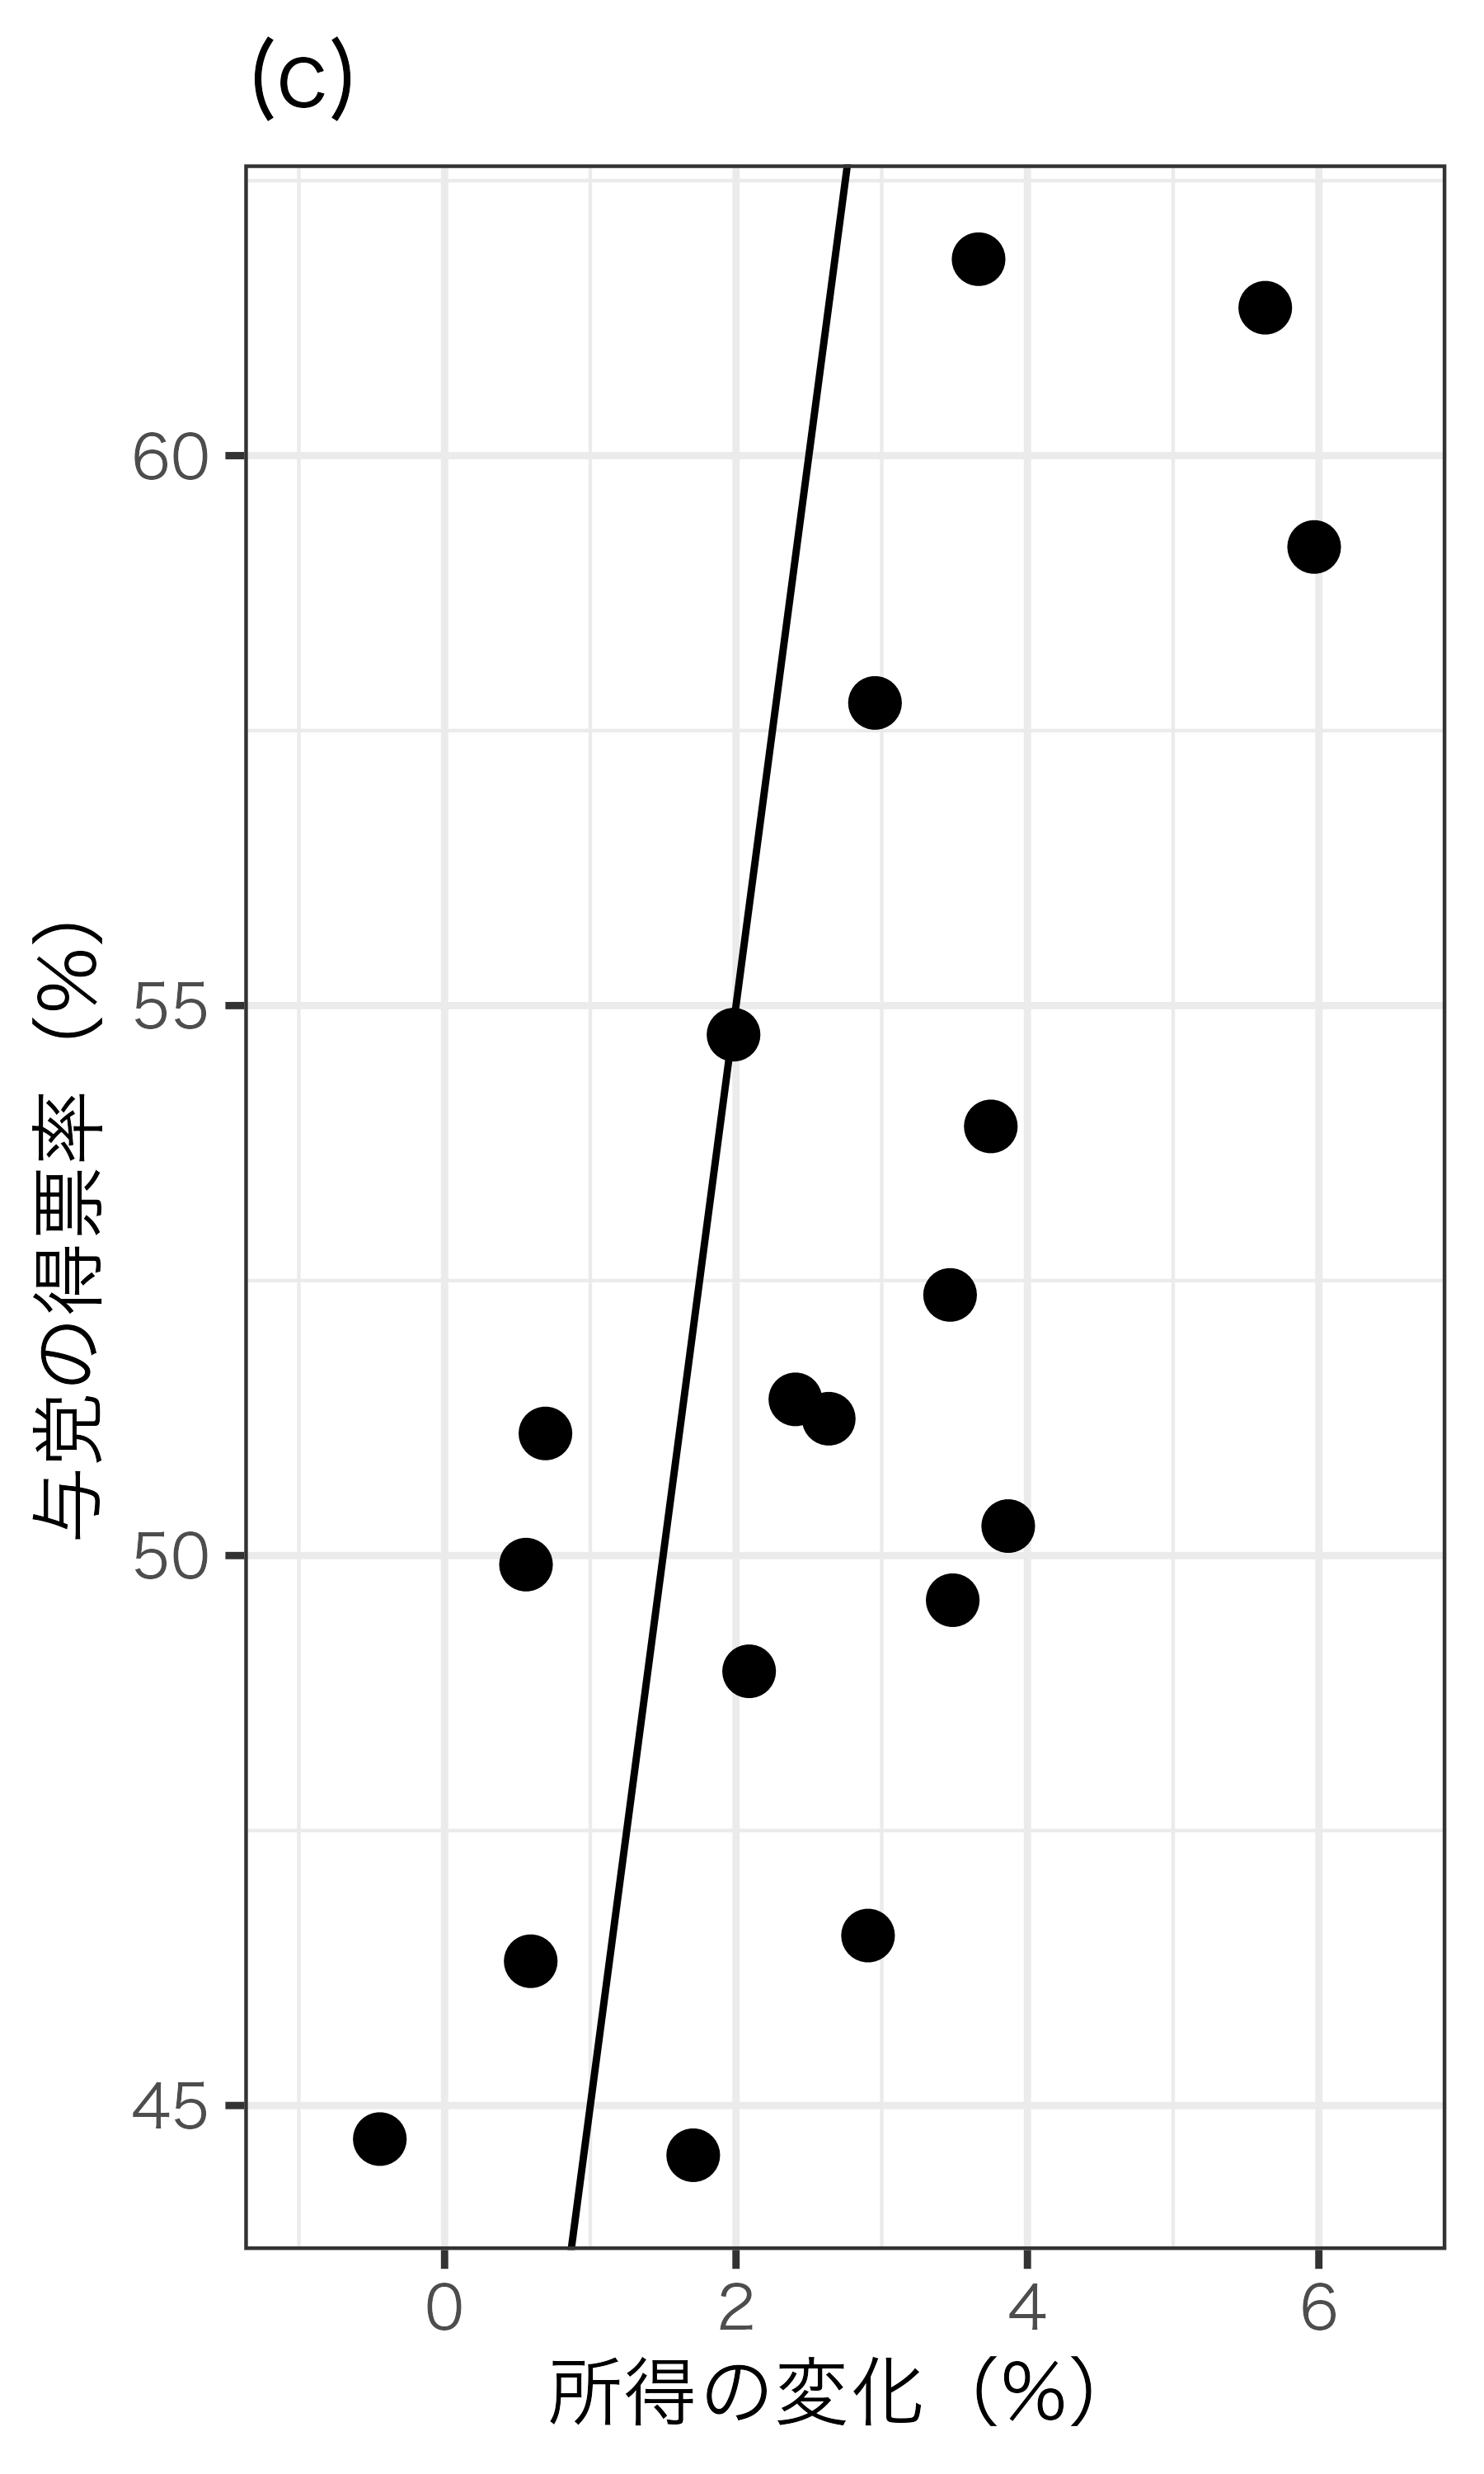
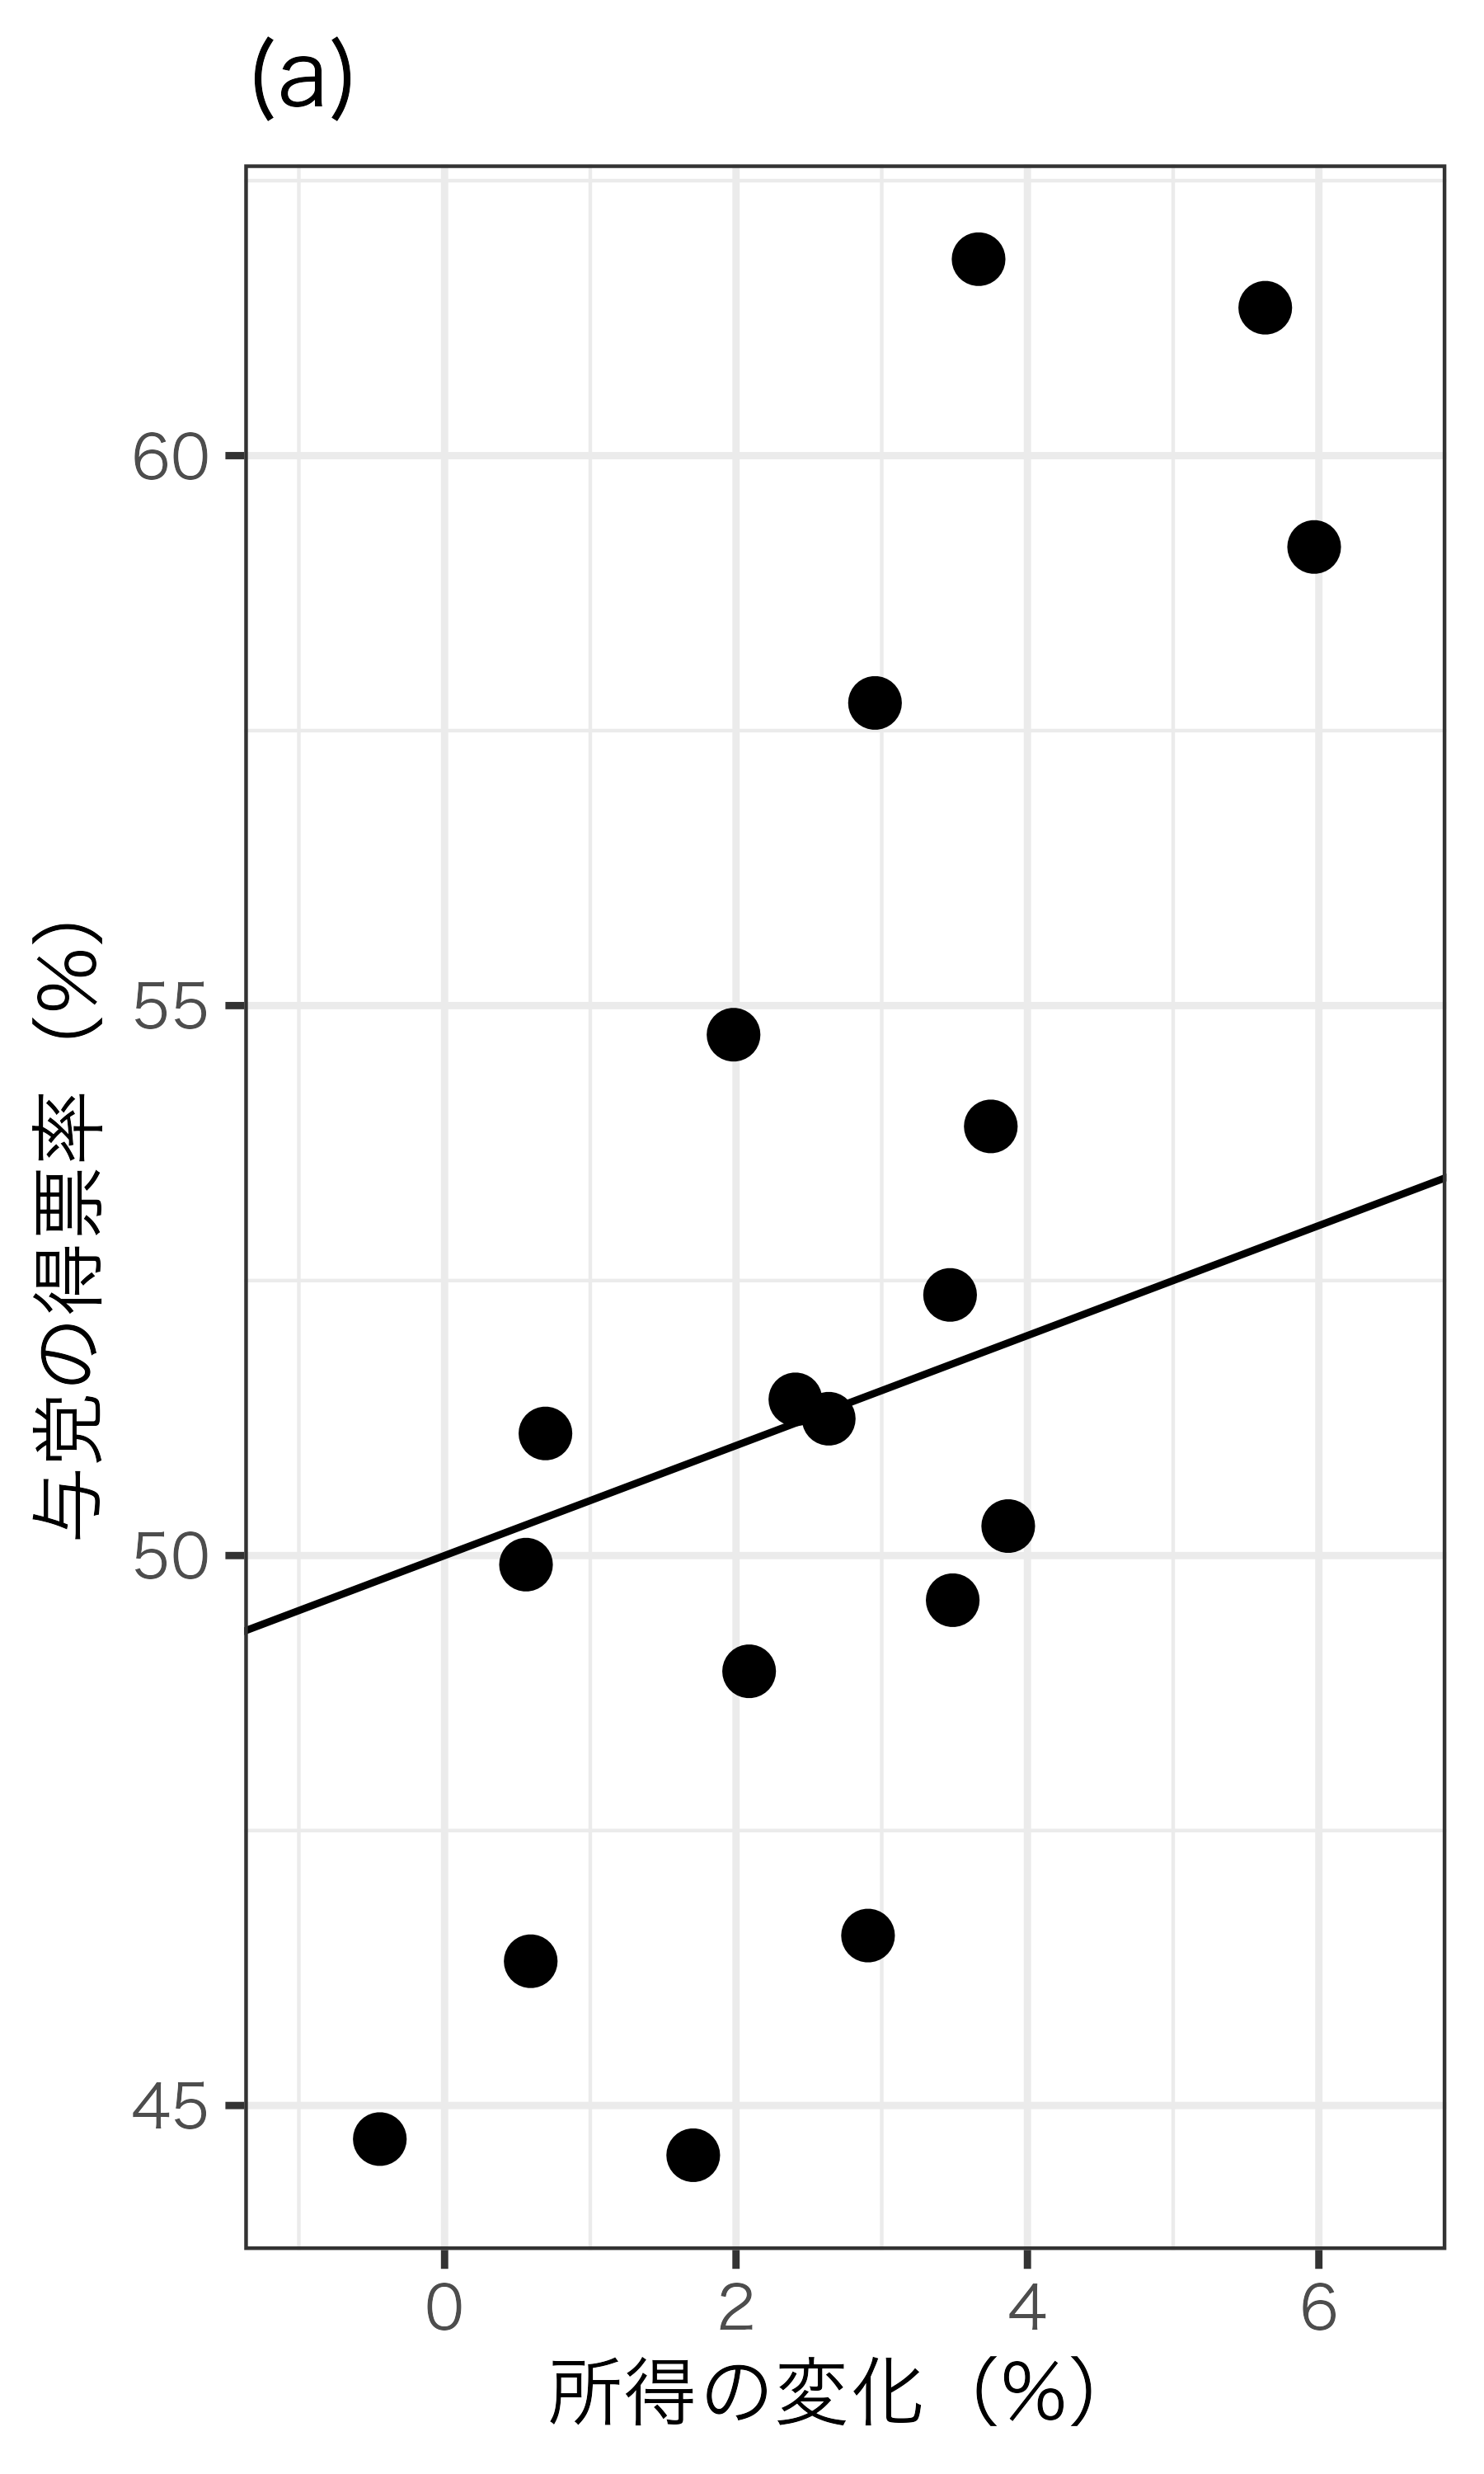
以下の3つの線のうち、どれが一番いいと思いますか?それはなぜですか?
最小二乗法

Ordinary Least Square: OLS
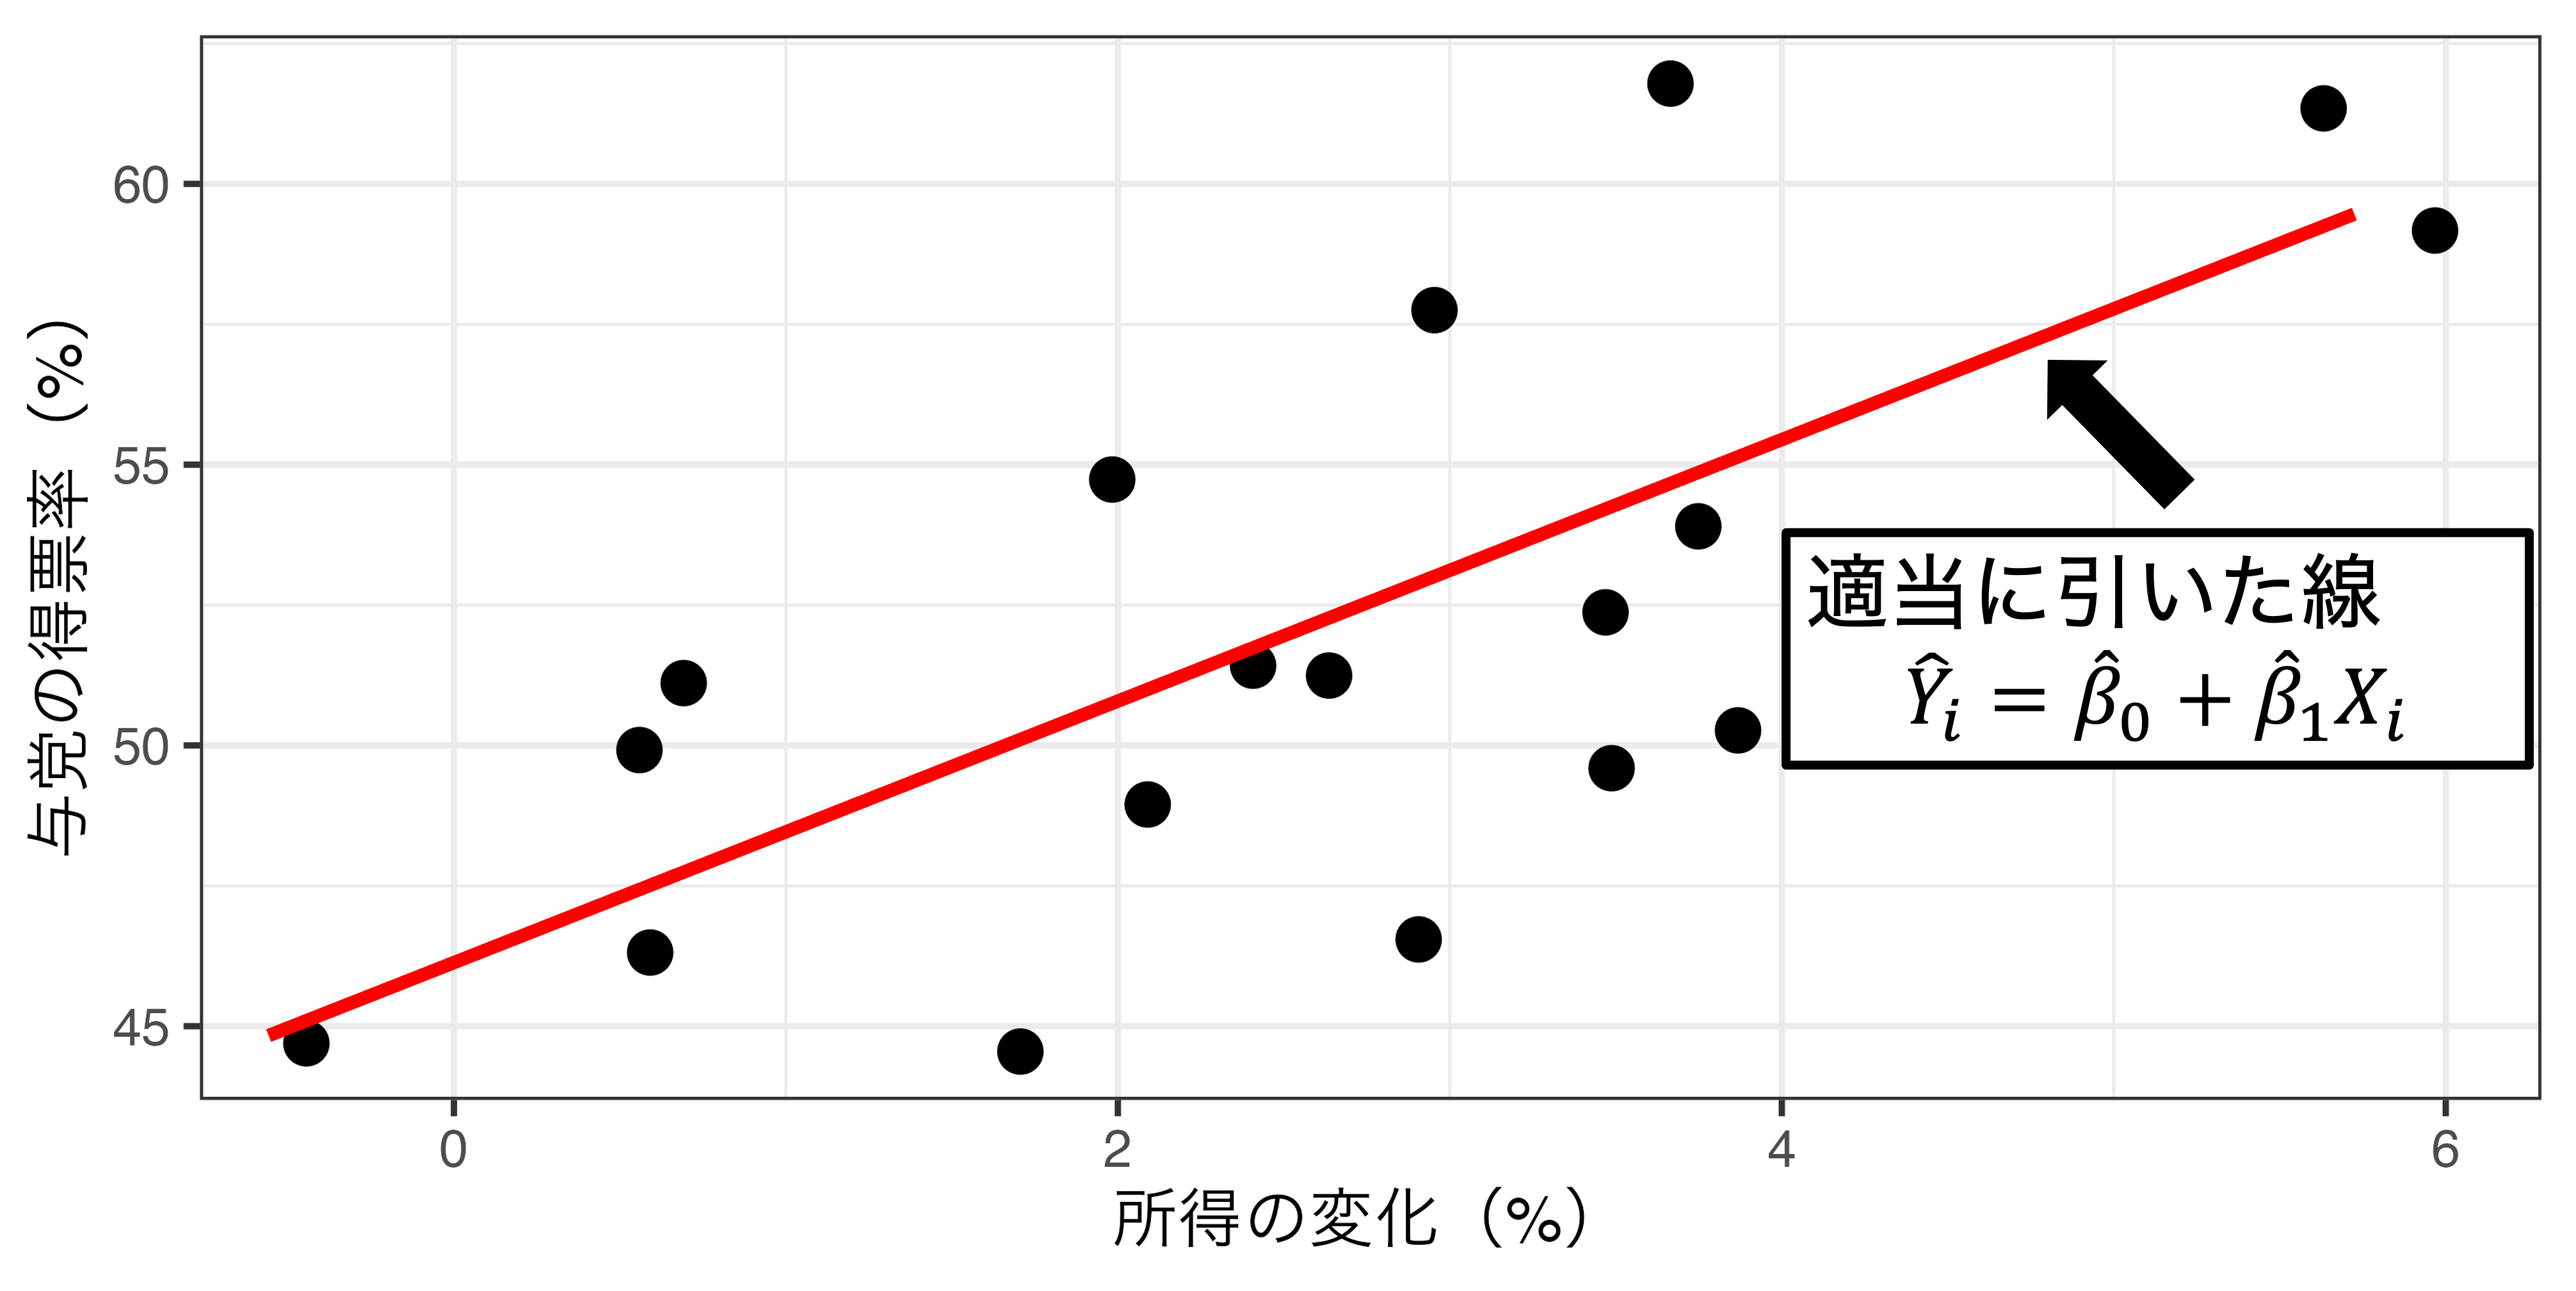
OLSの手順

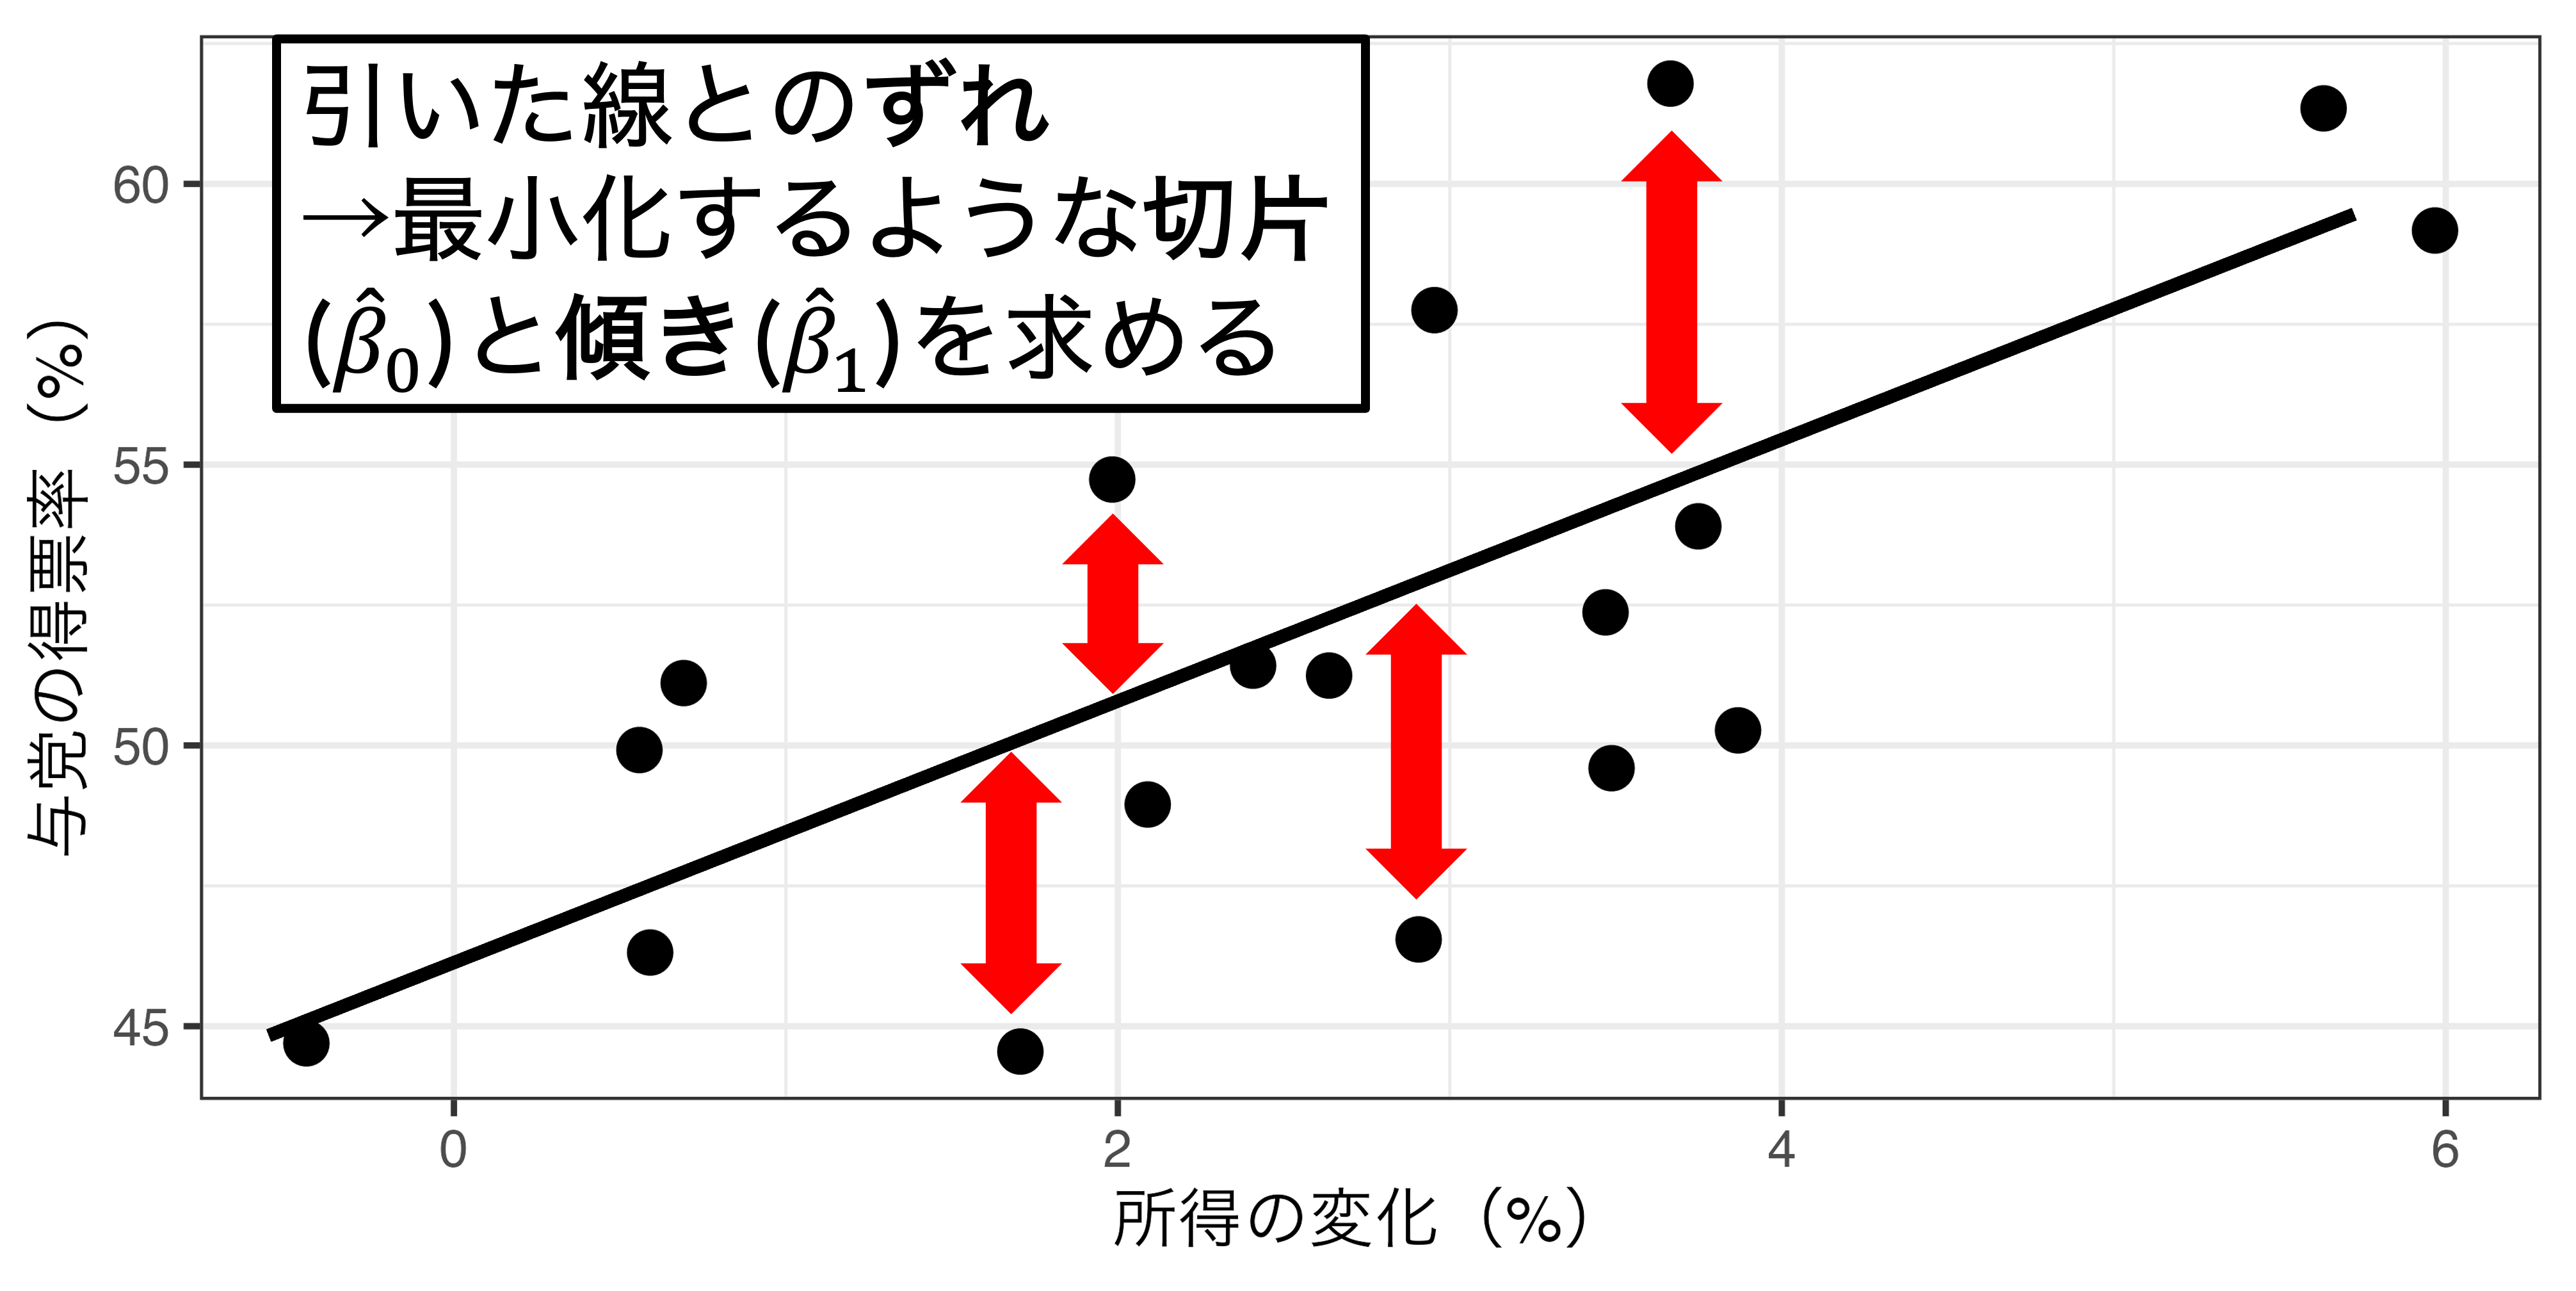
  • 予測値:\(\hat{Y_i}=\hat{\beta_{0}}+\hat{\beta_{1}}X_i\)
  • 残差:\(\hat{\varepsilon_{i}}=Y_{i}-\hat{Y_{i}}=Y_{i}-(\hat{\beta_{0}}+\hat{\beta_{1}}X_i)\)
  • 残差平方和:\(\sum \hat{\varepsilon_{i}}^2=\sum \{Y_{i}-(\hat{\beta_{0}}+\hat{\beta_{1}}X_i)\}^2\)
    • そのまま足すと0になるので二乗する
  • 残差平方和を最小化する\(\hat{\beta_{1}}\)と\(\hat{\beta_{0}}\)を求める
    • 微分が必要なので求め方は割愛
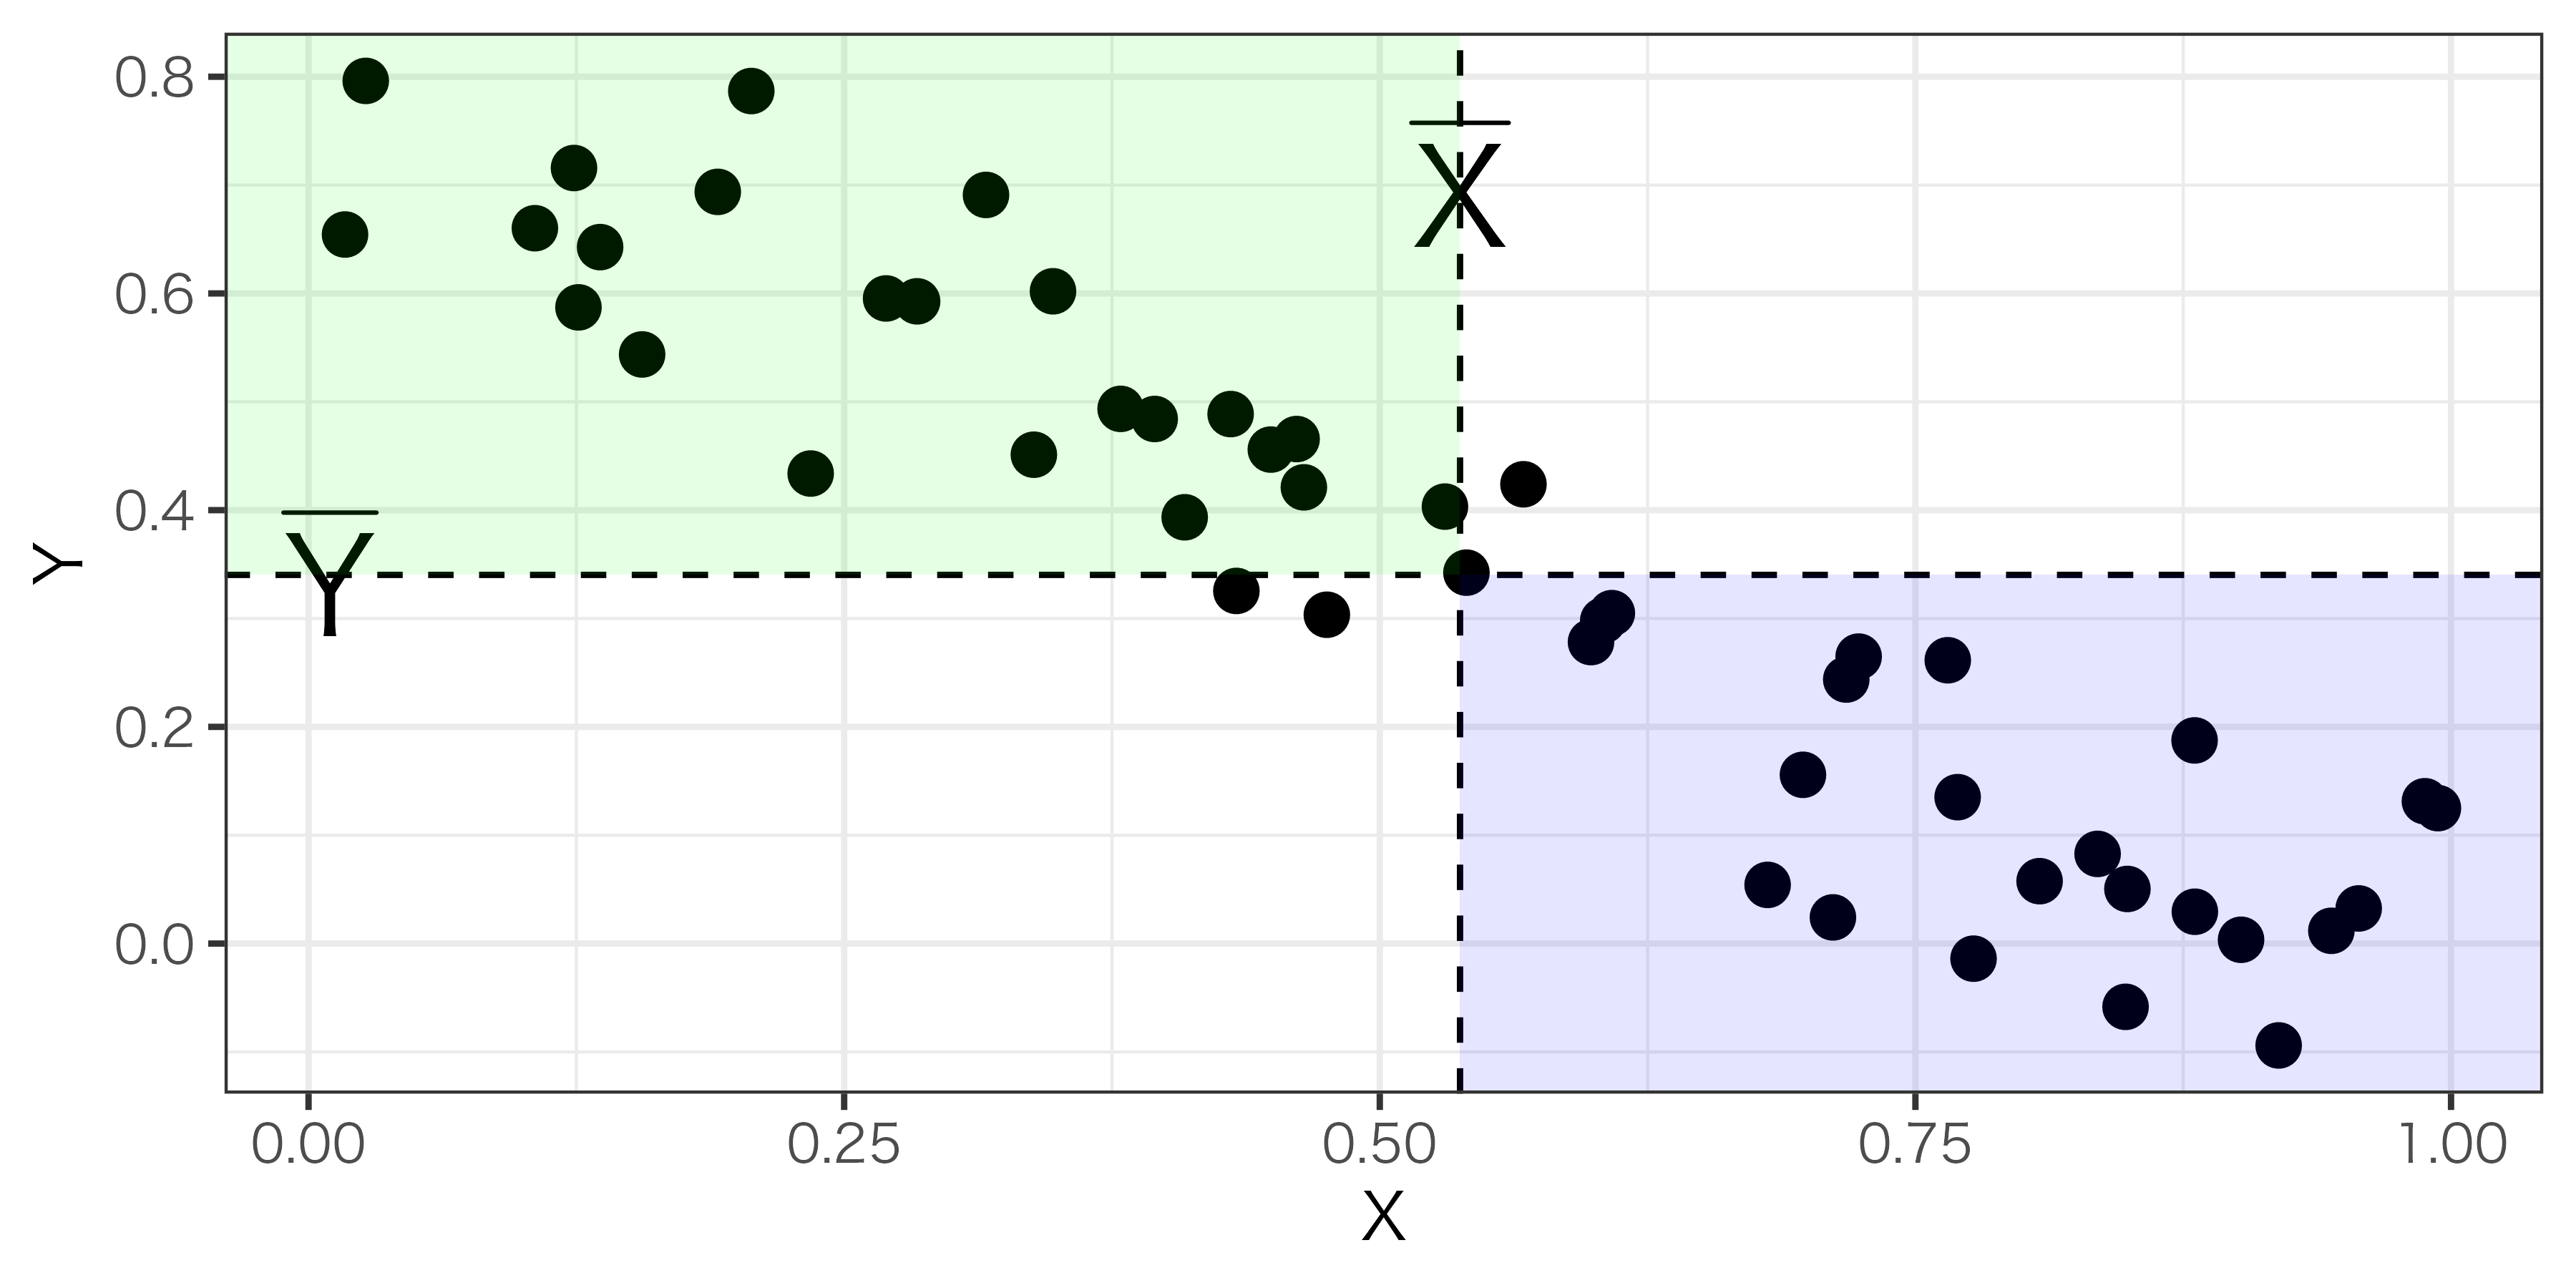
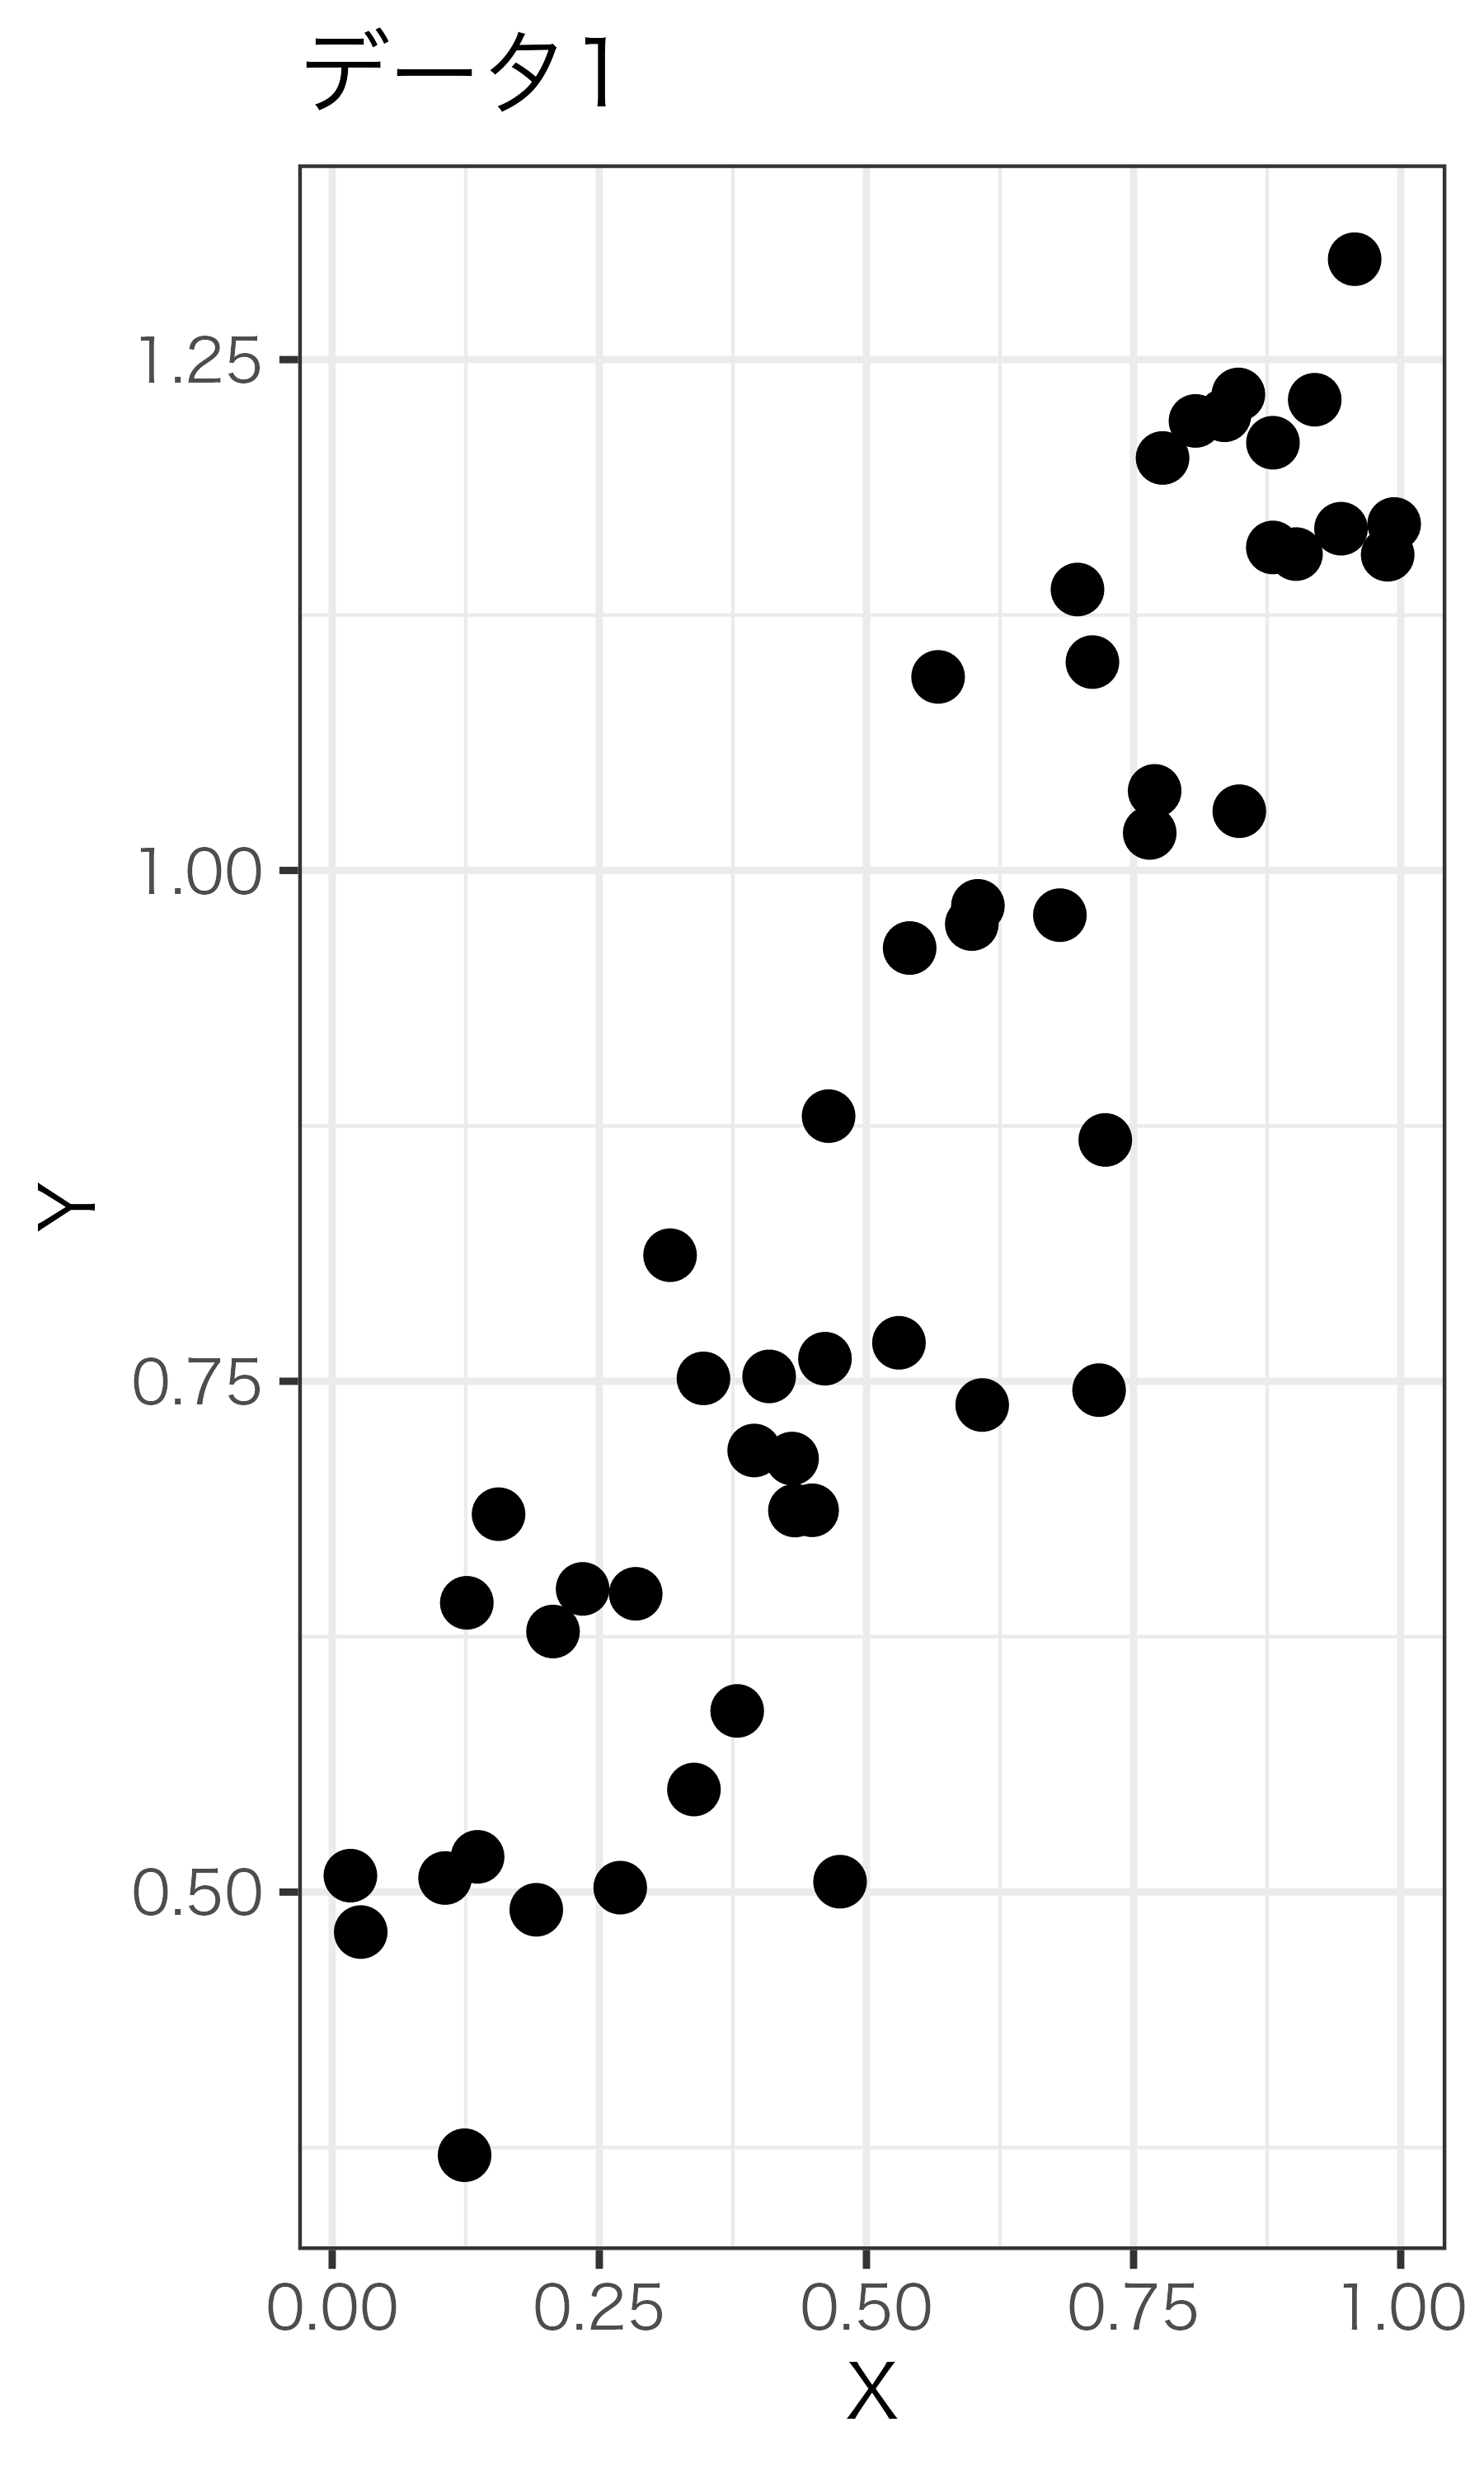
    • \(\hat{\beta_{1}}=\frac{\sum(X_i-\bar{X})(Y_i-\bar{Y})}{\sum(X_i-\bar{X})^2}\)、\(\hat{\beta_{0}}=\bar{Y}-\hat{\beta_{1}}\bar{X}\)

大統領選データでの計算

年 \(X_i\) \(Y_i\)
1948 3.47 52.37
1952 1.71 44.55
1956 2.95 57.75
1960 0.56 49.92
… … …
  • \(\bar{X}=2.66\)
  • \(\bar{Y}=51.98\)

\[ \begin{aligned} \hat{\beta_{1}}&=\frac{\sum(X_i-\bar{X})(Y_i-\bar{Y})}{\sum(X_i-\bar{X})^2}\\\\&=\frac{(3.47 - 2.66) (52.37 - 51.98) + (1.71 - 2.66) (45.55 - 51.98) + \cdots}{(3.47 - 2.66)^2 + (1.71 - 2.66)^2 + \cdots}\\\\&=2.22\\\ \hat{\beta_{0}}&=\bar{Y}-\hat{\beta_{1}}\bar{X}\\\\&=51.98-2.22\times2.66\\\\&=46.1 \end{aligned} \]

クイズ

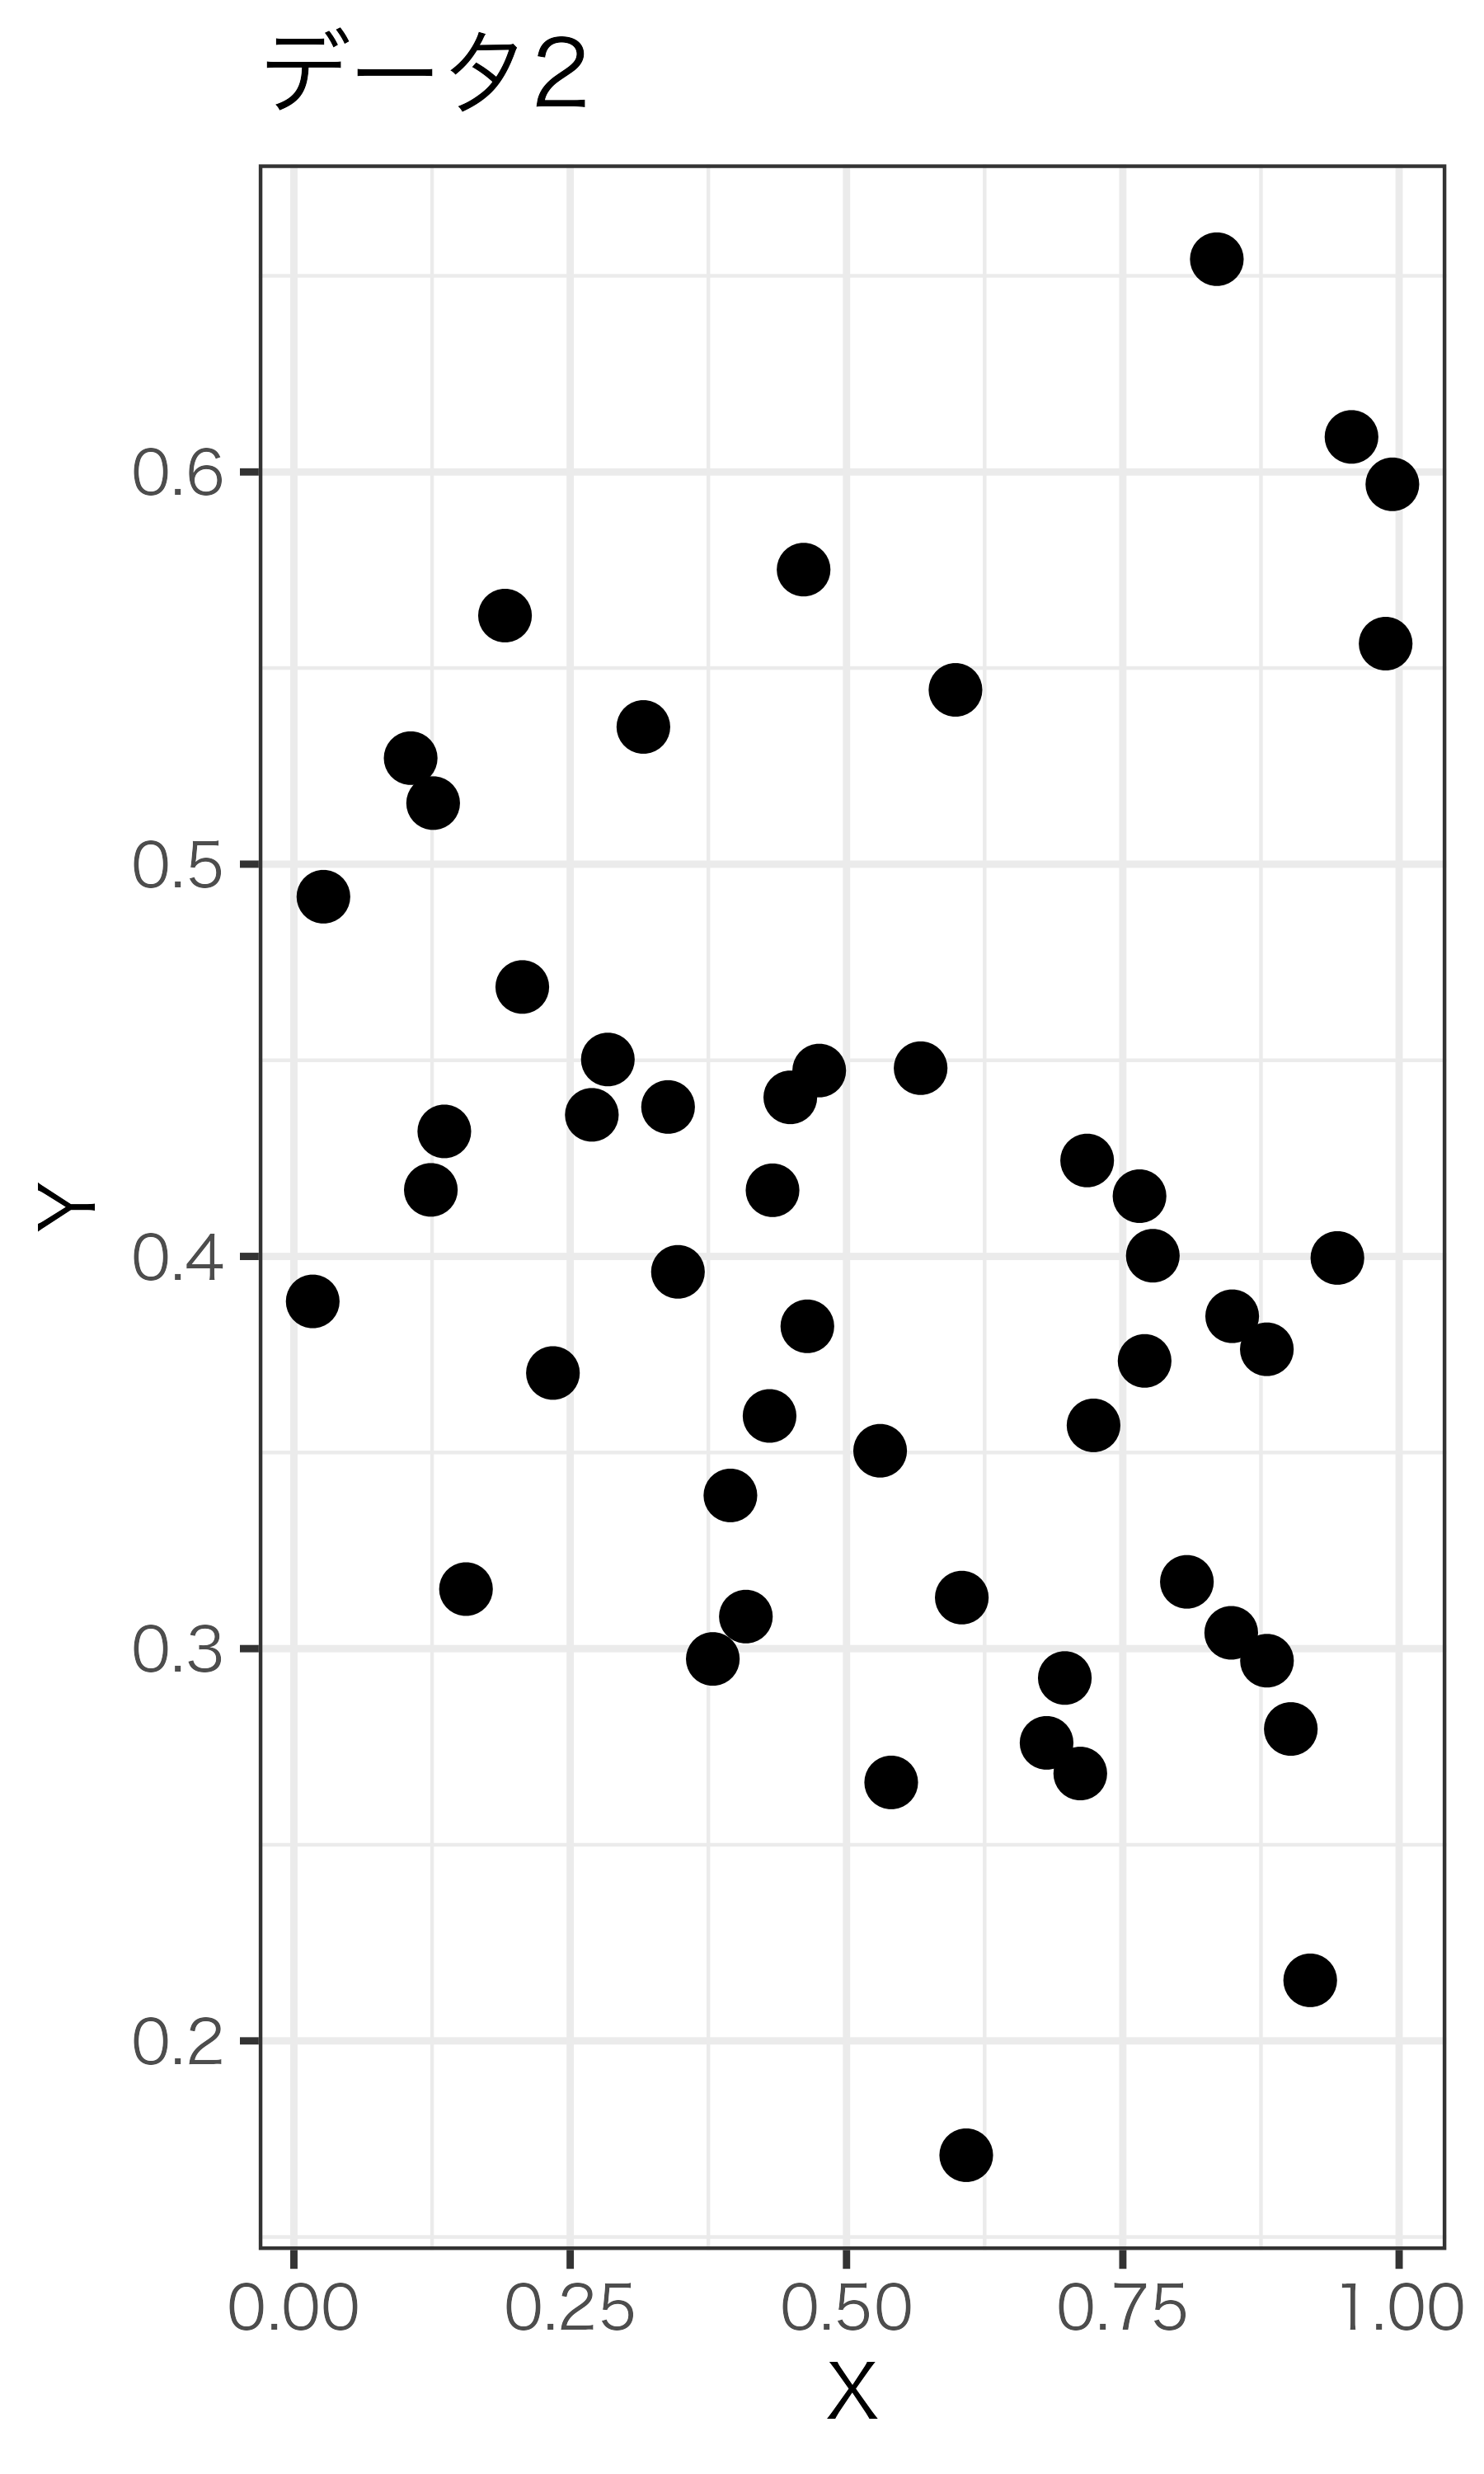
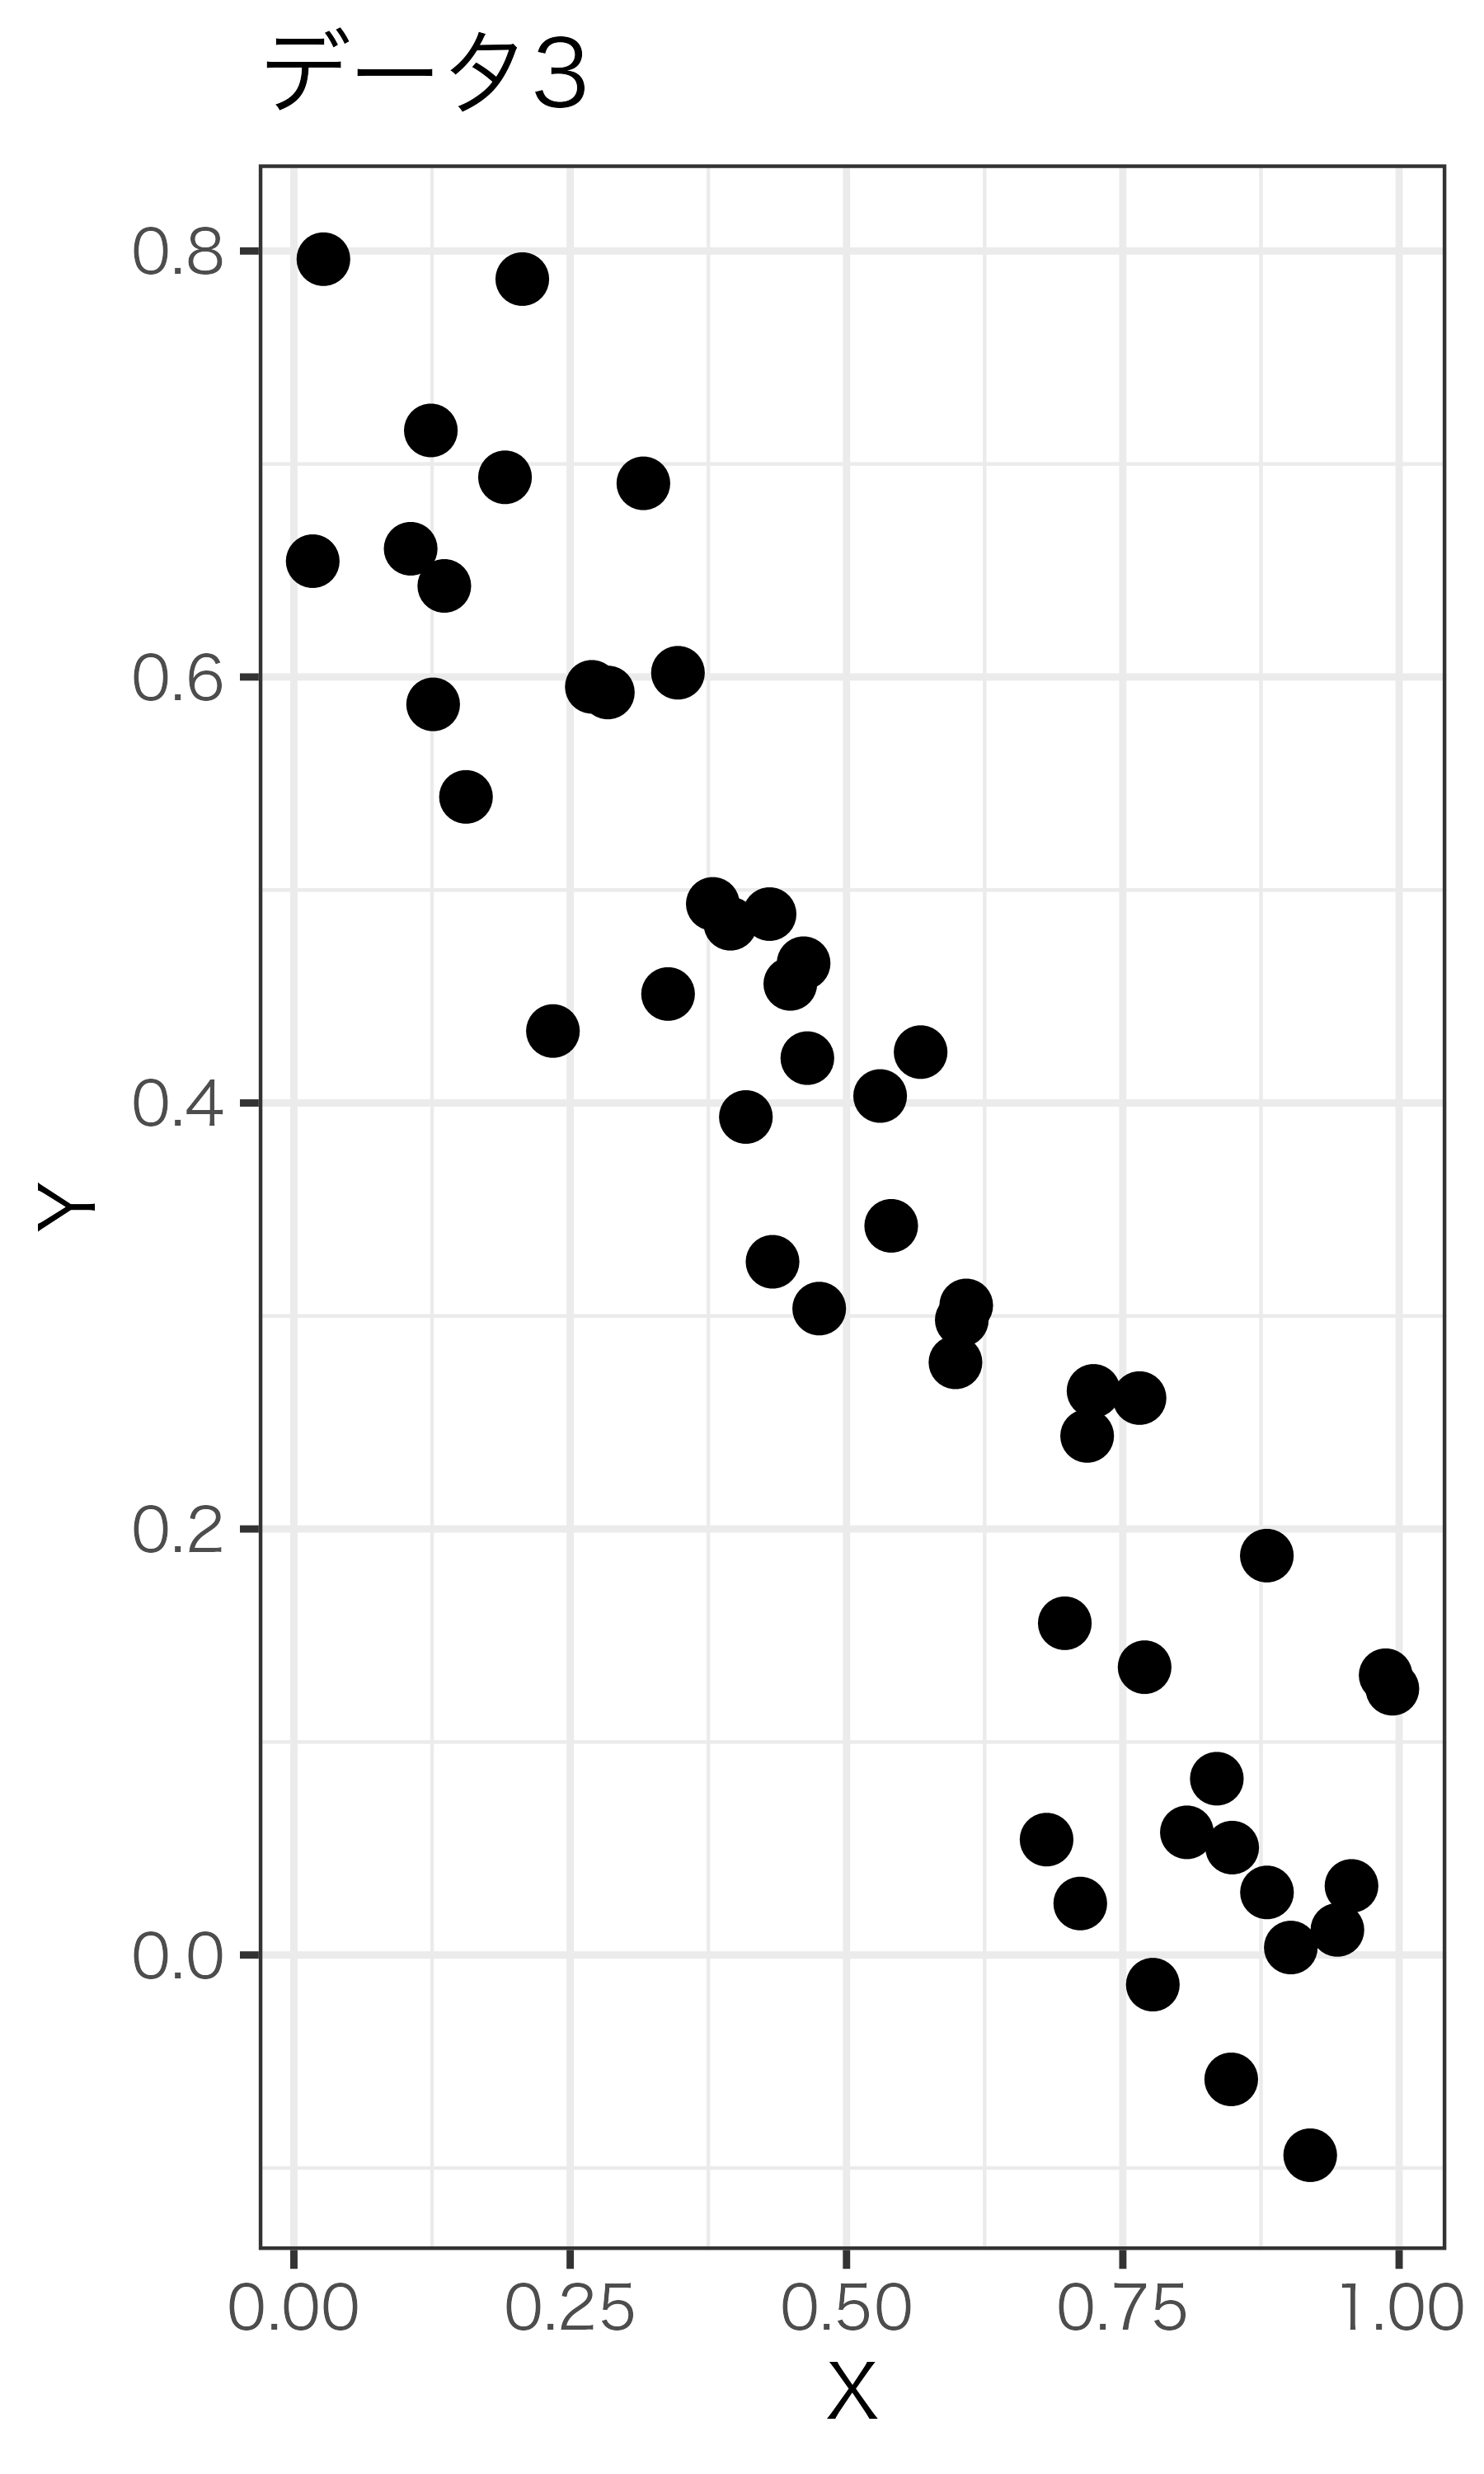
\(\hat{\beta_{1}}\)が正になるのは次のうちどのデータだと思いますか?
推定値の意味
OLSのランダム性

確率変数

特定の確率で値が定まる変数

確率分布は確率変数が取る値の確率を定める

  • コイン投げ→分布:表1/2、裏1/2
  • サイコロ→分布:各目が1/6
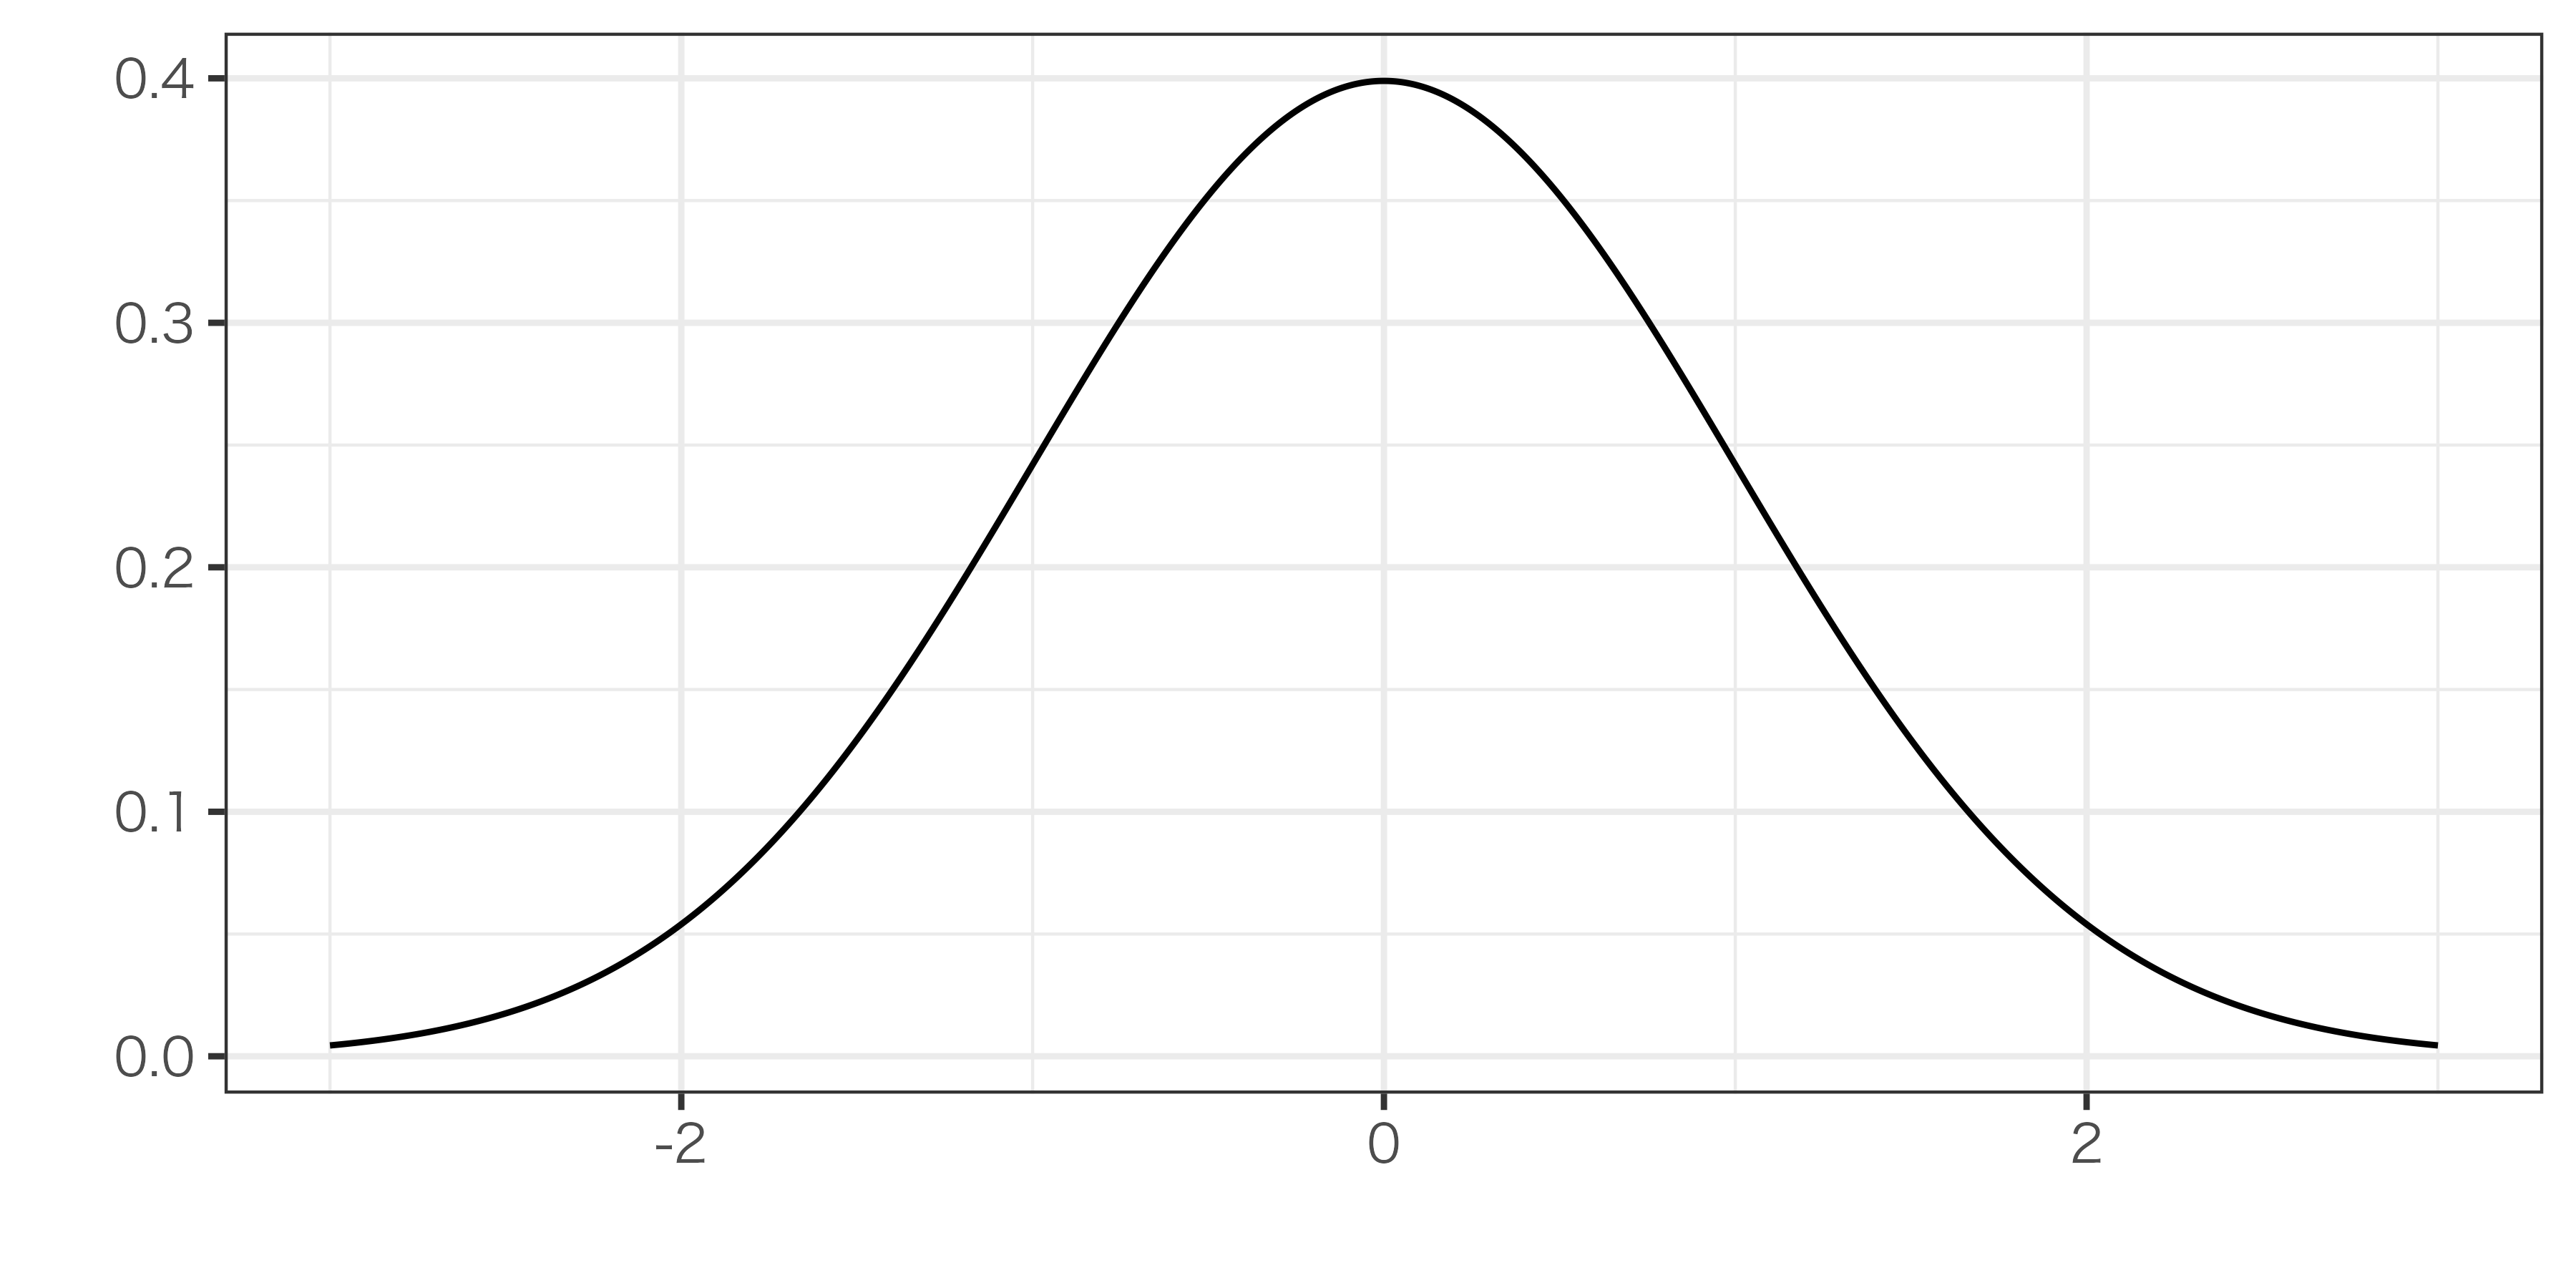
  • 身長など多くの連続変数→正規分布

正規分布

OLS推定値のランダム性

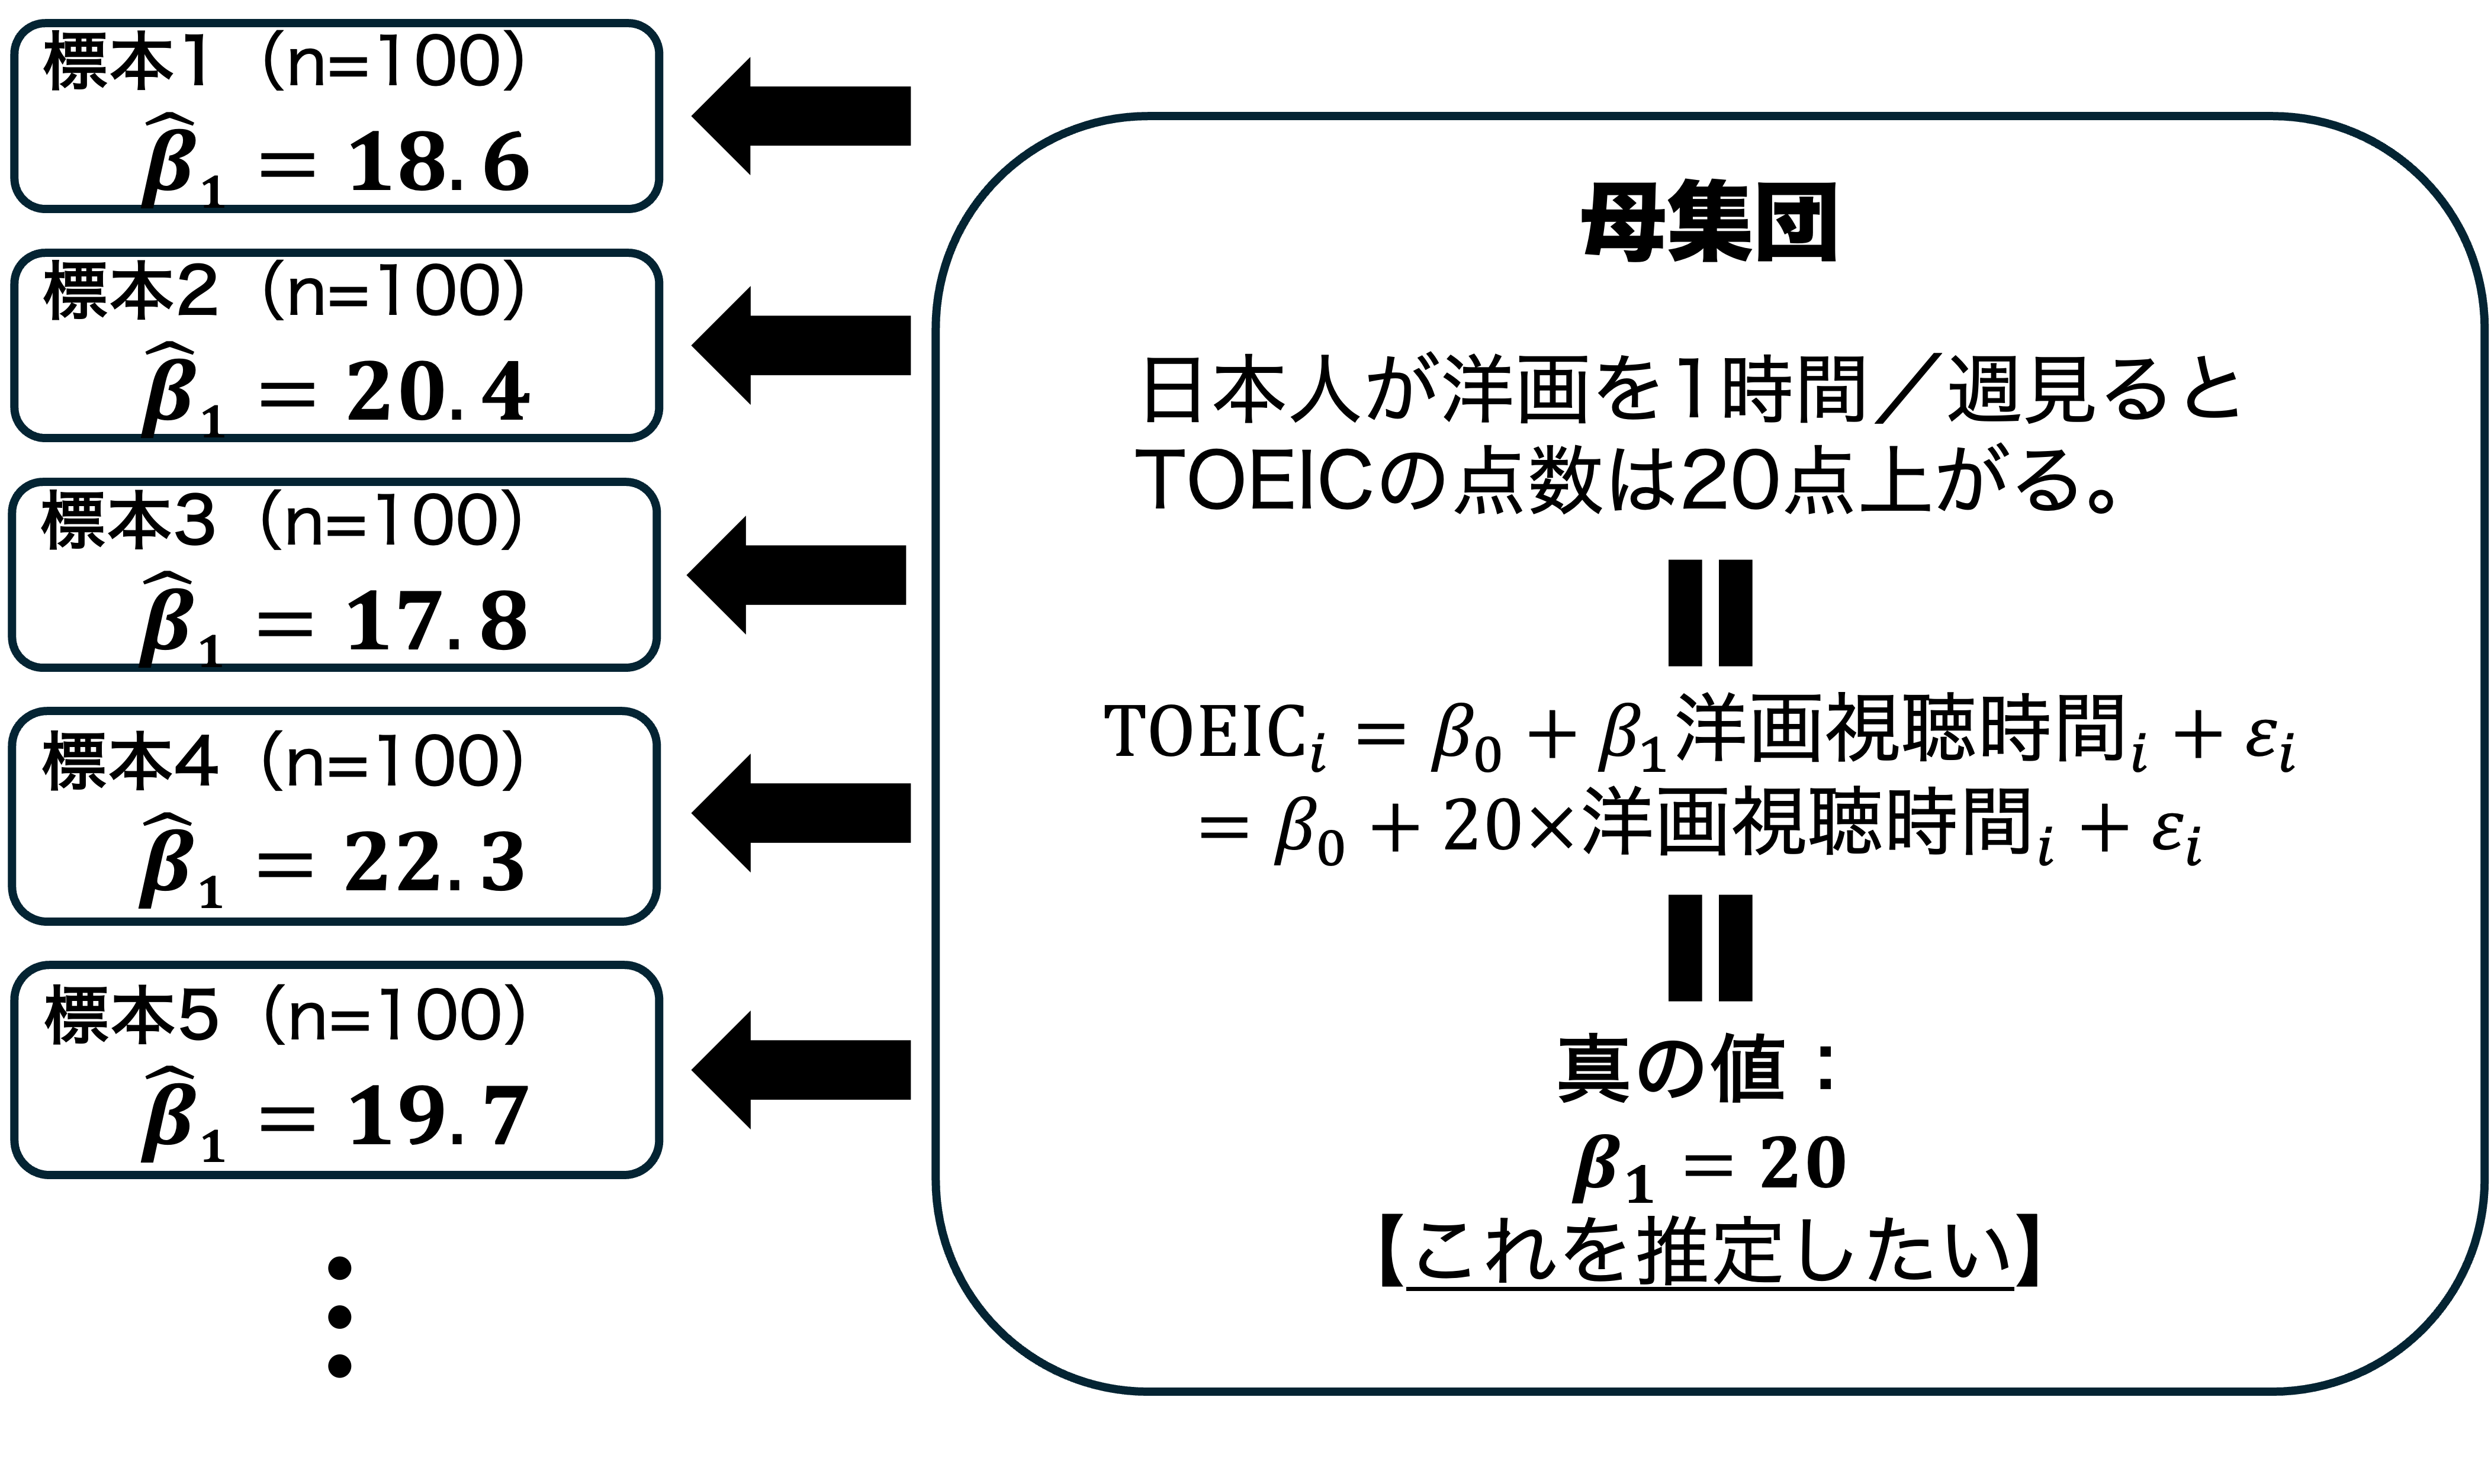
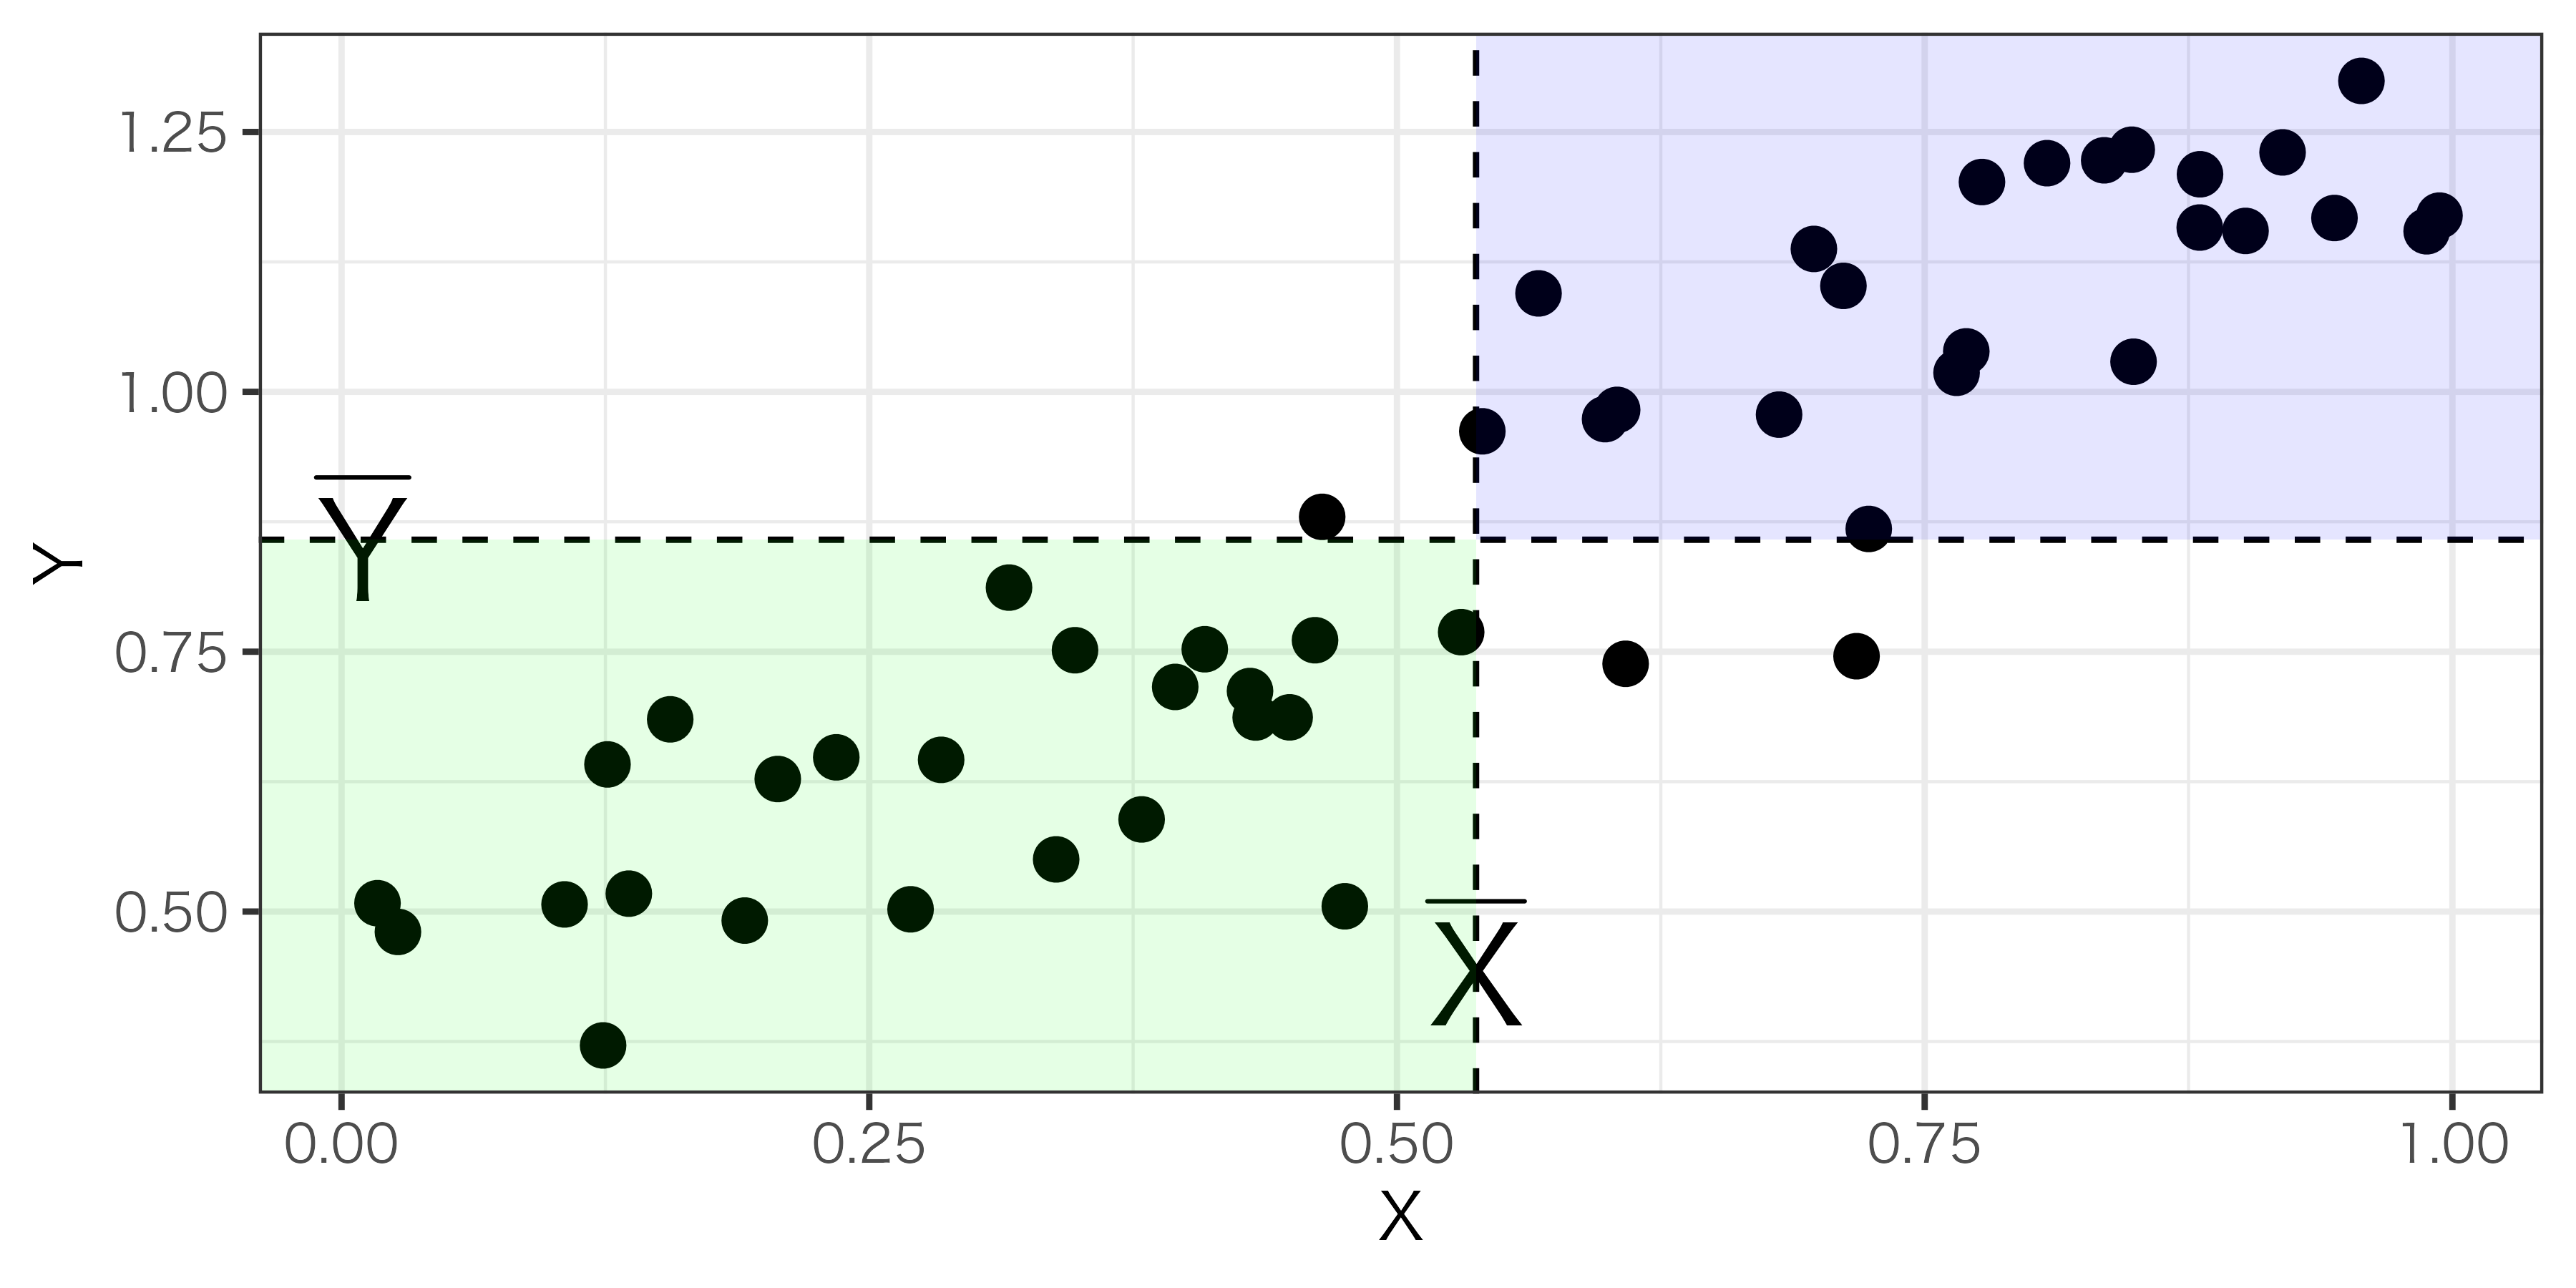
OLS推定値\(\hat{\beta_{1}}\)はランダム性を持つ=確率変数である

  • 正規分布にしたがう(後述)

\(\hat{\beta_{1}}\)のランダム性の原因

  1. サンプリングによるランダム性
  2. モデル化されたランダム性(割愛)

サンプリングによるランダム性

OLSの不偏性

OLSの不偏性

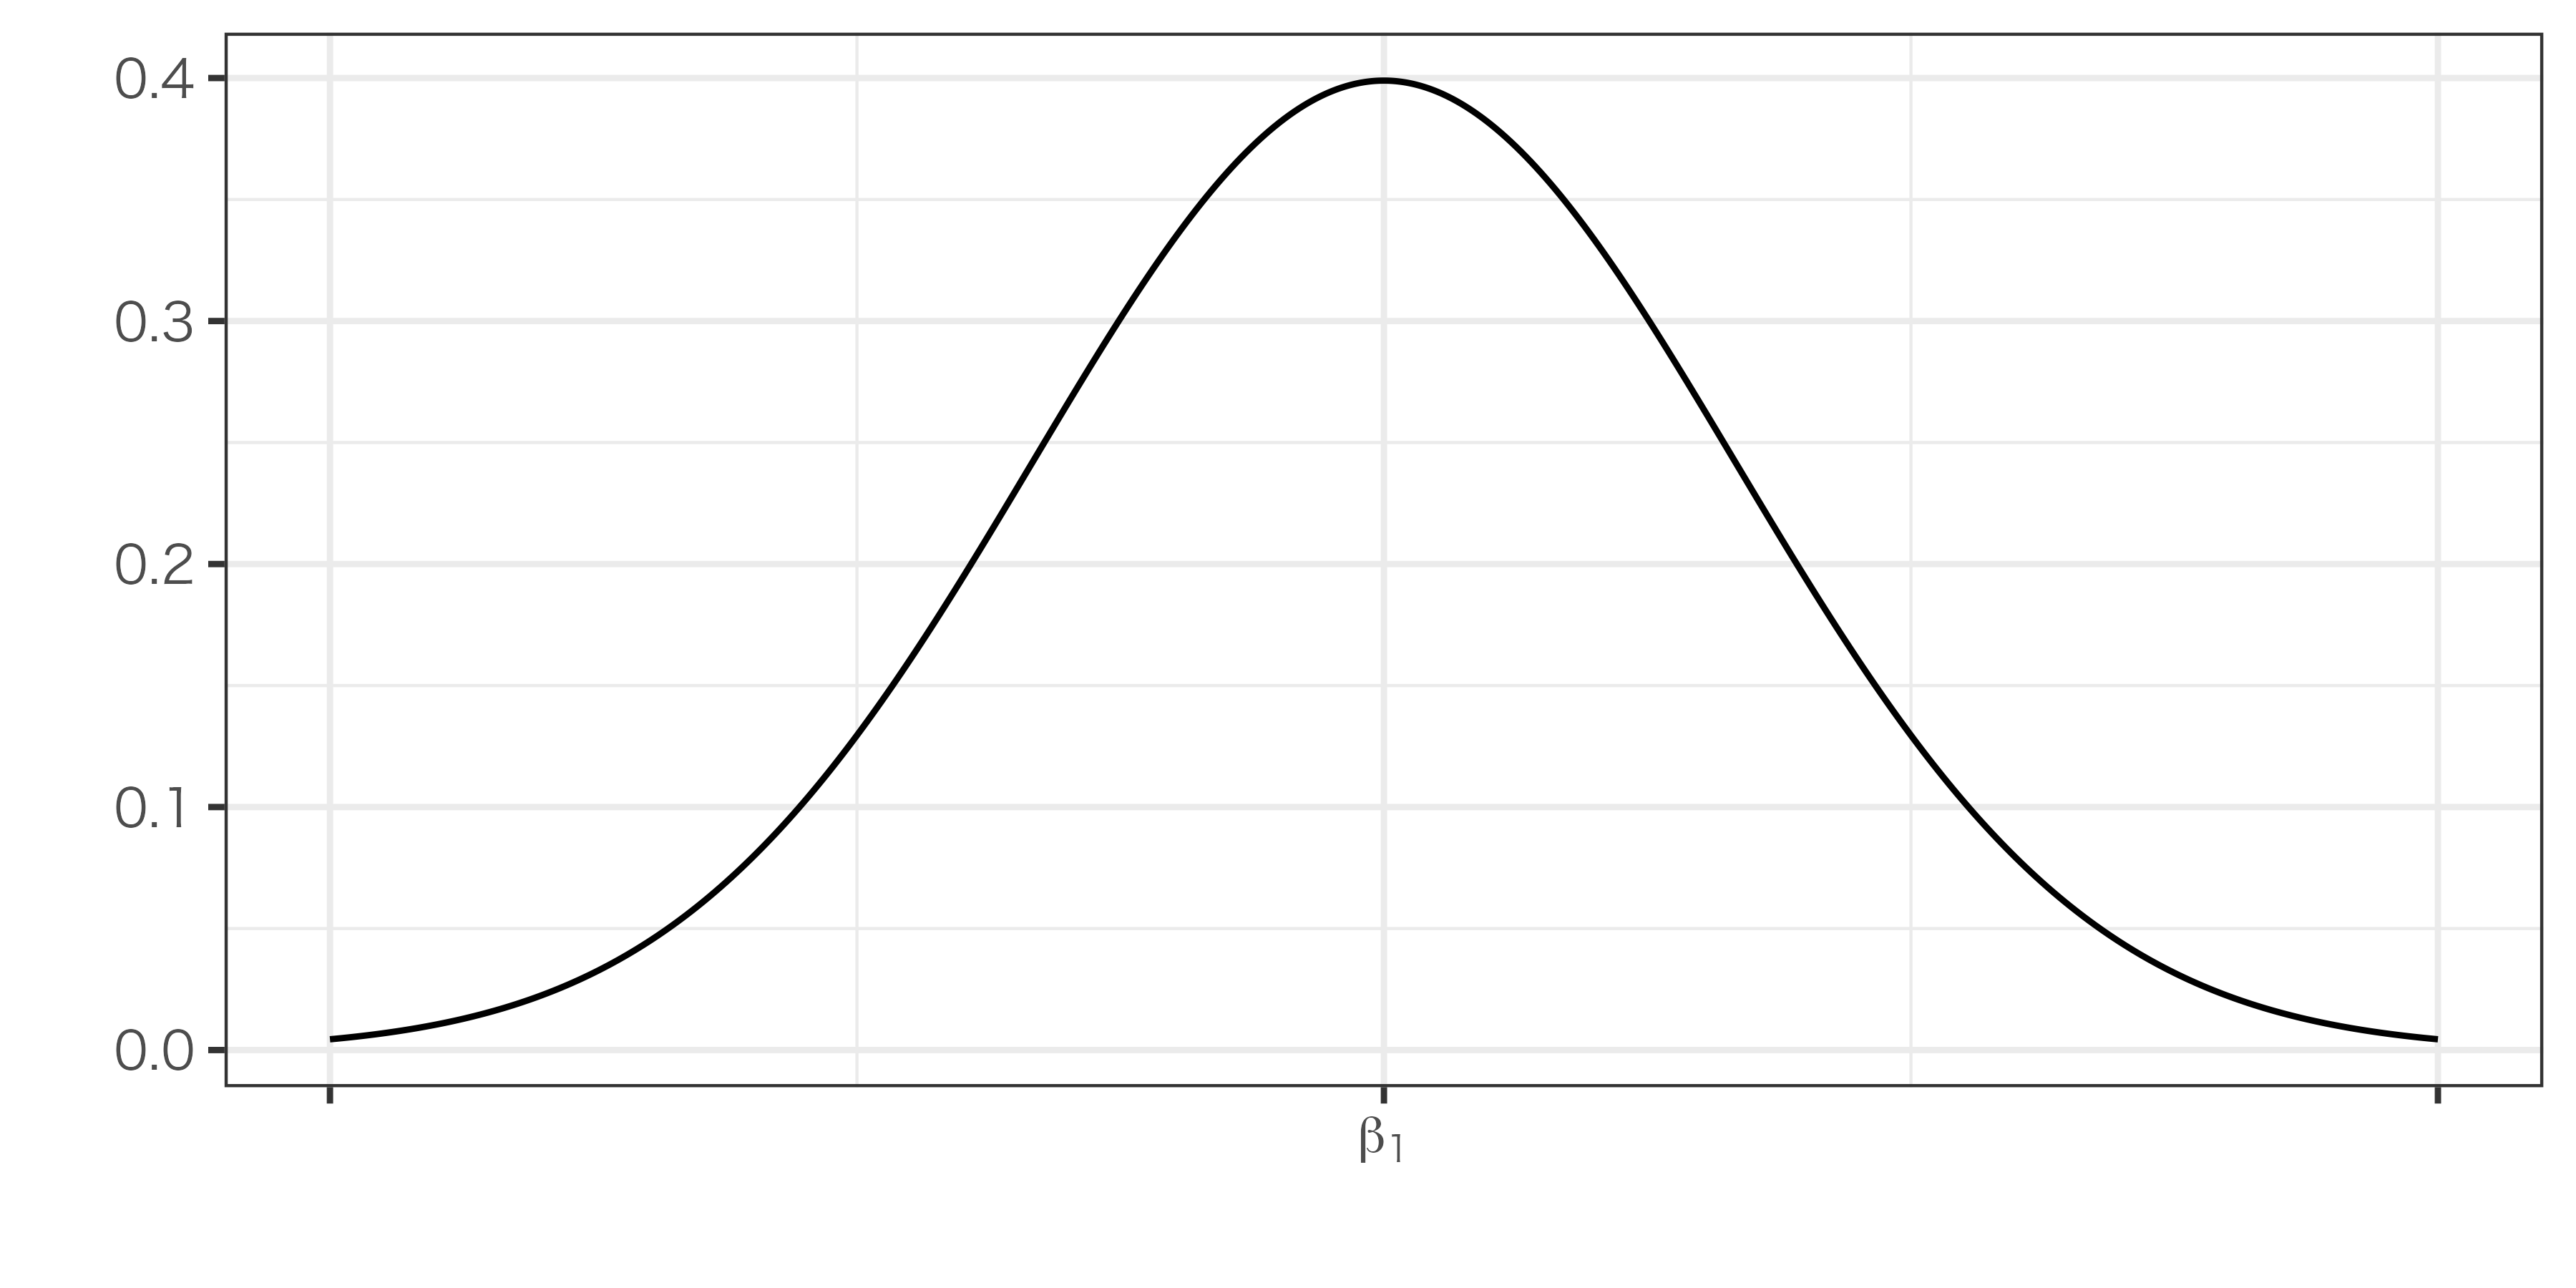
\(X\)と\(\varepsilon\)が無相関のとき(=内生性がないとき)、\(\hat{\beta}_{1}\)は真の値\(\beta_{1}\)の不偏推定量である。
OLSのバイアス

\(X\)と\(\varepsilon\)に相関があるとき(=内生性があるとき)、\(\hat{\beta}_{1}\)にはバイアス(偏り)が生じる

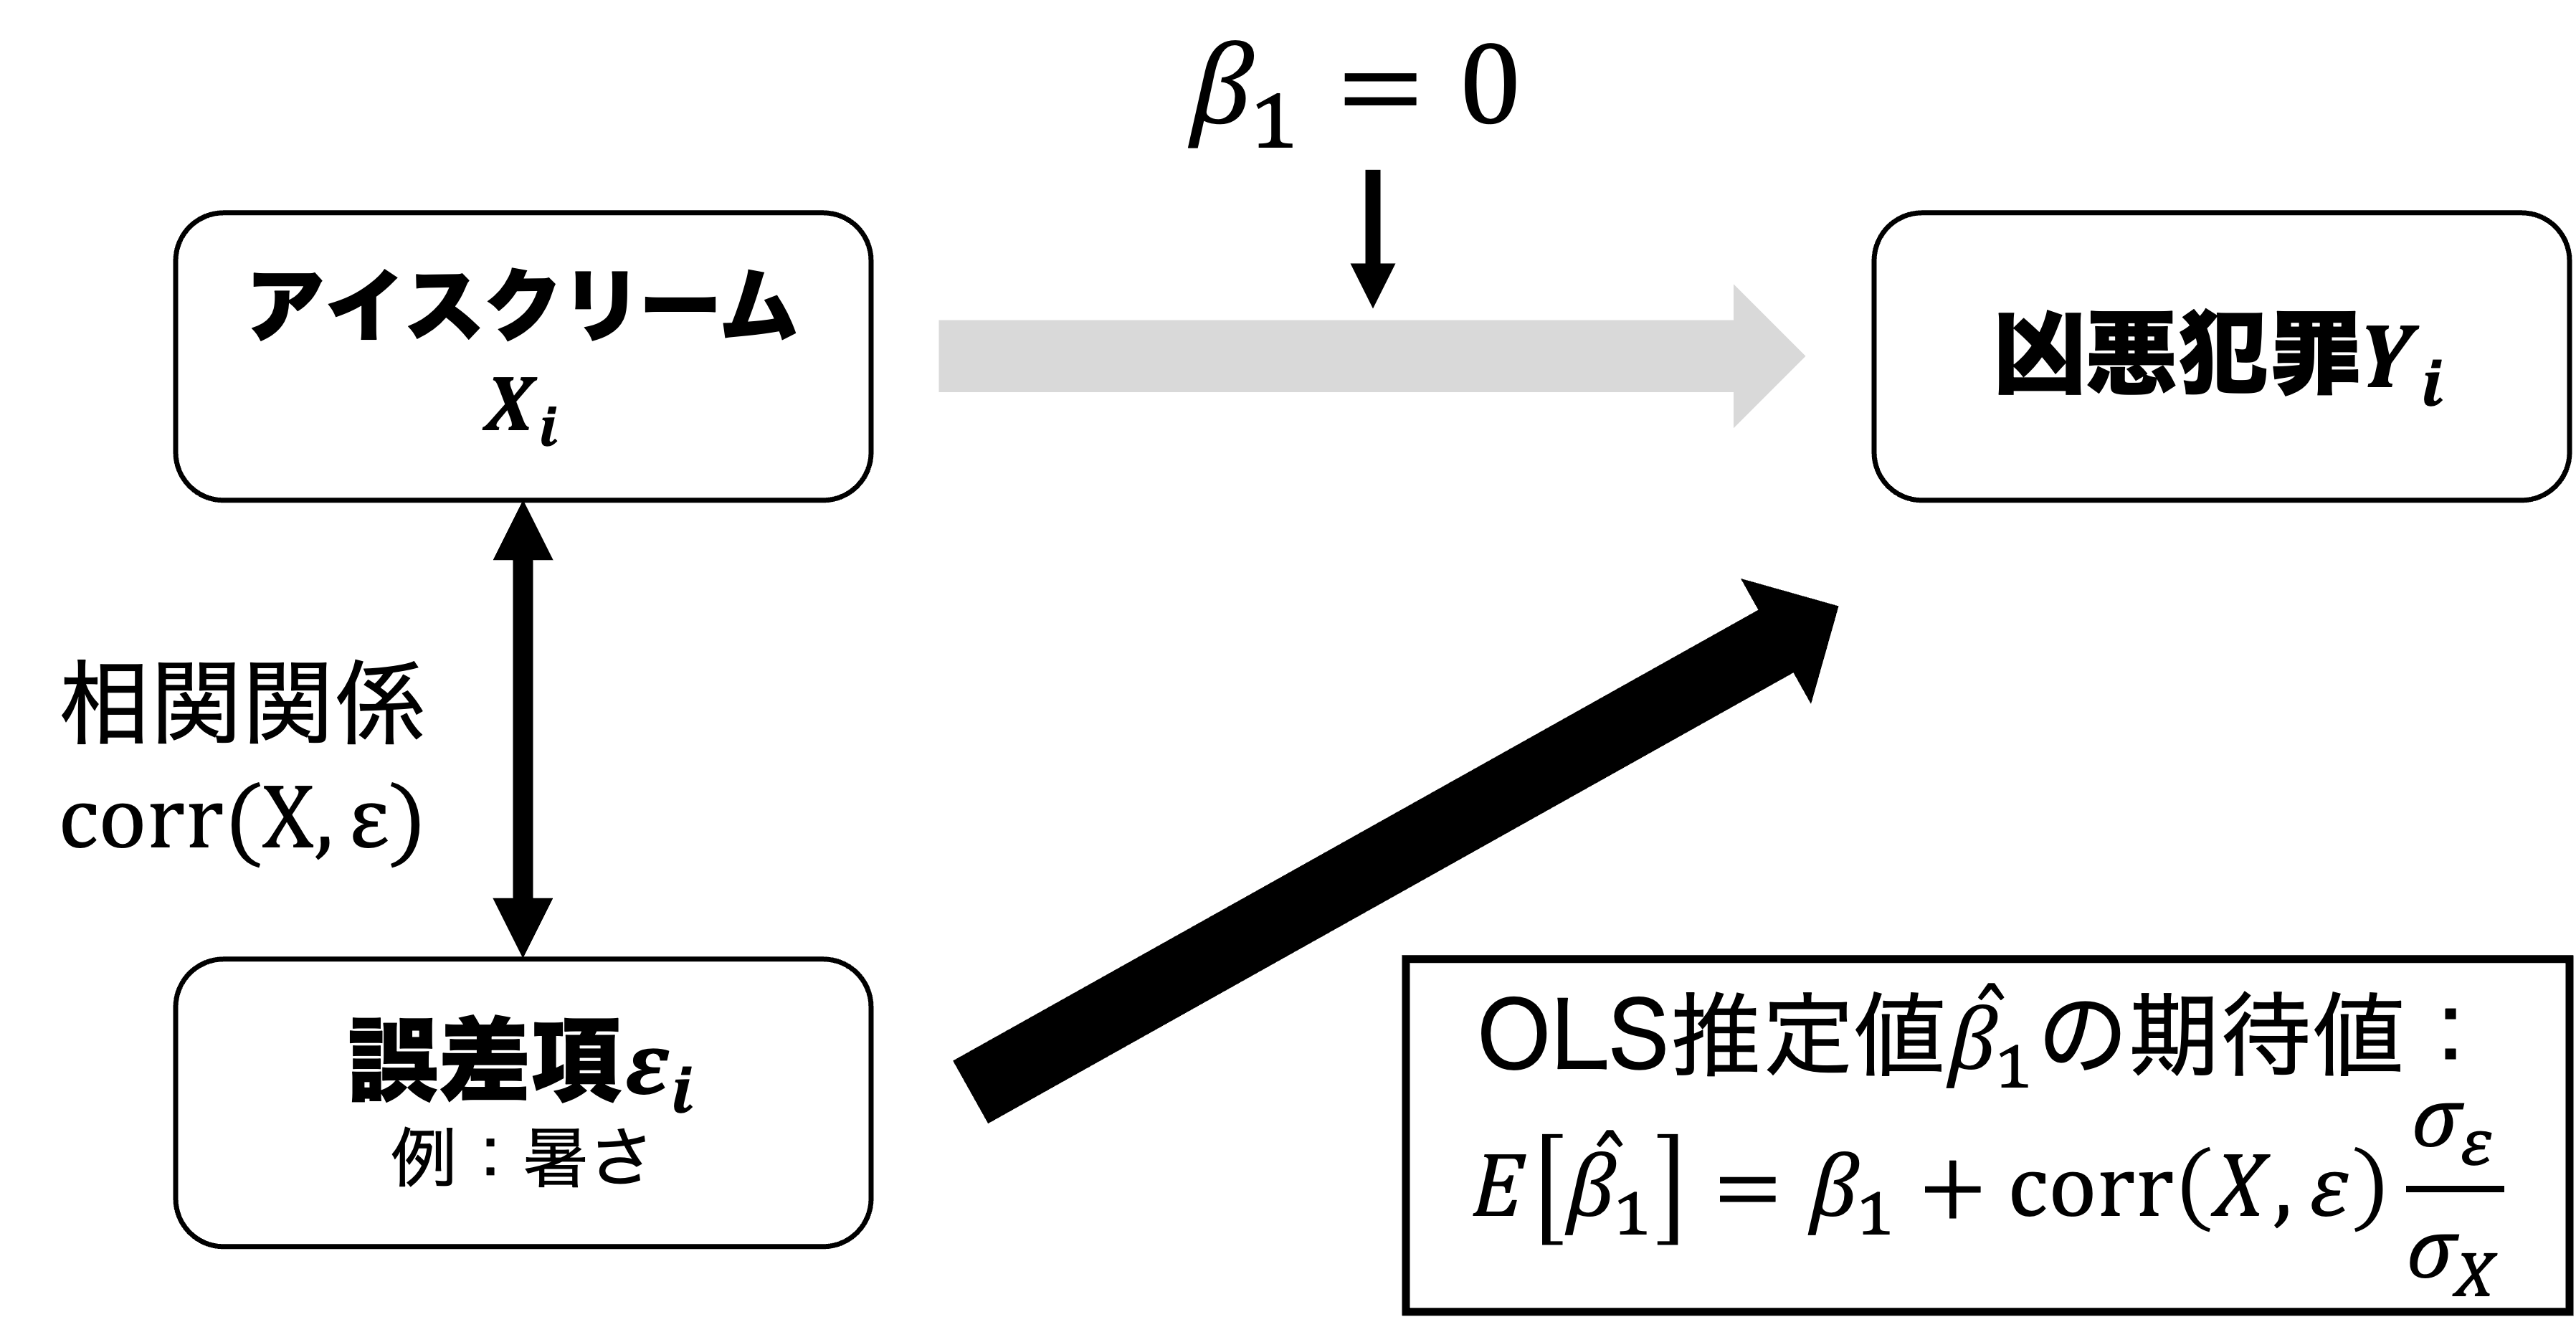
\(\hat{\beta_{1}}\)の期待値:\(E[\hat{\beta_{1}}]=\beta_{1}+\text{corr}(X, \varepsilon)\frac{\sigma_{\varepsilon}}{\sigma_{X}}\)

  • 第2項\(\text{corr}(X, \varepsilon)\frac{\sigma_{\varepsilon}}{\sigma_{X}}\)がバイアス
    • \(\text{corr}(X, \varepsilon)\):\(X\)と\(\varepsilon\)との相関
  • バイアスのパターン
    • \(\text{corr}(X, \varepsilon)>0\)(正の相関)→\(\beta_{1}\)が過大推定
    • \(\text{corr}(X, \varepsilon)<0\)(負の相関)→\(\beta_{1}\)が過小推定
    • \(\text{corr}(X, \varepsilon)=0\)(無相関)→\(\beta_{1}\)は正確に推定(=バイアスなし)

例:凶悪犯罪とアイスクリームの売上

Q. 暑いほどアイスクリームが売れる時、OLS推定値\(\hat{\beta}_{1}\)は真値\(\beta_{1}=0\)よりも大きくなる?それとも小さくなる?
まとめ

本日の目的と到達目標

目的

回帰分析の最も基本的な形である二変量モデルを紹介する。基本となる統計モデルについて復習した後に、回帰分析によって回帰係数を推定し、その推定値を因果効果として解釈するための基本的な方法として、最小二乗法(OLS)を学ぶ。確率分布の基本を学んだ後、OLSで得られた因果効果の推定量のランダム性を議論する。さらに内生性が推定結果をどのように歪めるのかについても検討する。

到達目標

  1. 二変量回帰モデル(\(Y_i=\beta_0+\beta_{1}X_{i}+\varepsilon_i\))の各項を説明できる。
  2. 仮想的な散布図を使って最小二乗法による回帰係数の推定を説明できる。
  3. 回帰係数の推定値\(\hat{\beta_{1}}\)の計算式を書き出し、その意味を説明できる。
  4. 回帰係数の推定値\(\hat{\beta_{1}}\)がランダム性を持つのはなぜかを説明できる。
  5. 回帰係数の推定値\(\hat{\beta_{1}}\)が不偏推定量であることの意味、そしてそれが成立する条件を説明できる。

次回までに

事後学習

事前学習

  • 教科書(第3章3.4-3.6: pp.86-98)を読む