08/統計的仮説検定:基本編

現代政治分析入門2

鈴木淳平

駒澤大学法学部政治学科

2026-11-17

出席登録をお願いします

演習の追加募集

  • まだ枠が十分あるので、追加募集
    • 11/12にKONECOでアナウンス
    • 11/20〜12/1が応募期間(Google Form)
  • Google Formと成績表提出(面接は行わない)
  • 詳細はKONECO参照
  • 本格的にRを学び、政治現象を計量的に研究

今日の目次

  1. はじめに
  2. 統計的仮説検定
  3. 第1種/第2種の過誤
  4. \(t\)検定
  5. \(p\)値
  6. まとめ

はじめに

本日の目的と到達目標

目的

統計的仮説検定の枠組みを学ぶ。仮説検定の基本的な手順を紹介し、帰無仮説や対立仮説、第1種/第2種の過誤など基本的な概念を習得する。続いてOLS推定値における仮説検定である\(t\)検定の手順について学び、その中でも最も重要な\(p\)値という概念を理解する。

到達目標

  1. 帰無仮説・対立仮説・有意水準という言葉を用いて、統計的仮説検定の基本的な手順を説明できる。
  2. 第1種/第2種の過誤の違いと、両者の関係を説明できる。
  3. OLSの係数と標準誤差に言及しつつ、\(t\)検定の基本的な考え方を説明できる。
  4. \(p\)値の意味を説明し、それを用いて統計的有意性を判断できる。
  5. OLSの推定結果から統計的有意性を判断し、その結果を適切に解釈できる。

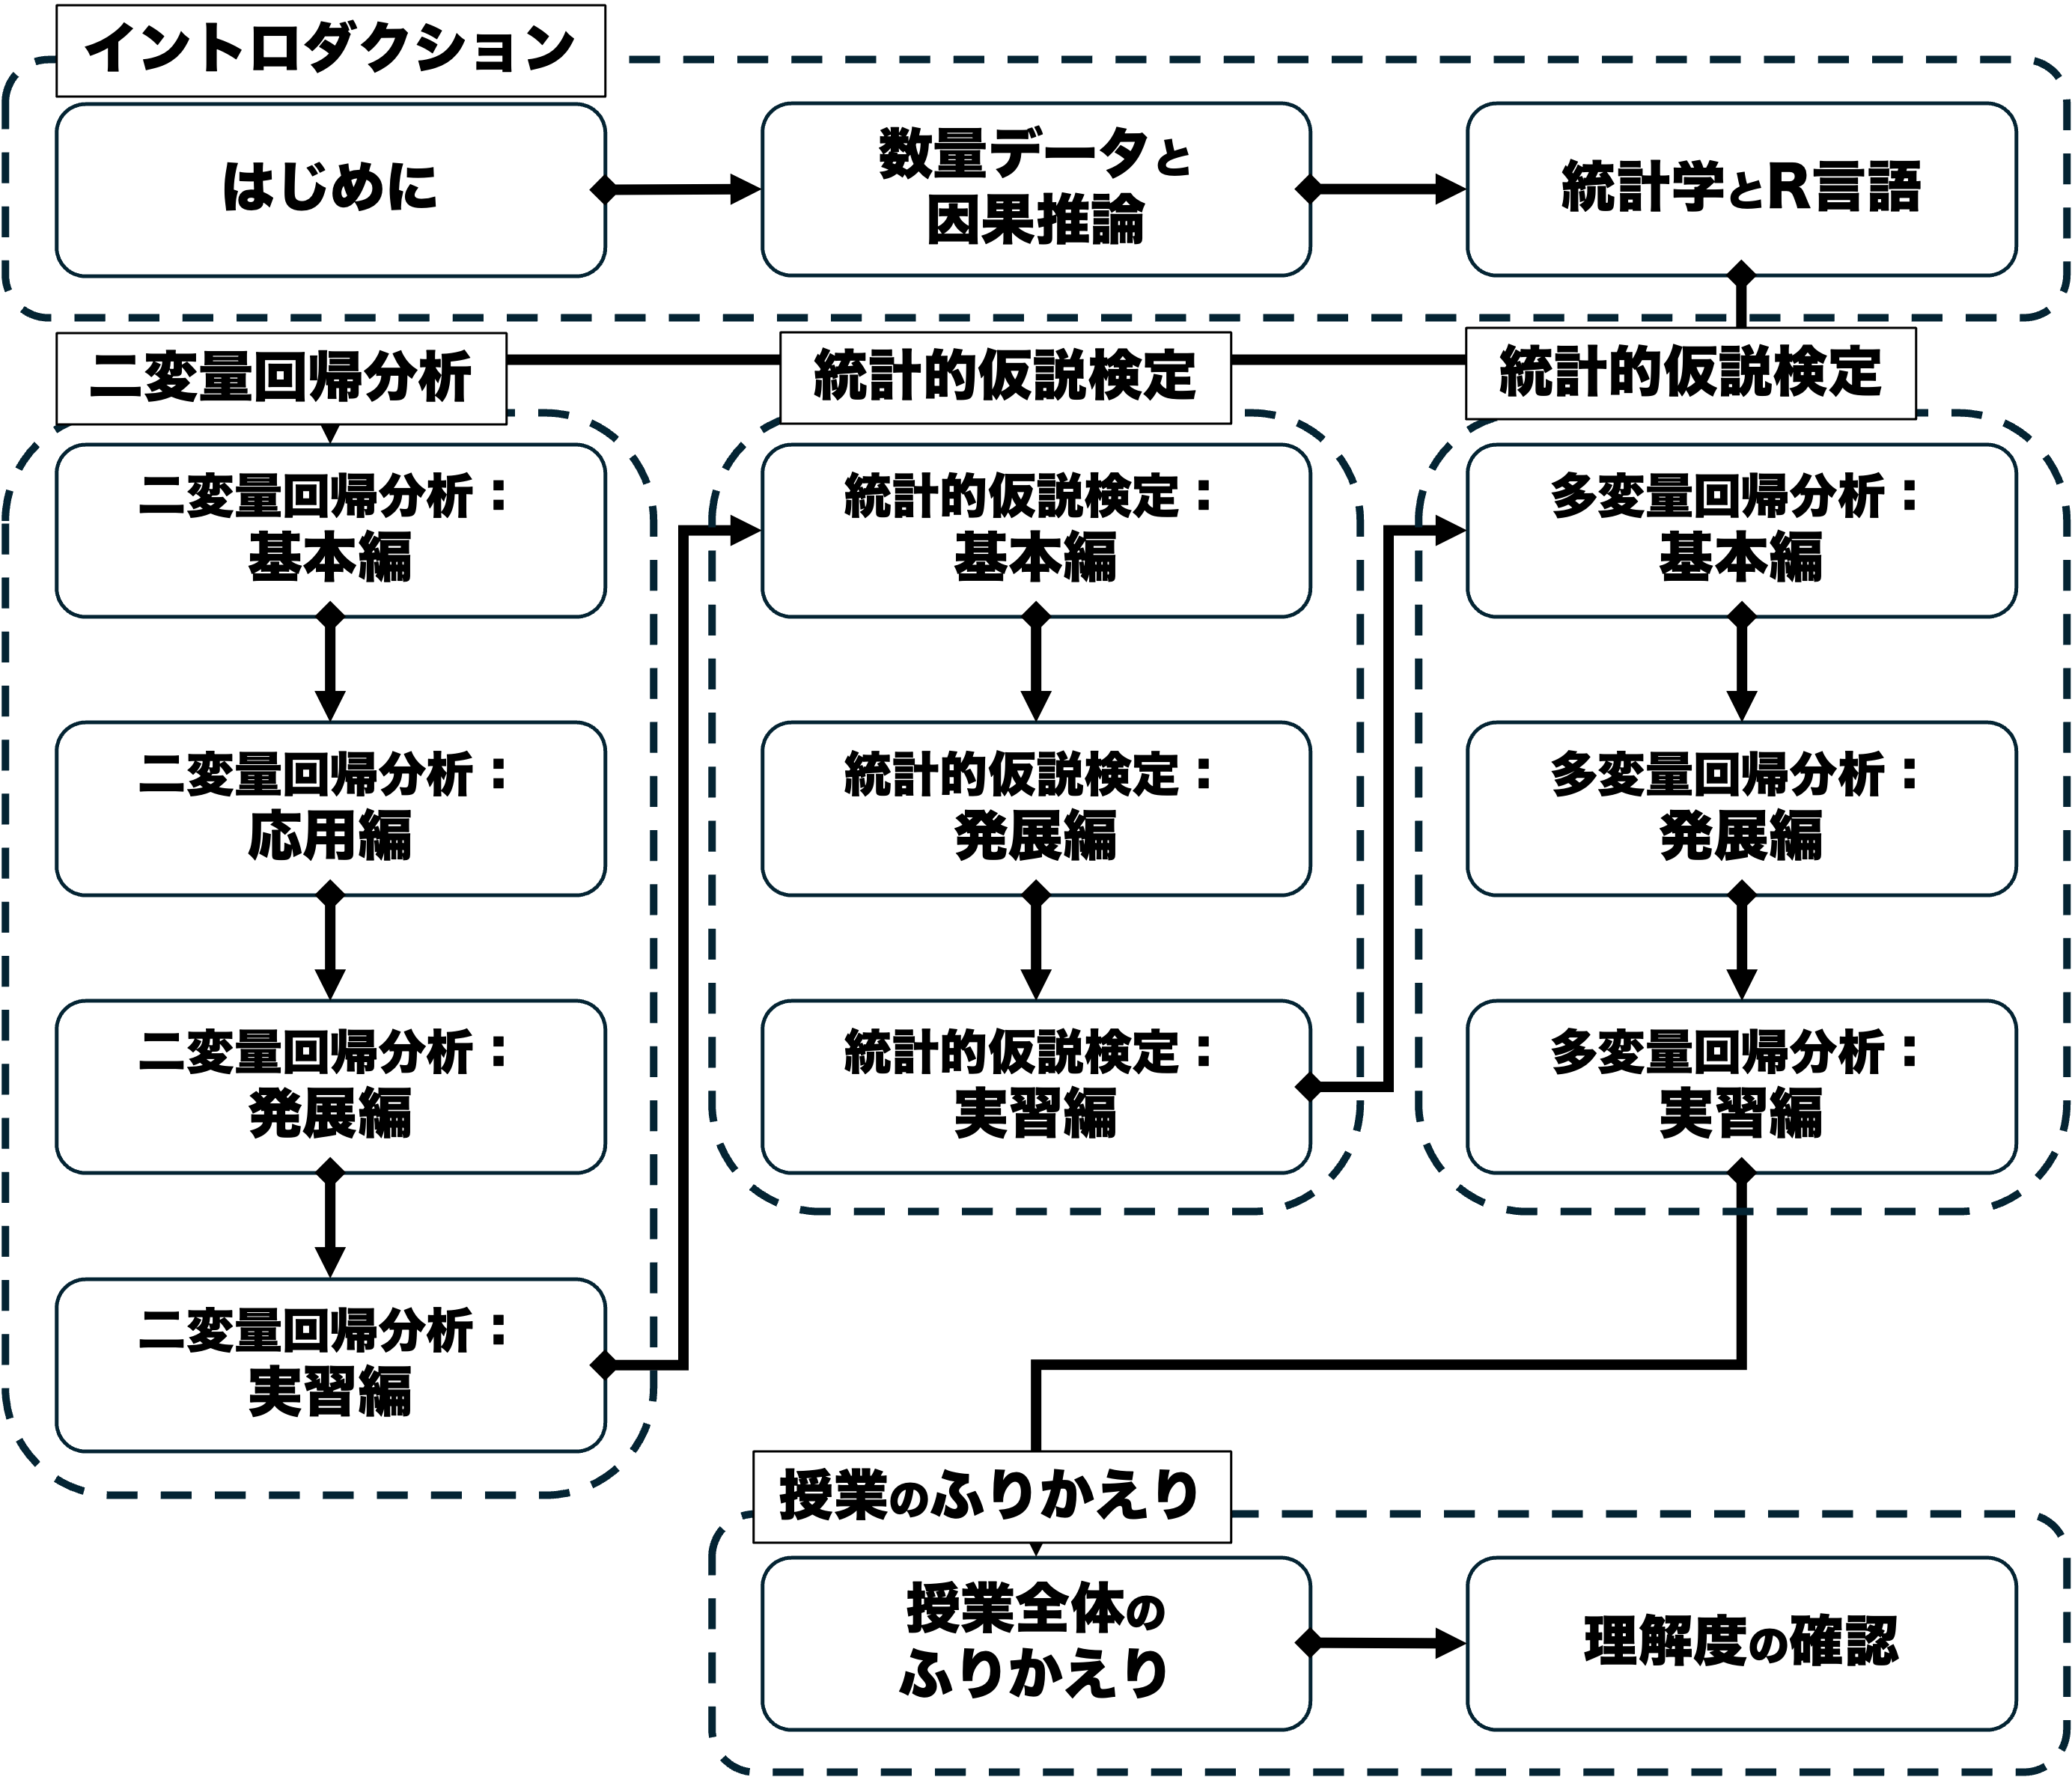
本日の授業の位置付け

小テストの講評

  • 受験者数192人
  • 平均6.92/8点
  • 標準偏差2.65点
  • 最小値0点
  • 最大値8点

まあまあよくできましたが、問2・6・8は注意(→正答)

  • サンプルコード(第7回実習課題のコード)はWebClassにもあります

統計的仮説検定

例:身長と賃金

身長が高いほど賃金は上がるのだろうか。100人の日本人のデータ1を集めて以下のモデルを推定してみよう。

\[ 賃金_{i}=\beta_{0}+\beta_{1}身長_{i}+\varepsilon_{i} \]

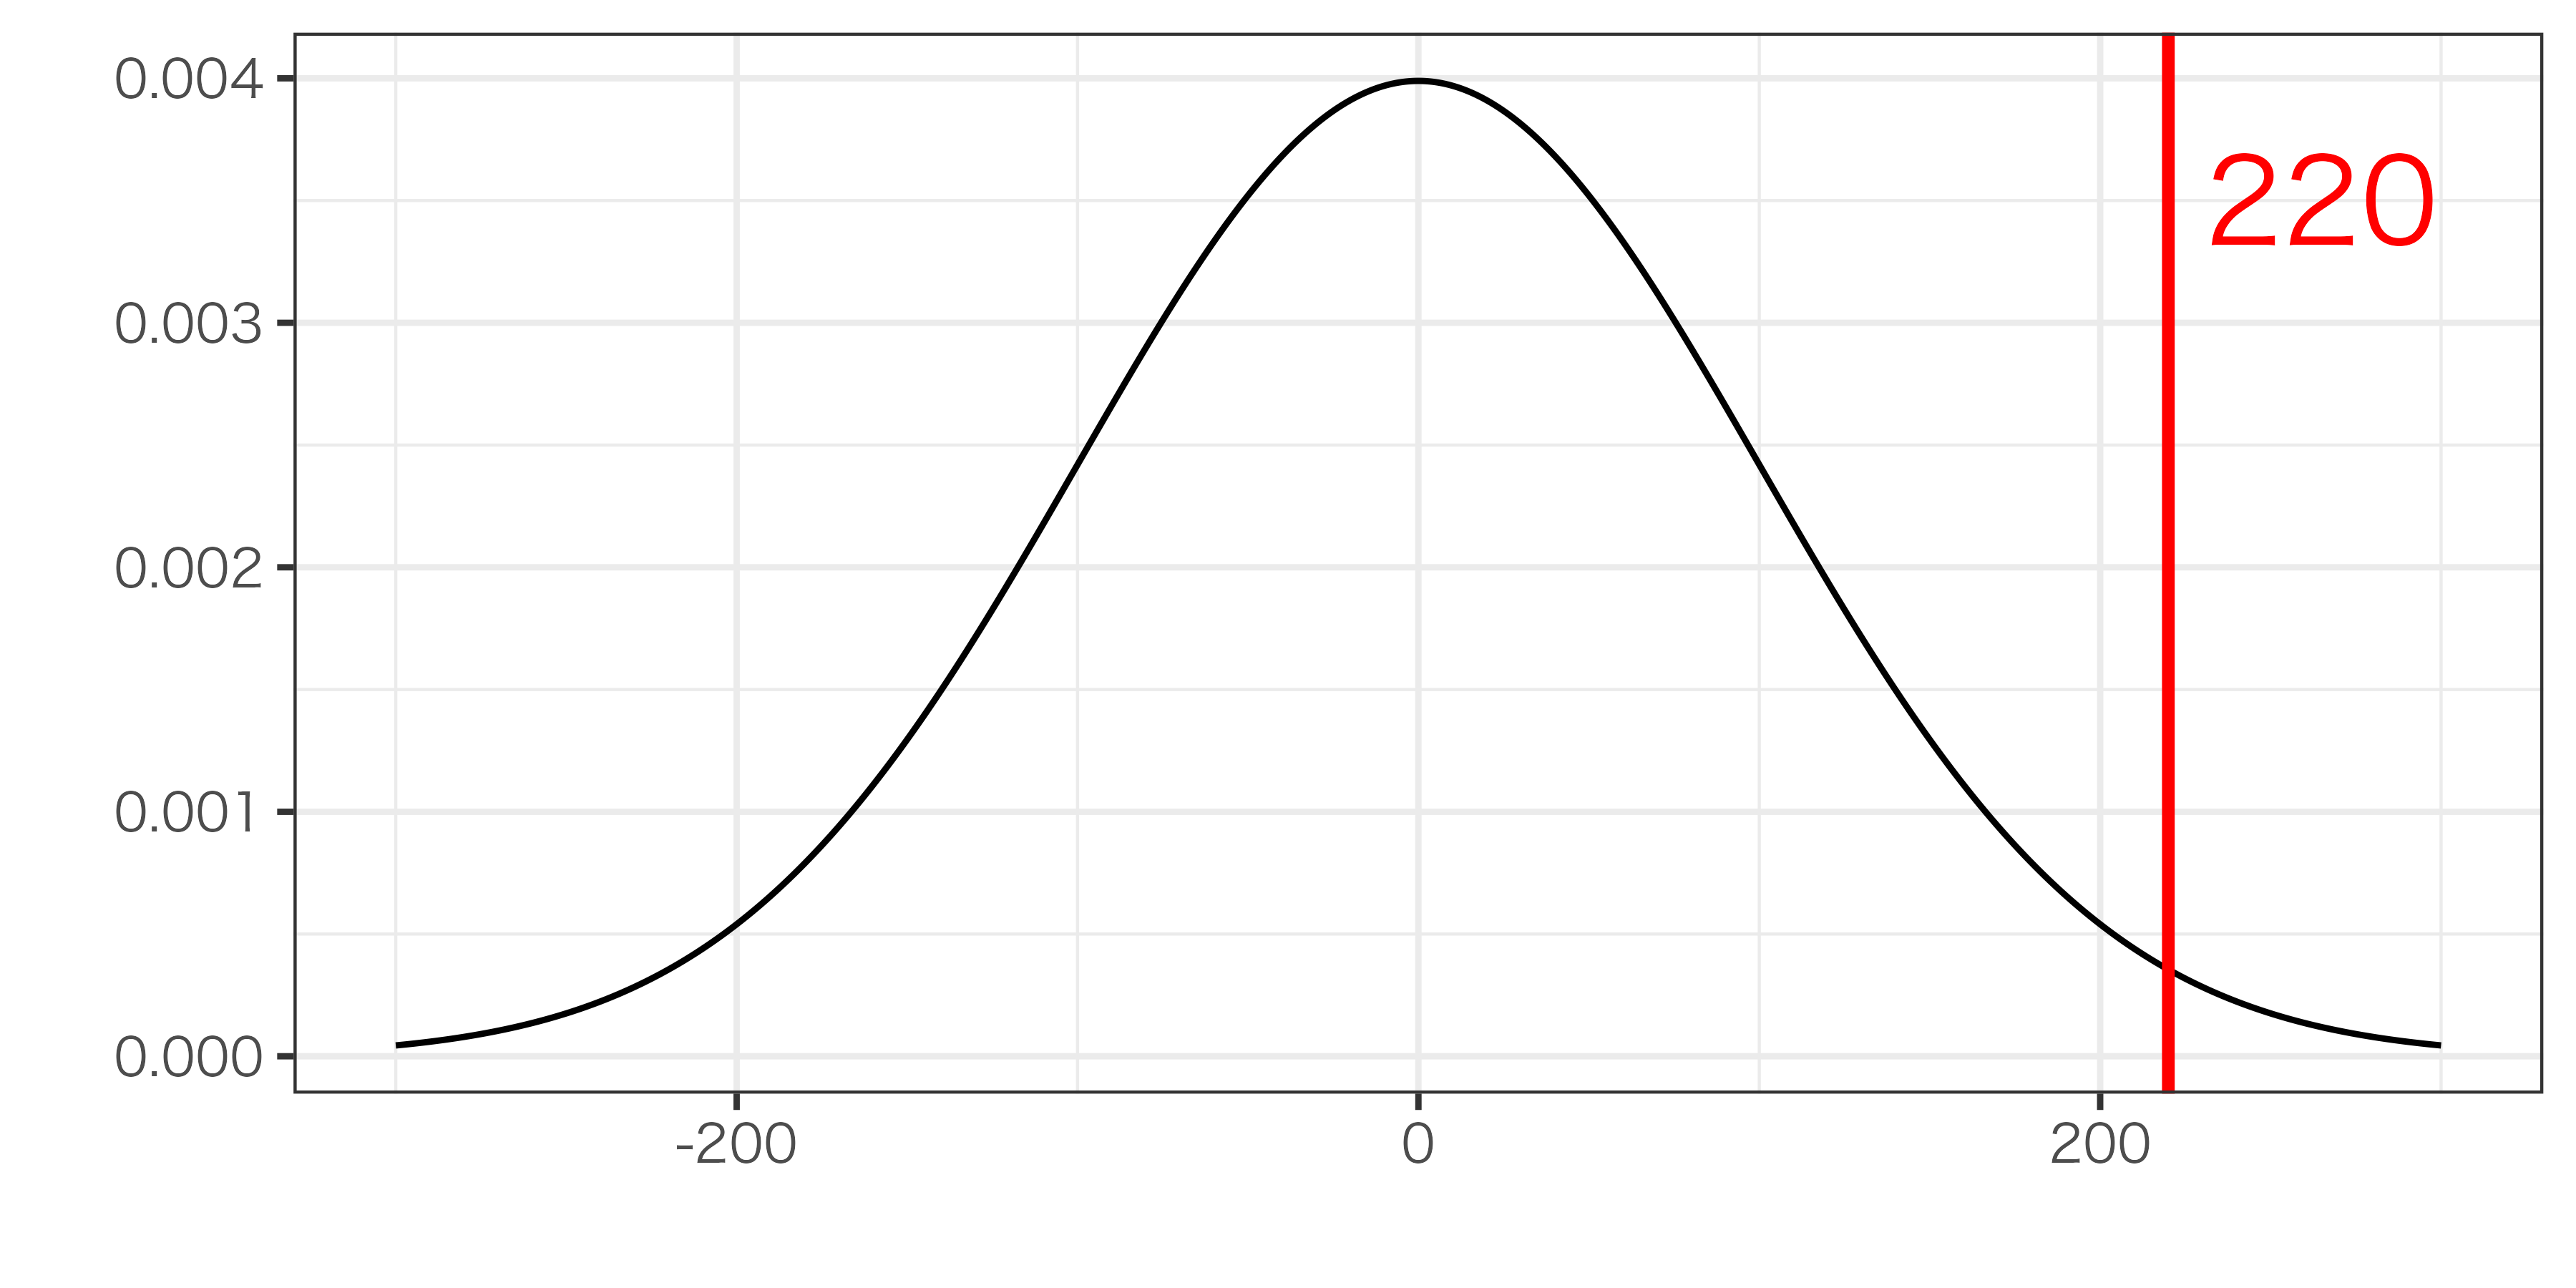
OLS推定をしたところ、傾きの推定値は\(\hat{\beta}_{1}=220\)となった。

身長が高くなるほど賃金も上がる、と結論づけて良いだろうか?(内生性はないとする)(WebClassチャット)

統計的仮説検定 (hypothesis testing)

ある仮説が正しいかどうかを統計的に判断する枠組み

  1. 帰無仮説を定める
    • 「身長は賃金に影響を与えない」(\(H_{0}:\beta_{1}=0\))
  2. 対立仮説を定める
    • 「身長は賃金に影響を与える」(\(H_{1}:\beta_{1}\ne0\))
  3. 帰無仮説が正しいと仮定したときに、推定された\(\hat{\beta}_{1}\)がどれだけ出やすいかを検討
    • \(\hat{\beta}_{1}\)が0から離れている→帰無仮説が正しいとしたら出そうにない→帰無仮説を棄却(対立仮説を採択)
    • \(\hat{\beta}_{1}\)が0に近い→帰無仮説が正しいとしたら普通にあり得る→帰無仮説は棄却できない(対立仮説を棄却)

仮説検定と正規分布

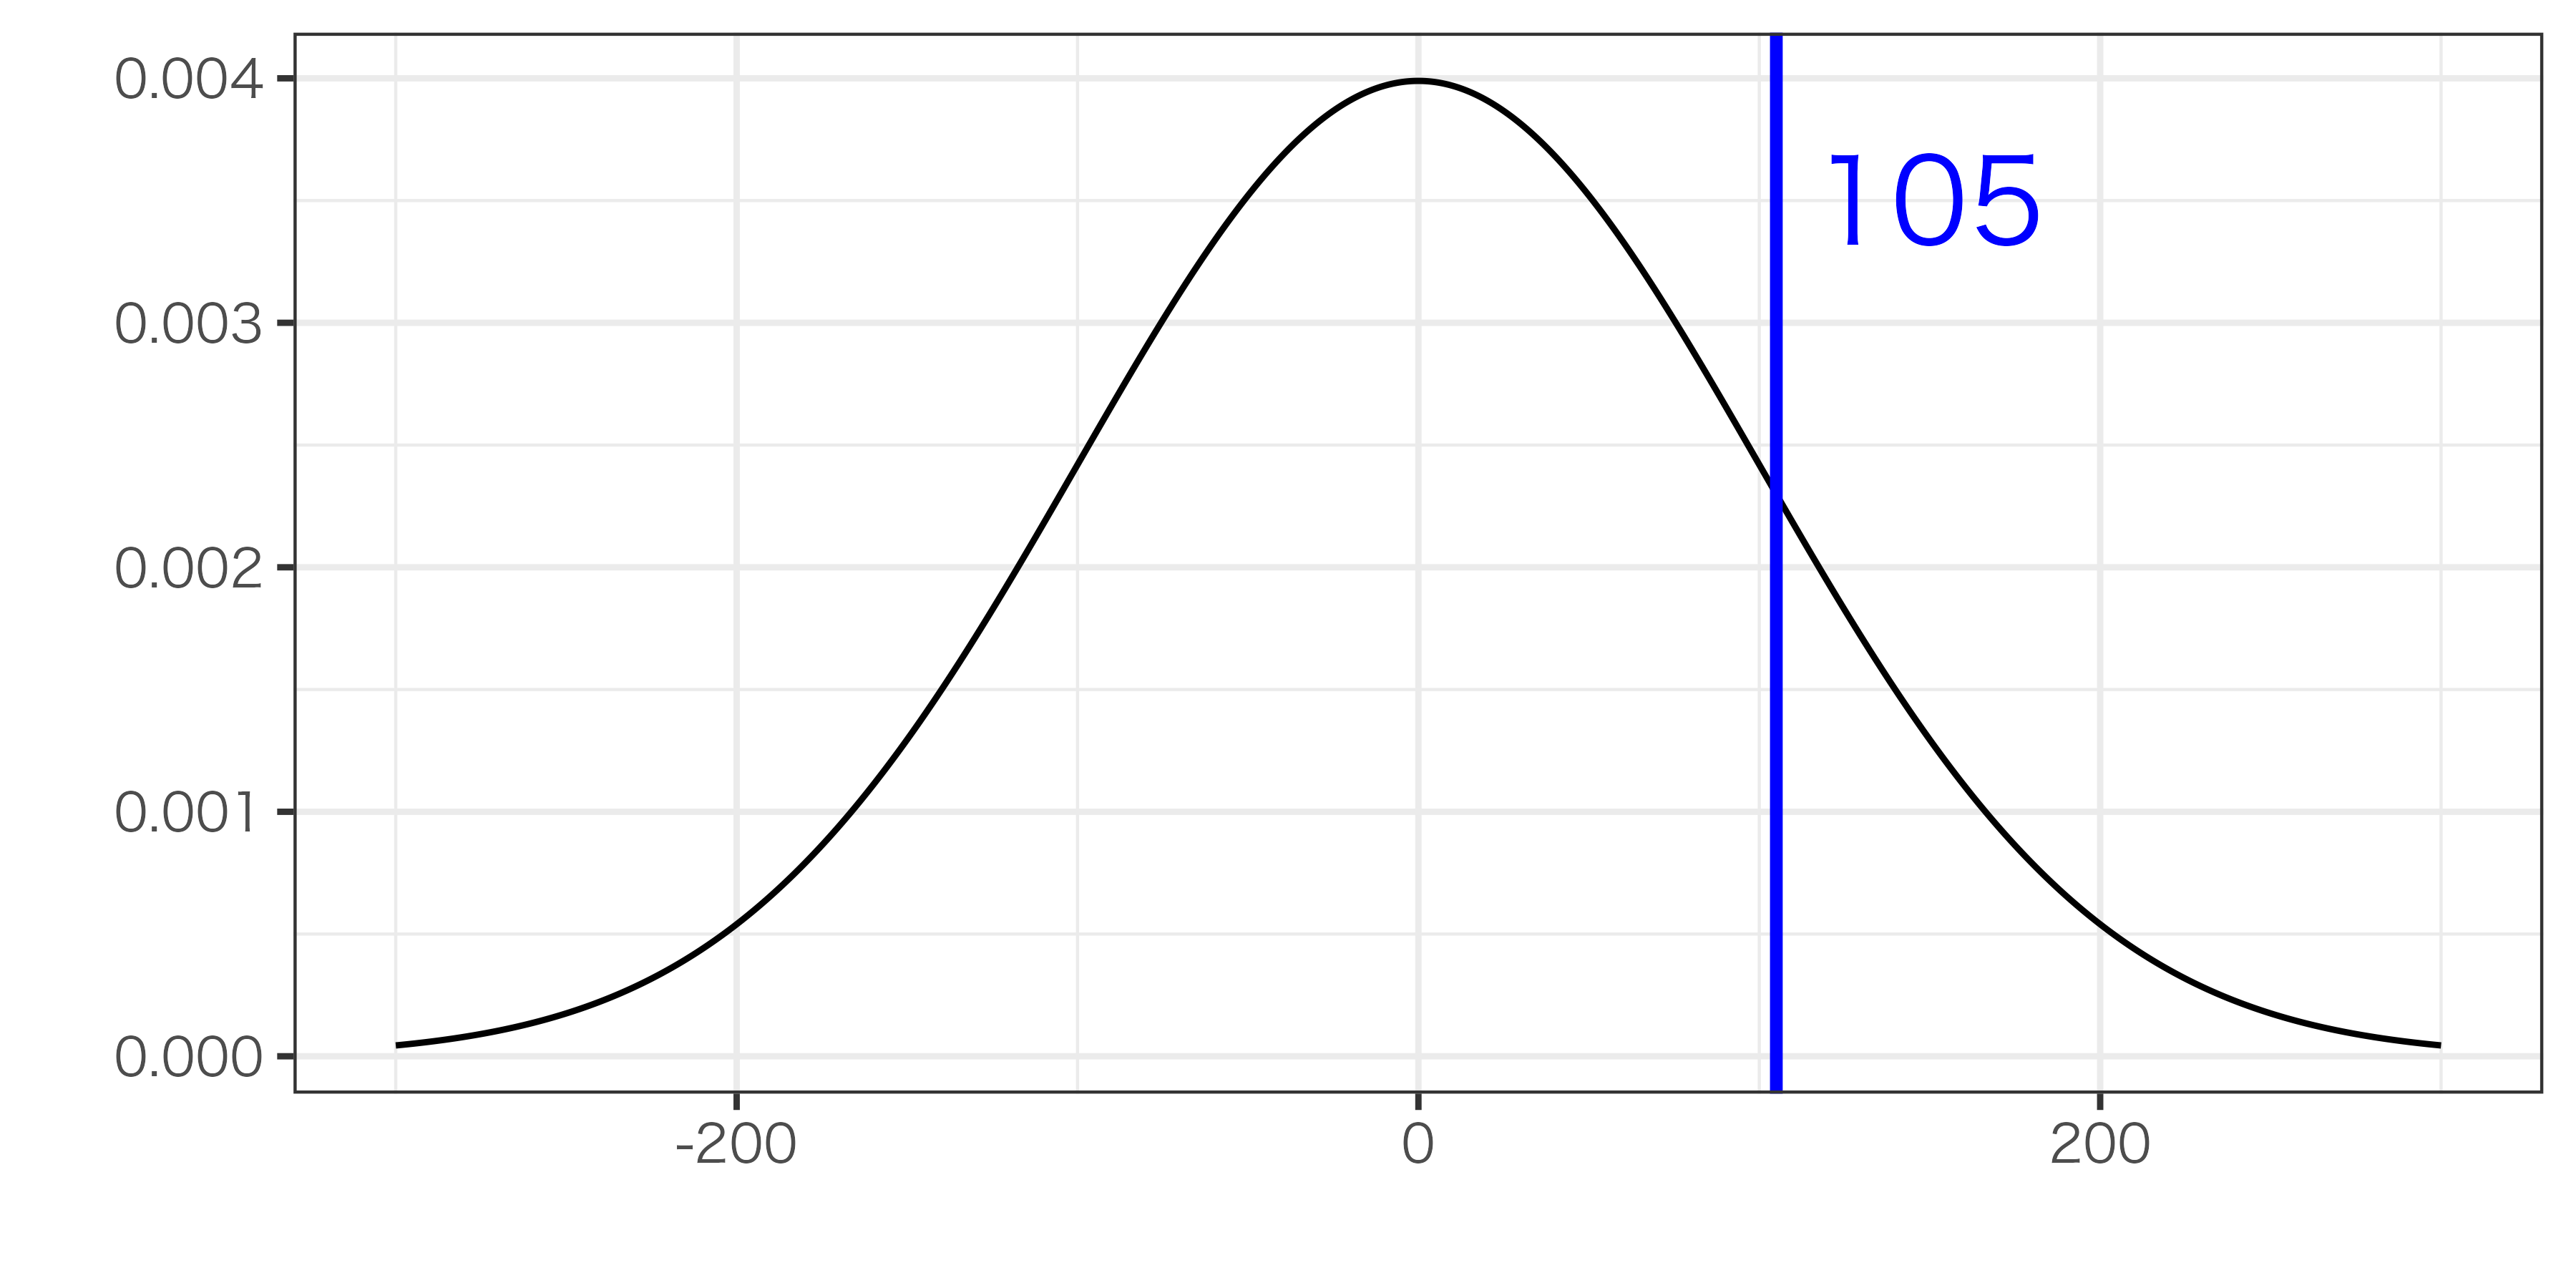
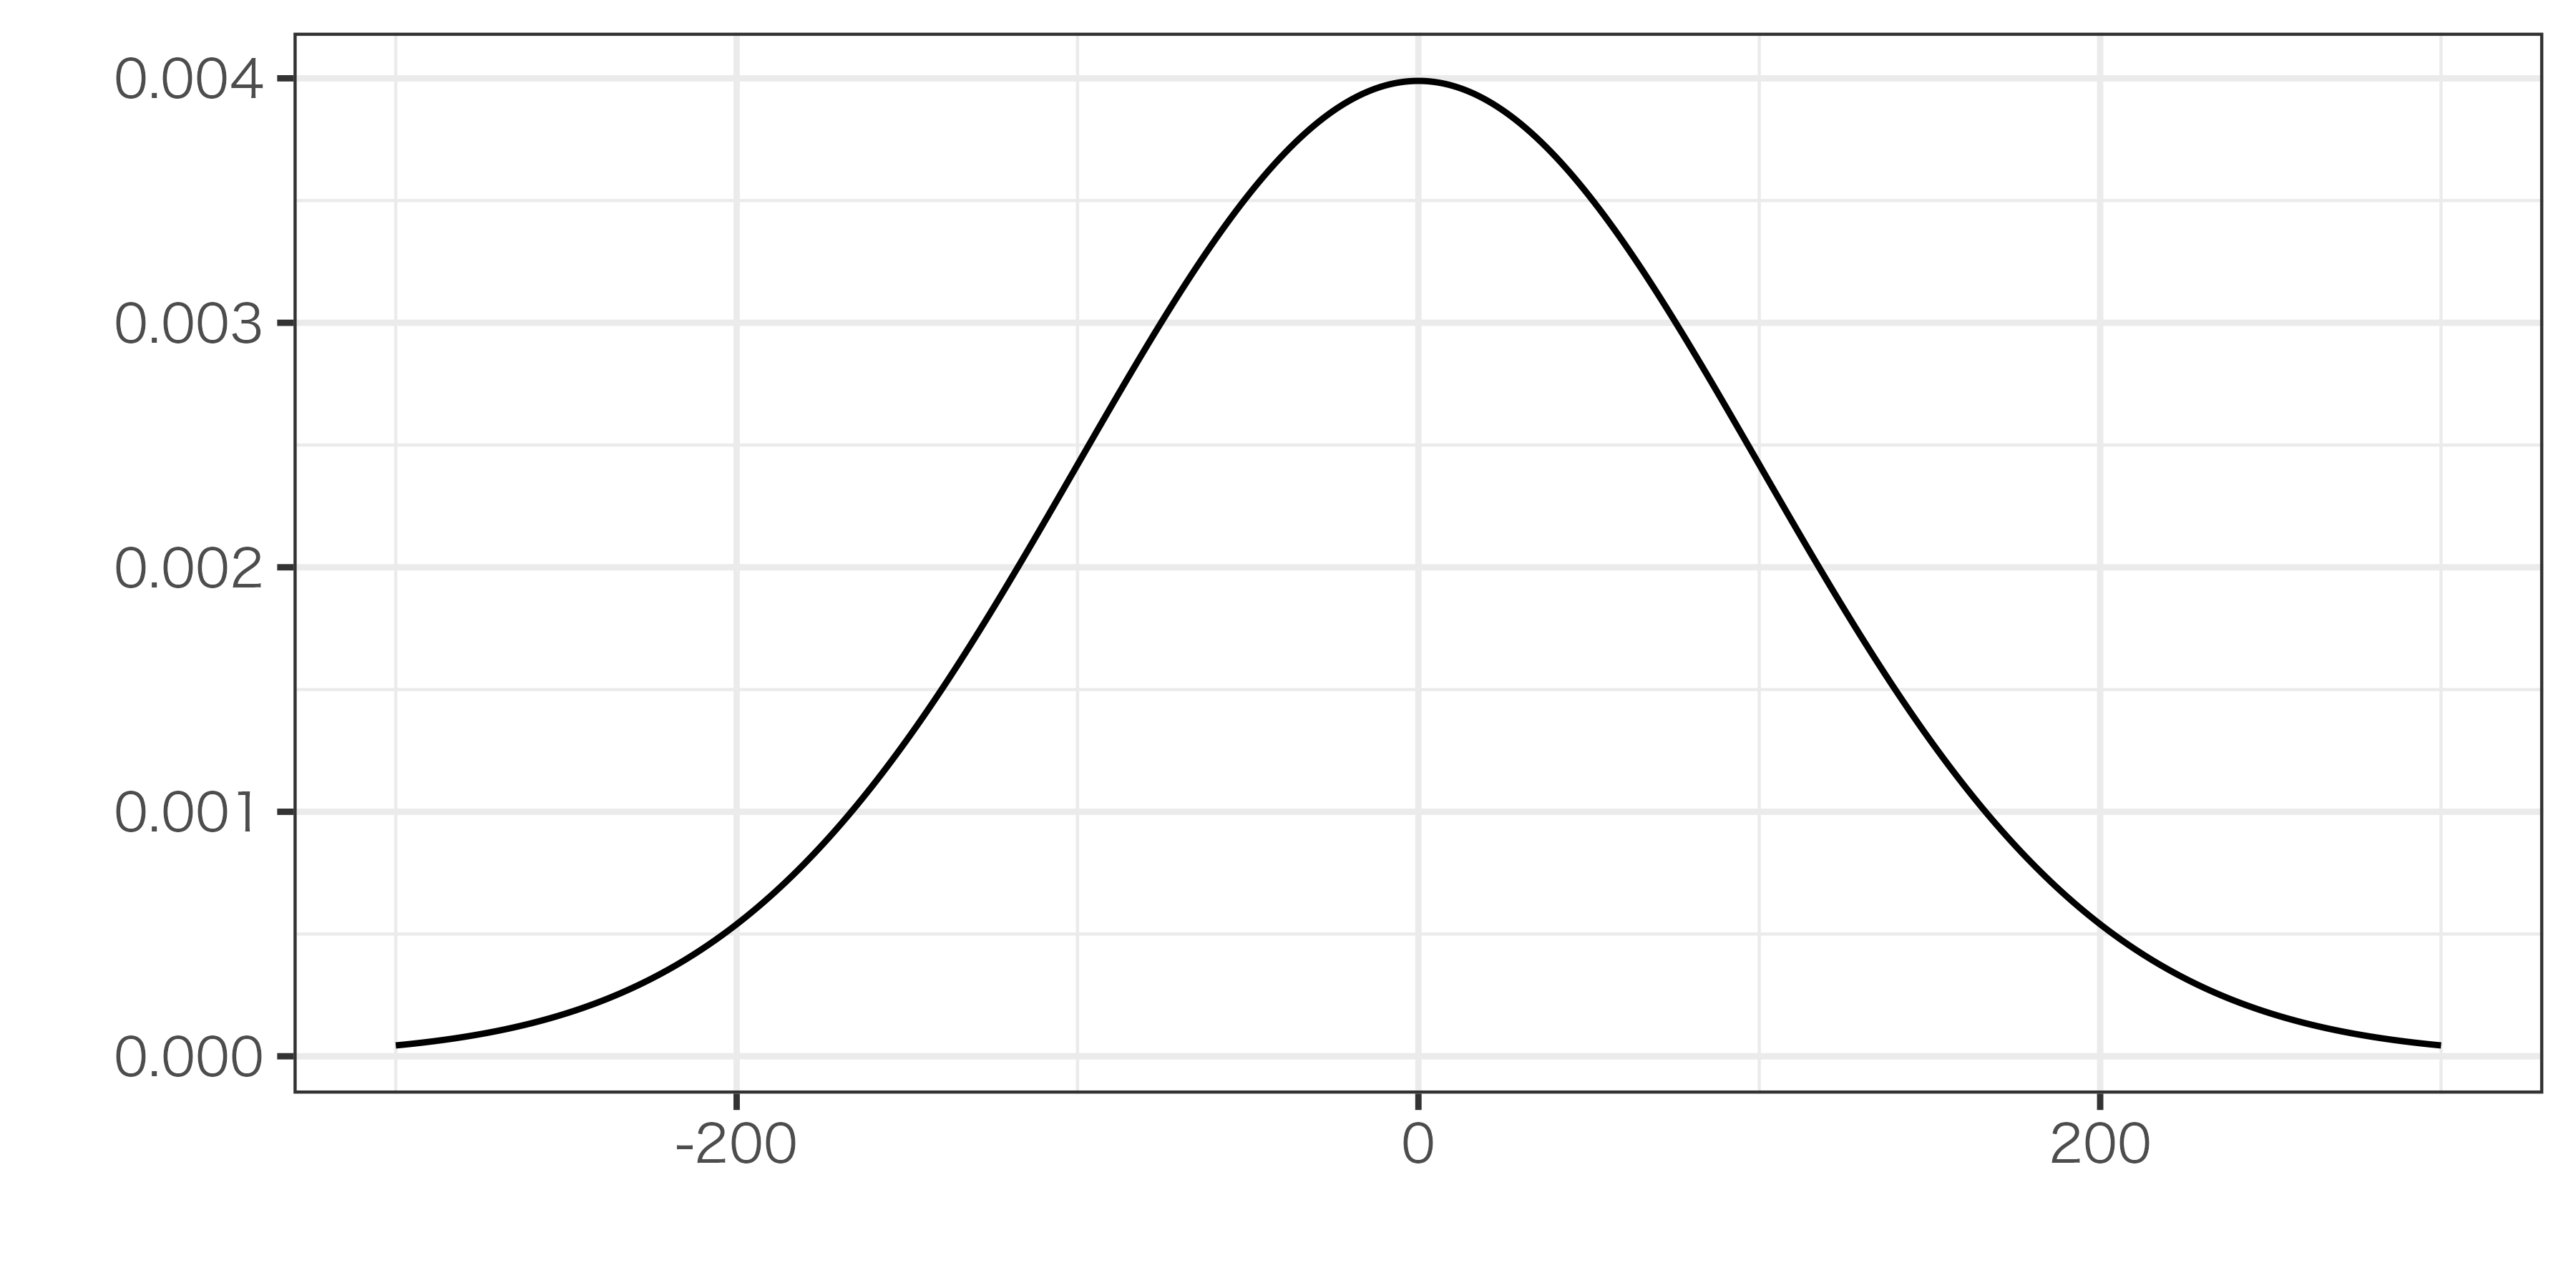
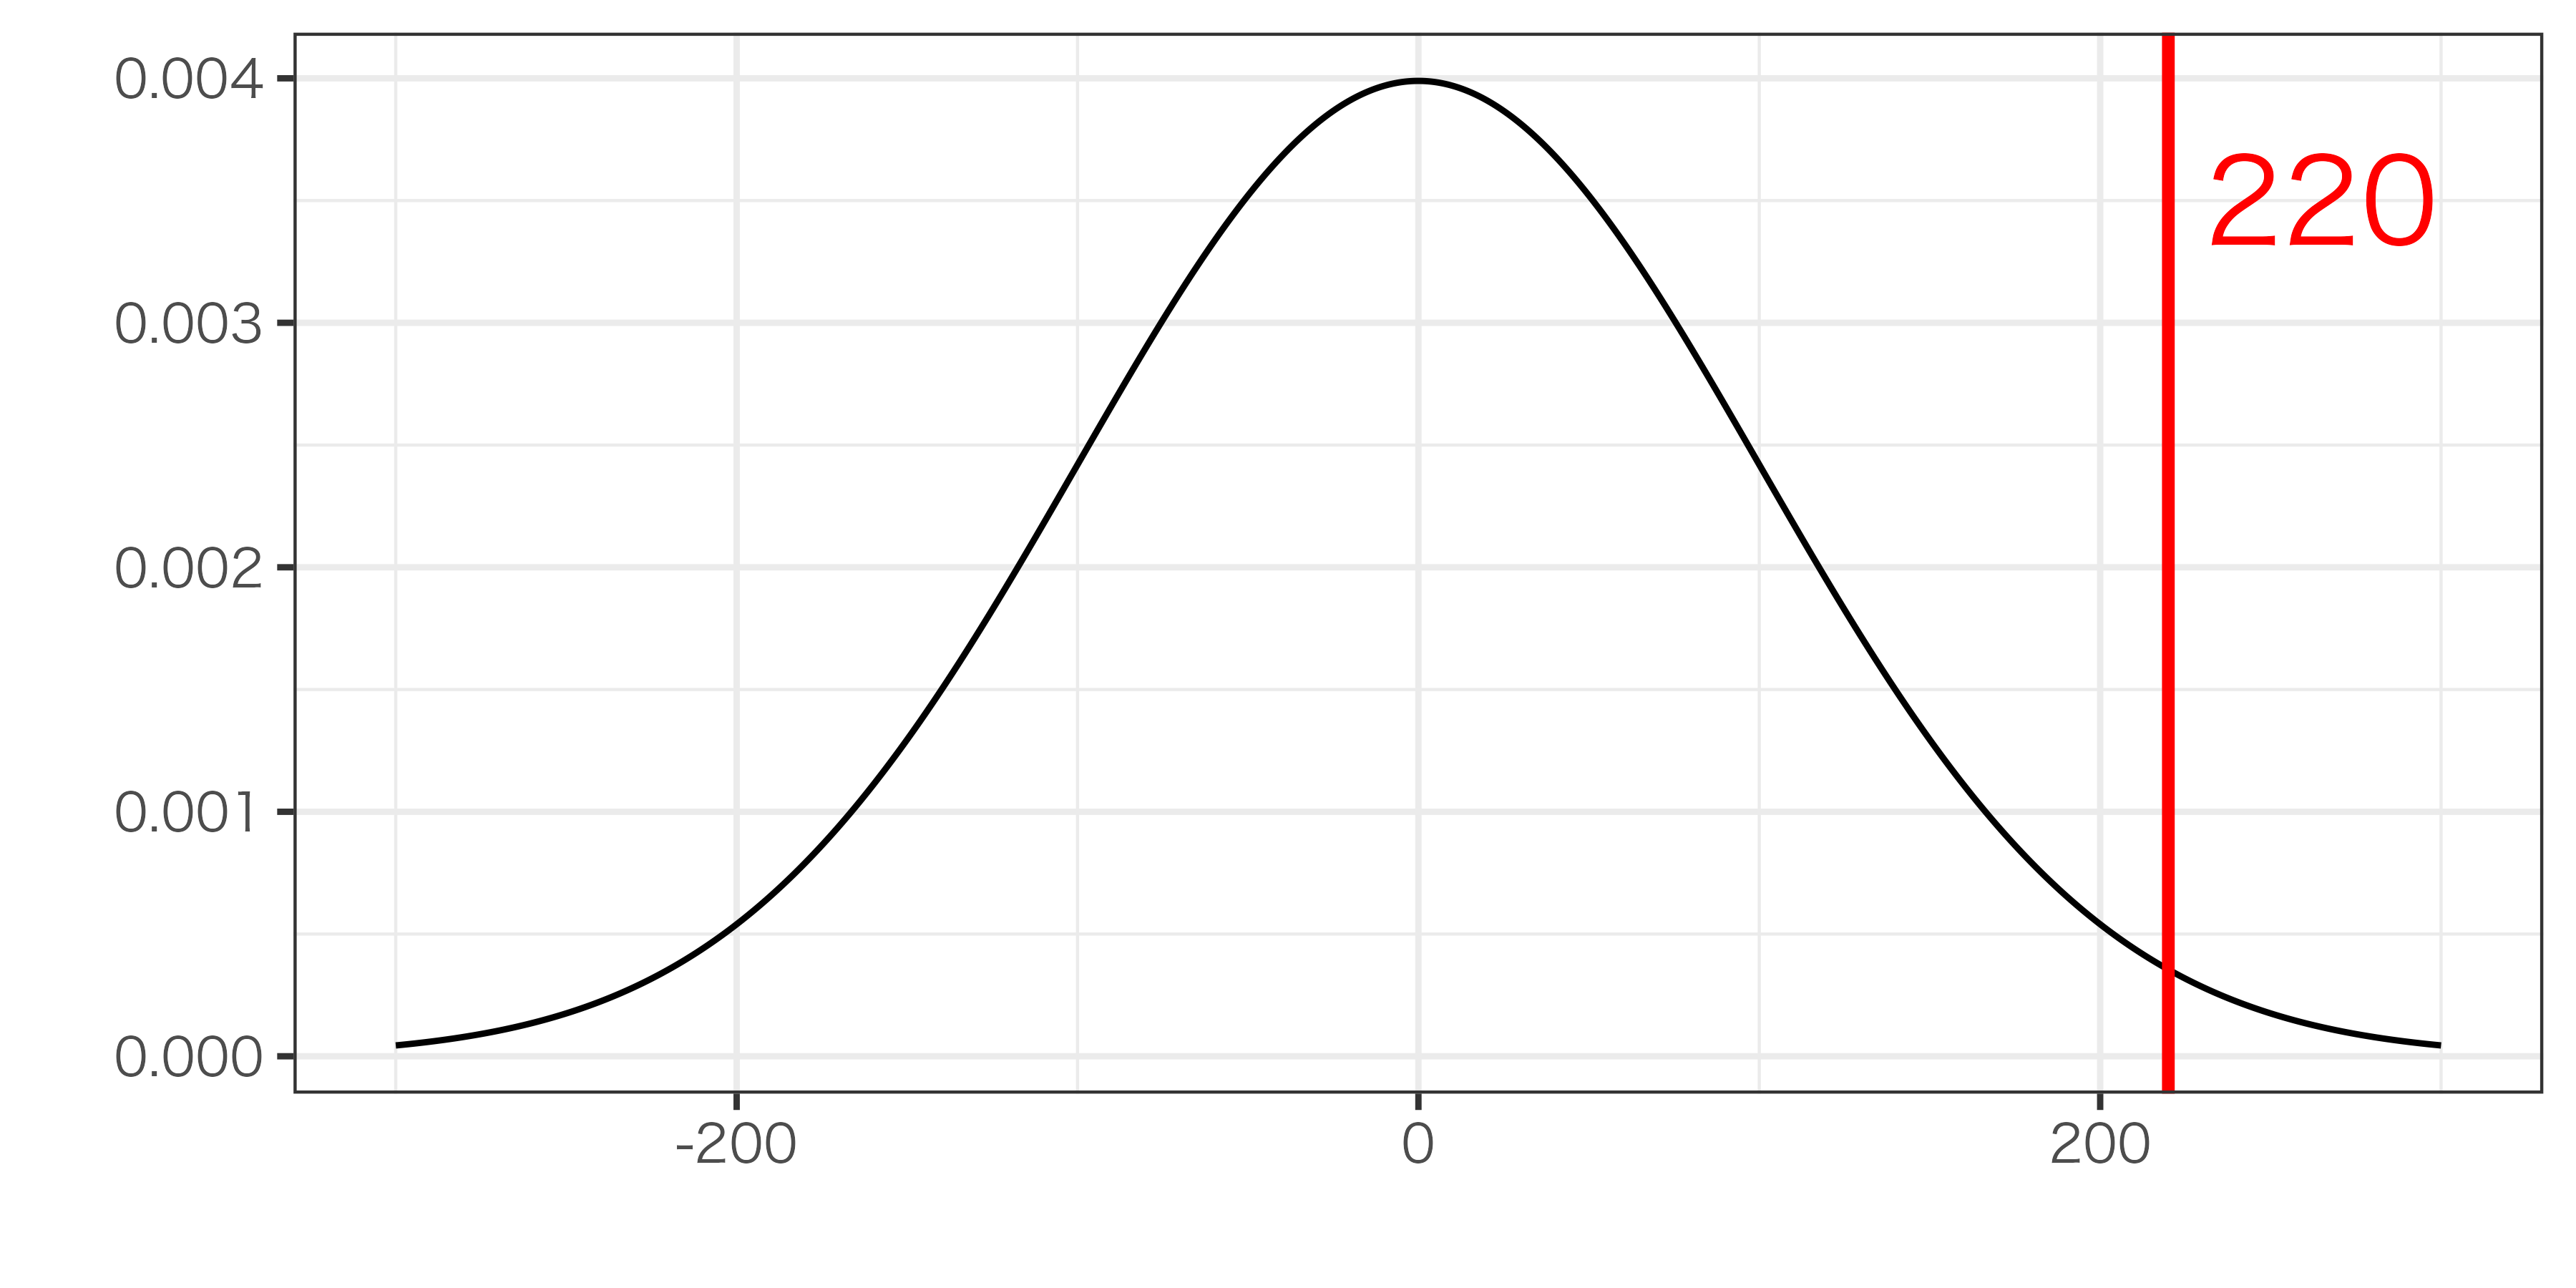
OLS推定値\(\hat{\beta}_{1}\)は正規分布にしたがう
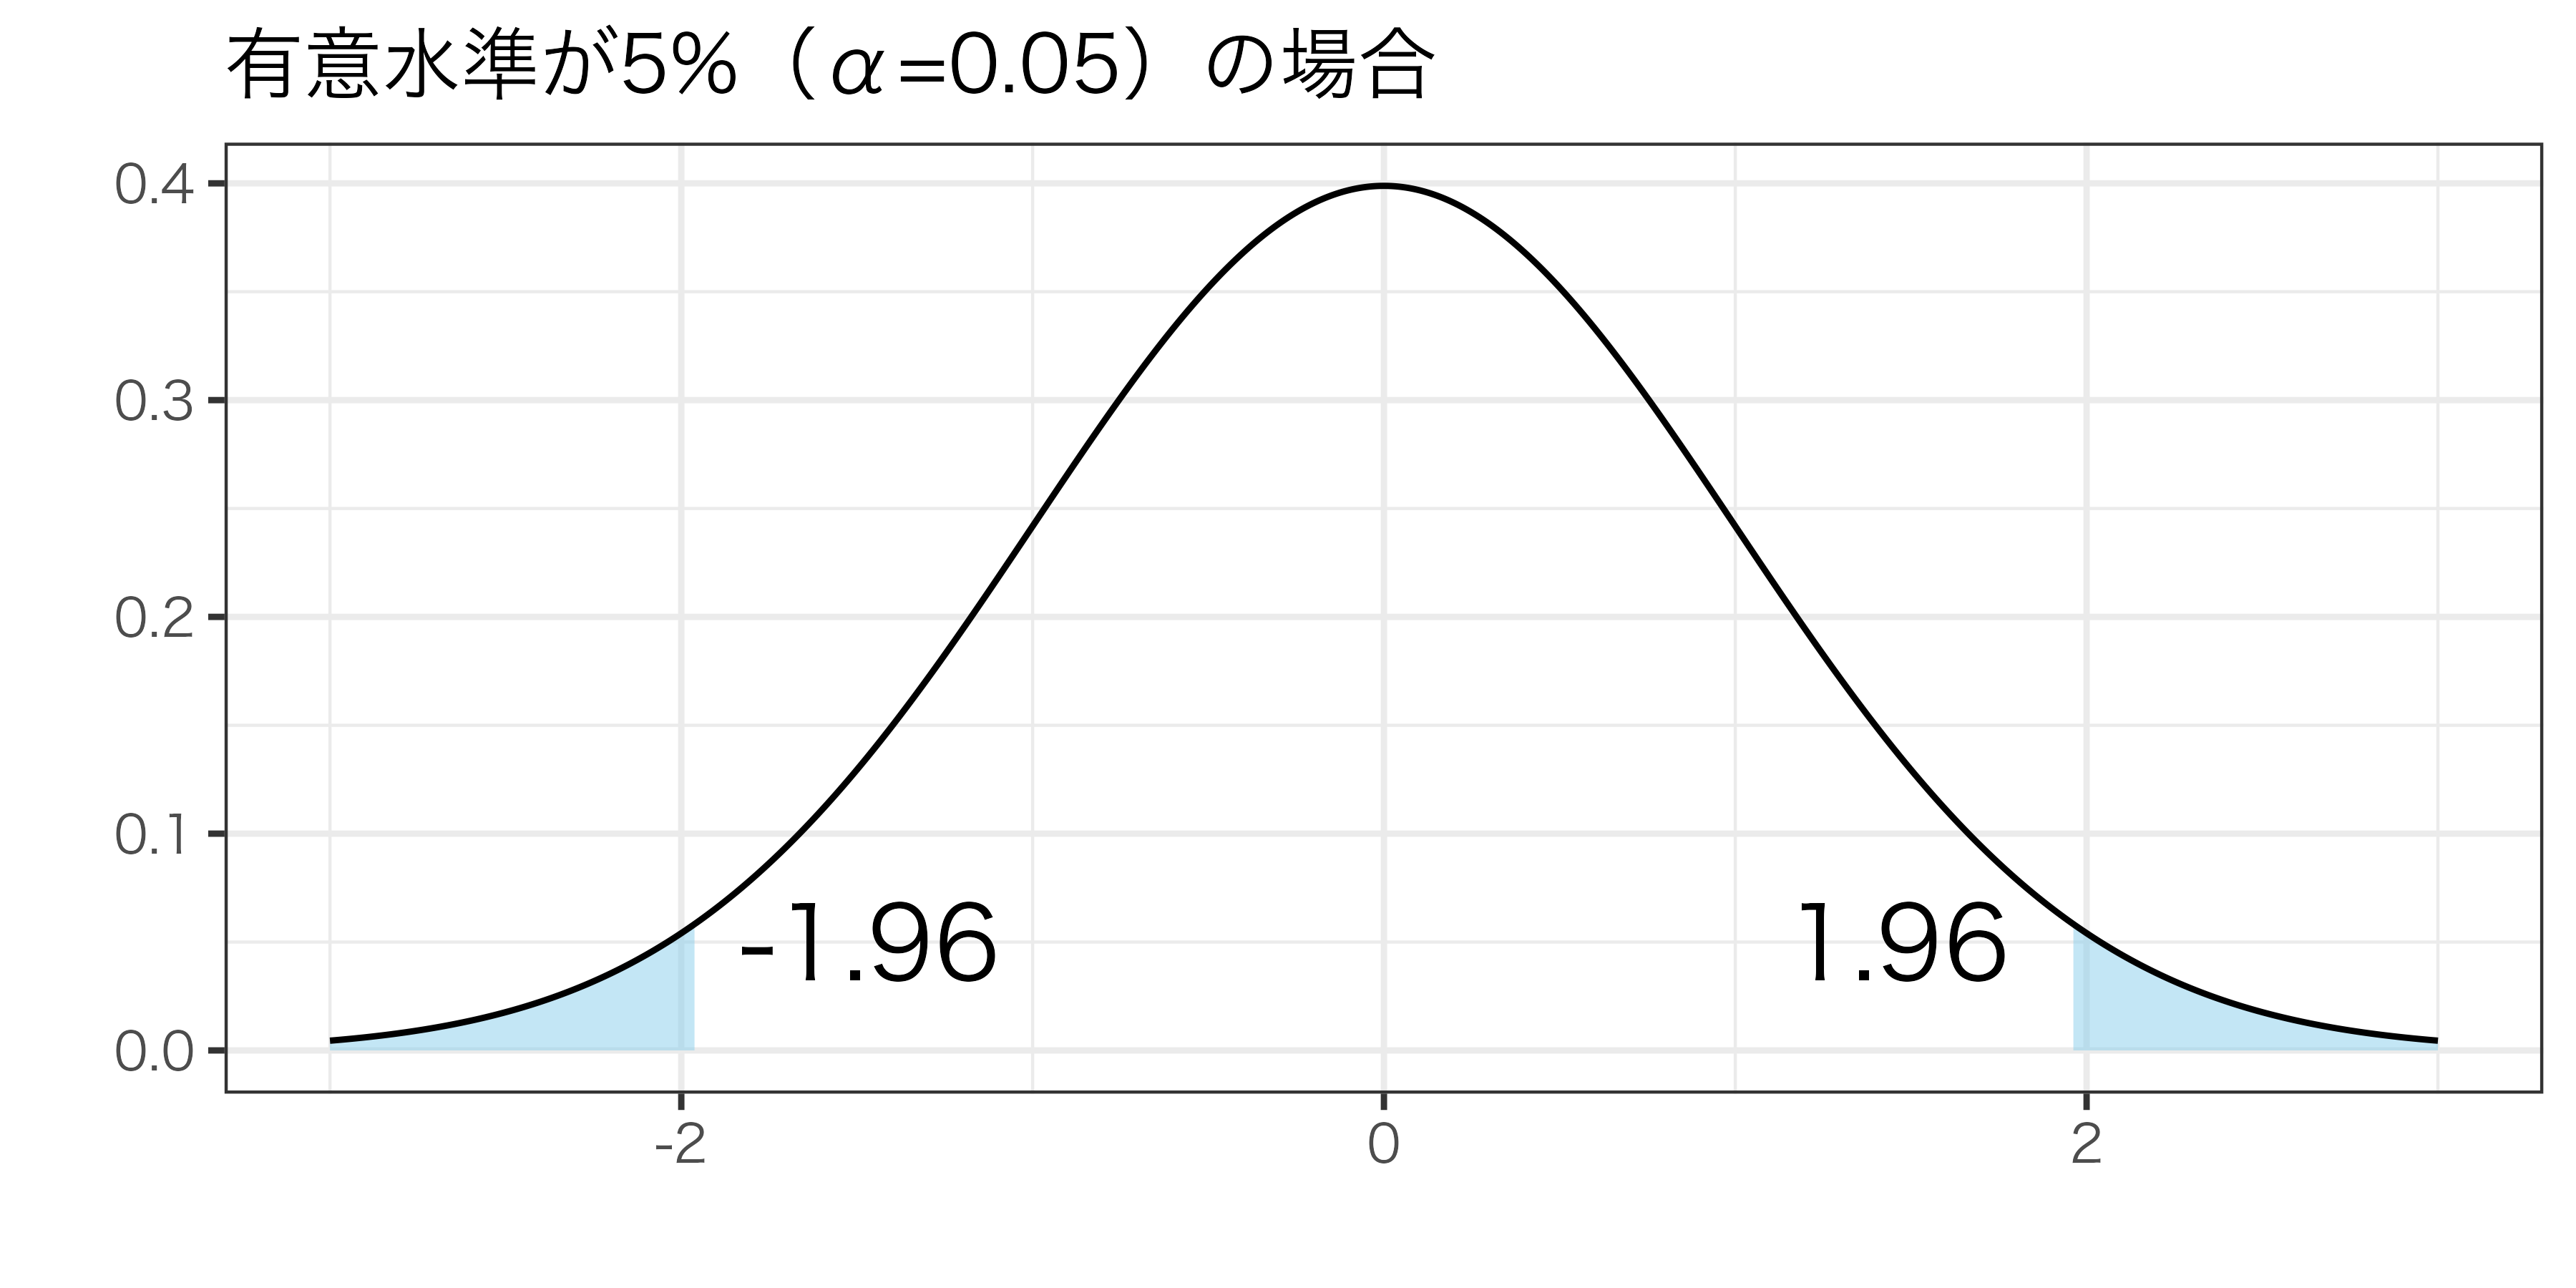
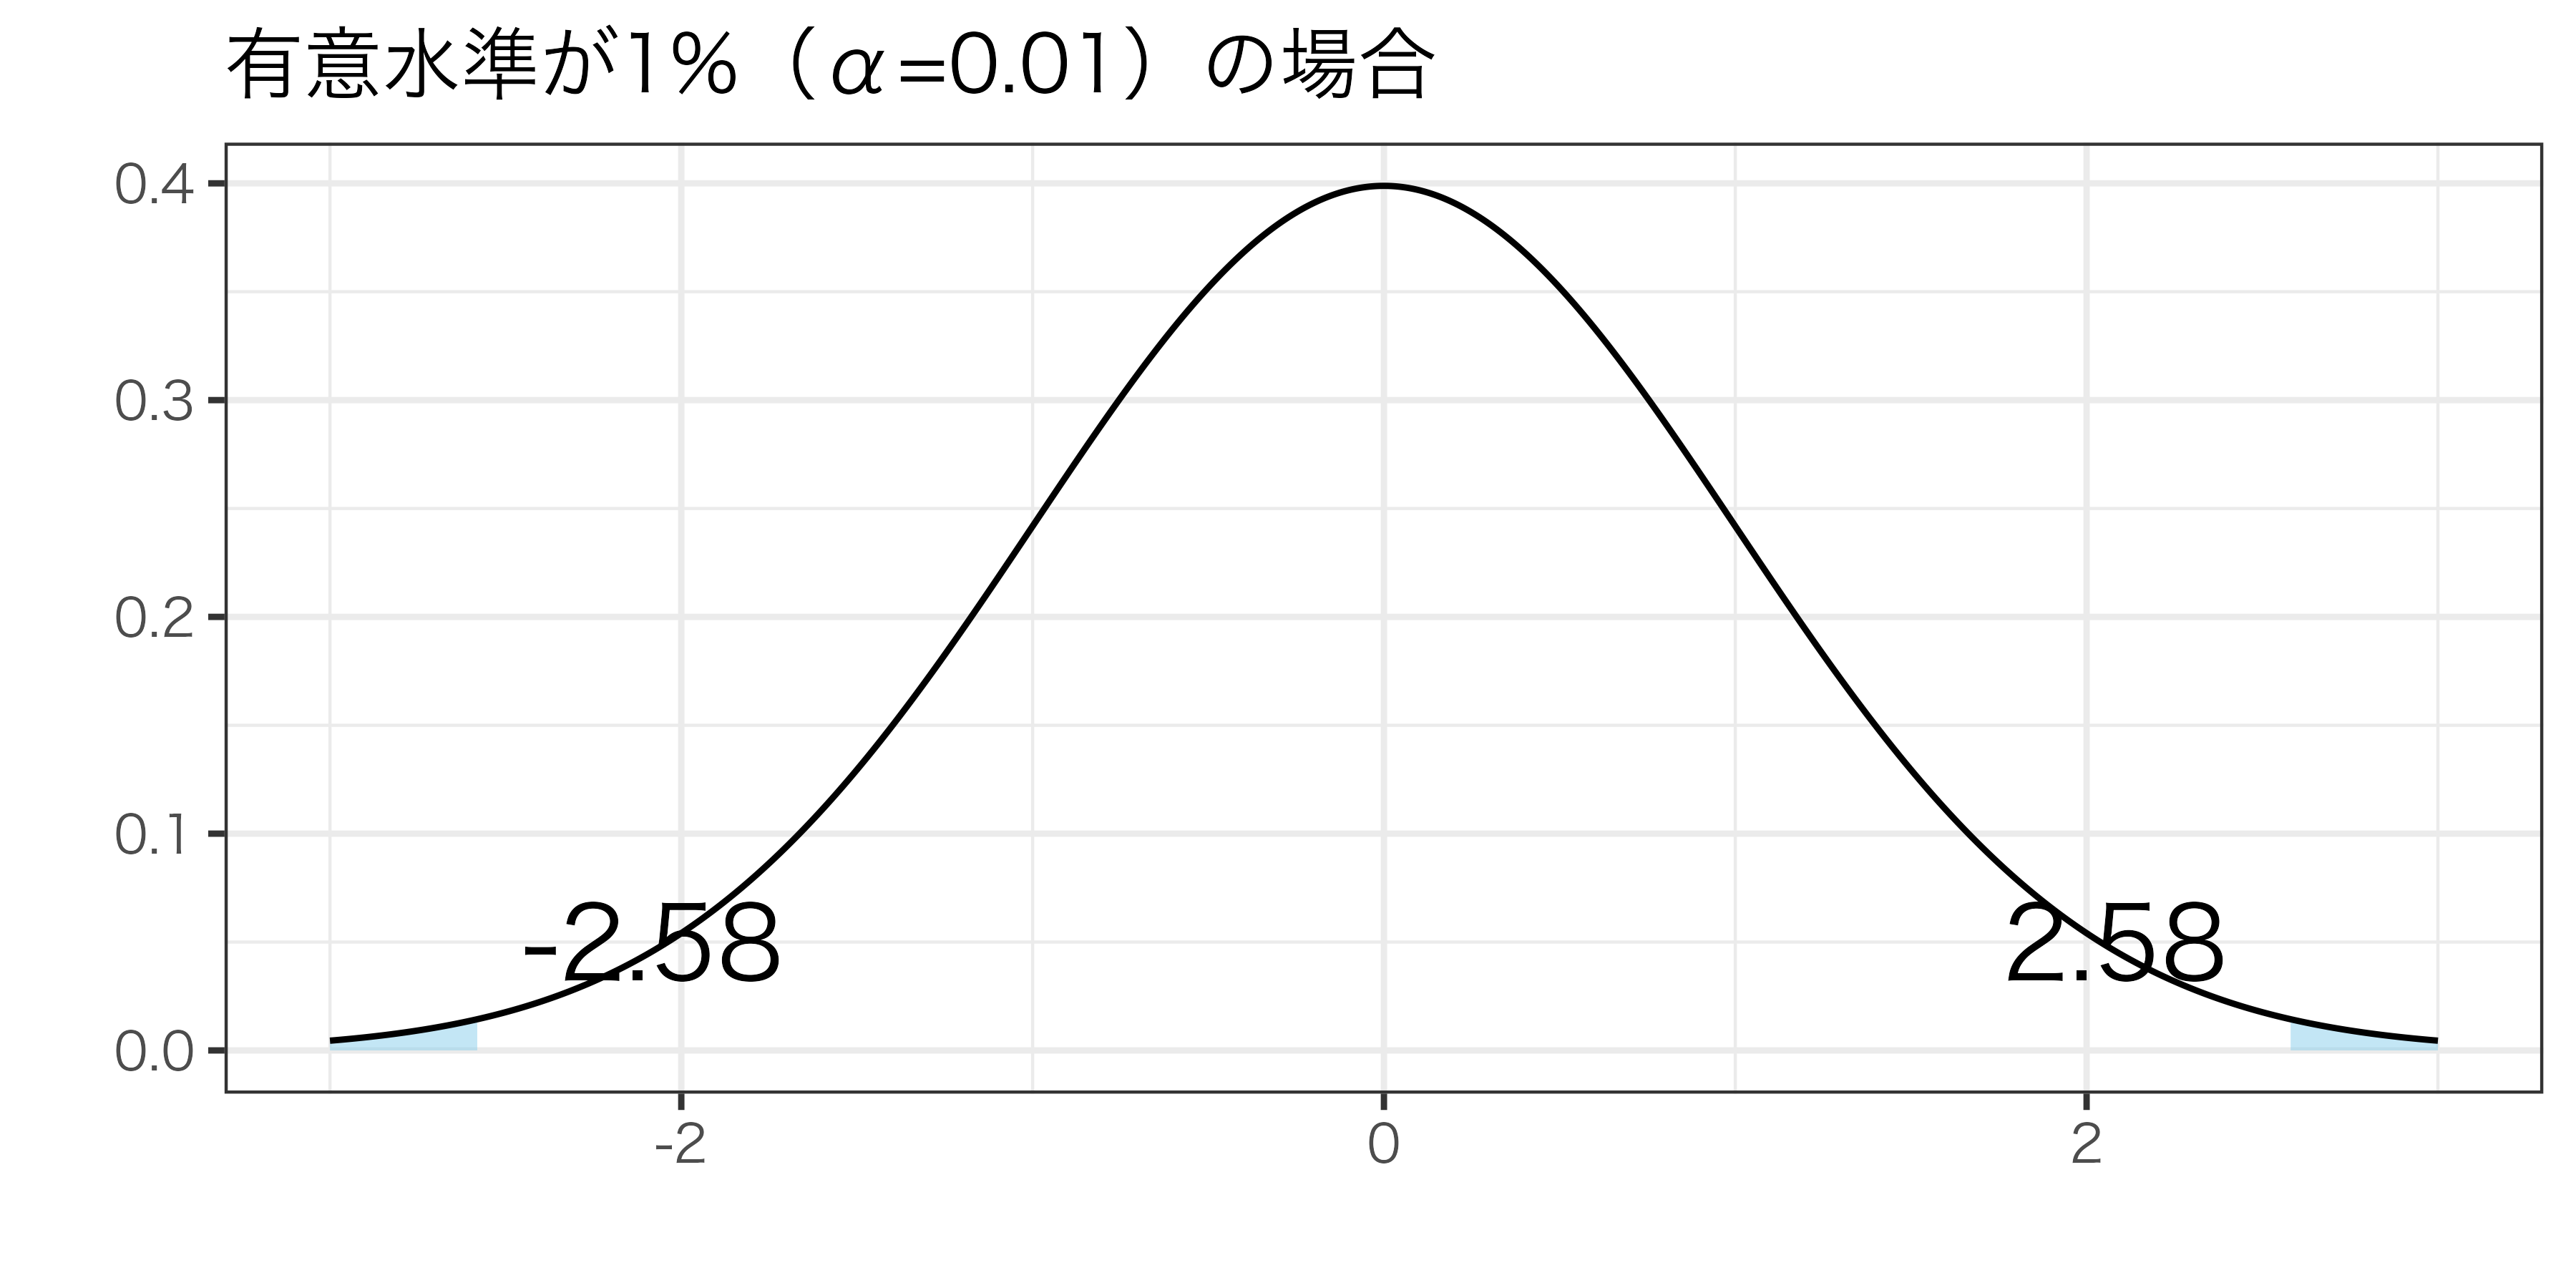
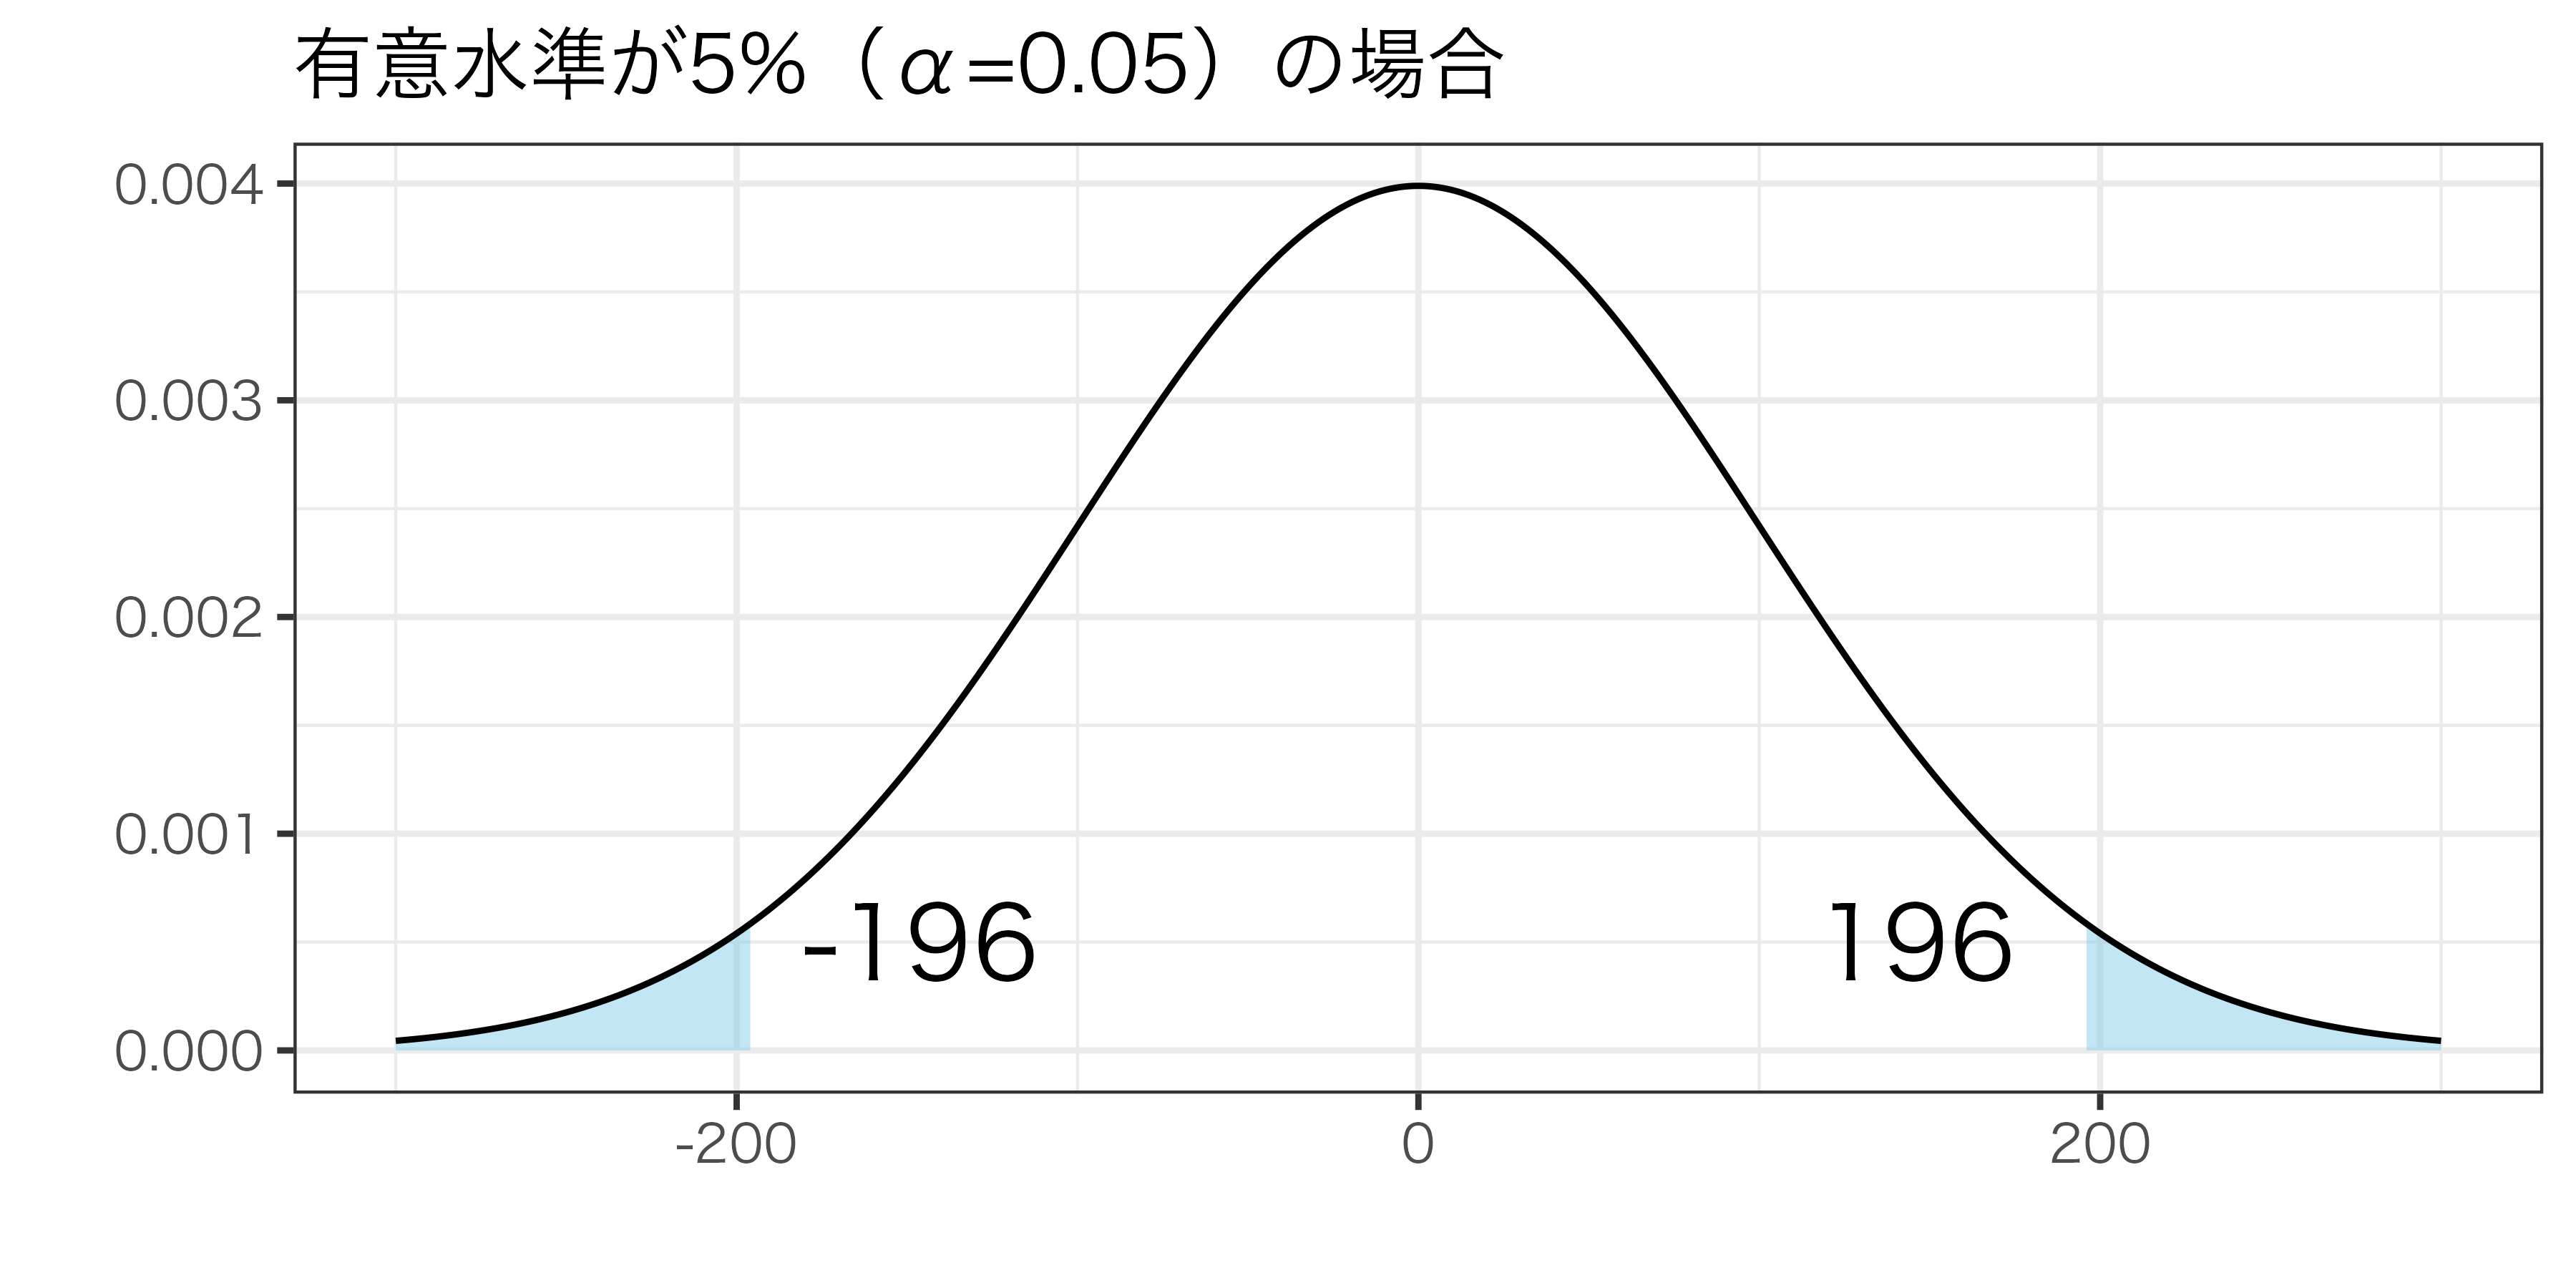
有意水準

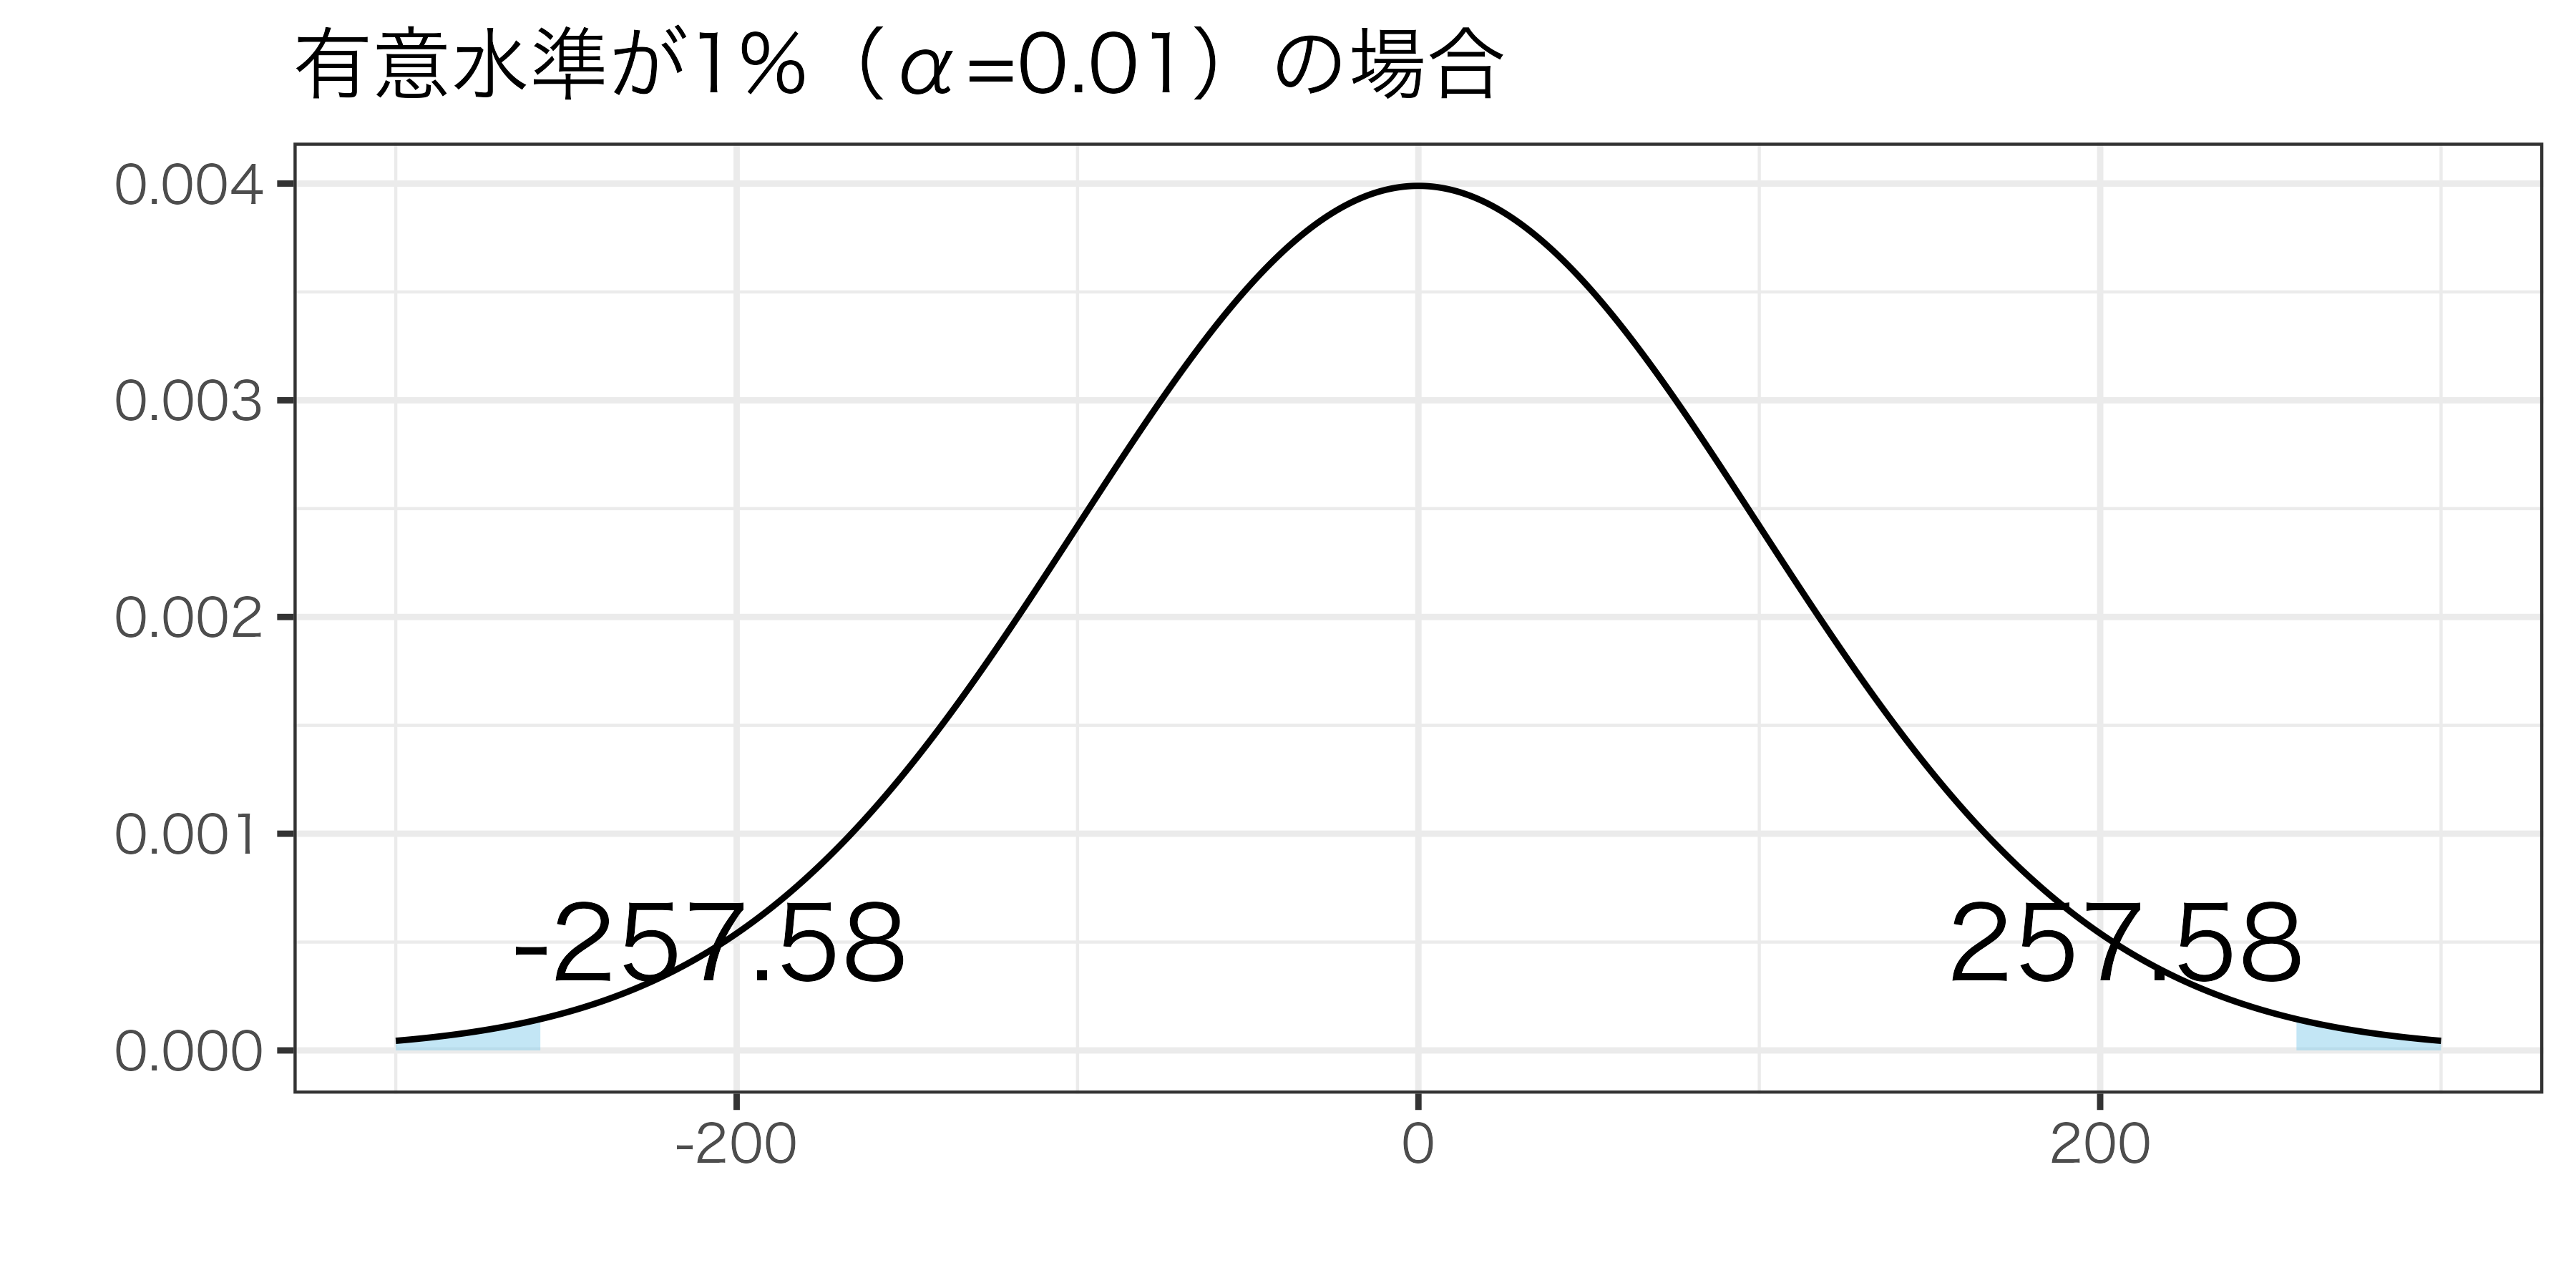
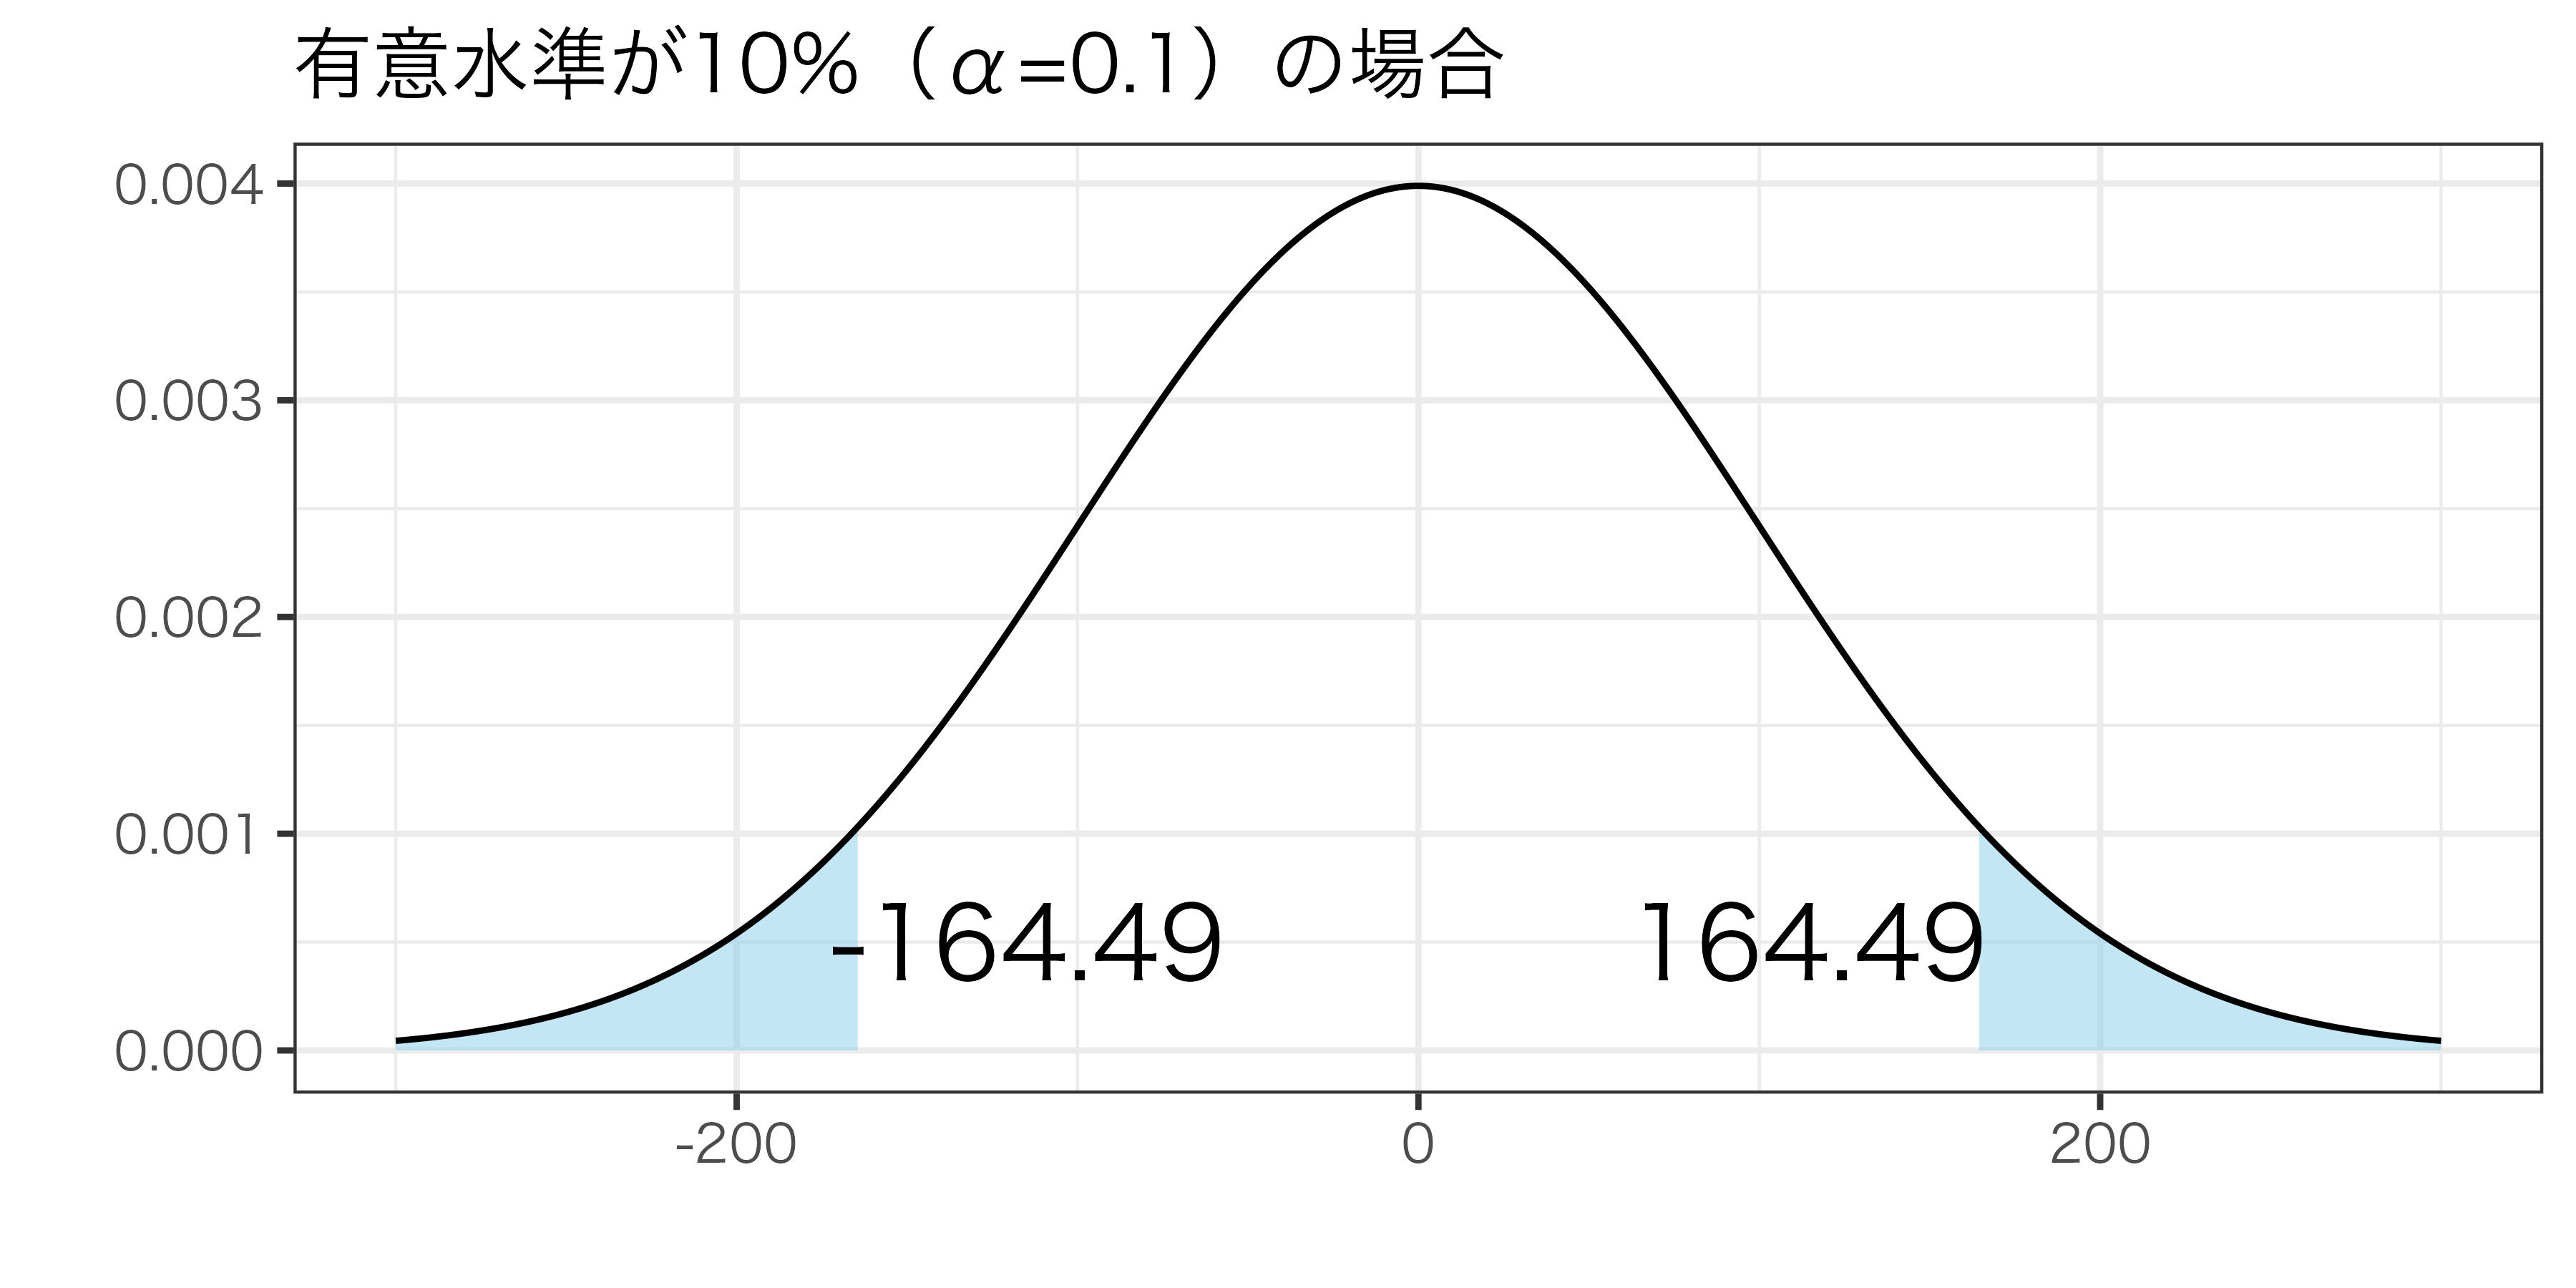
どれくらいの確率であれば帰無仮説を棄却するかの基準

  • \(\alpha\)で表記し、\(\alpha=0.05\)(5%)で設定することが多い12
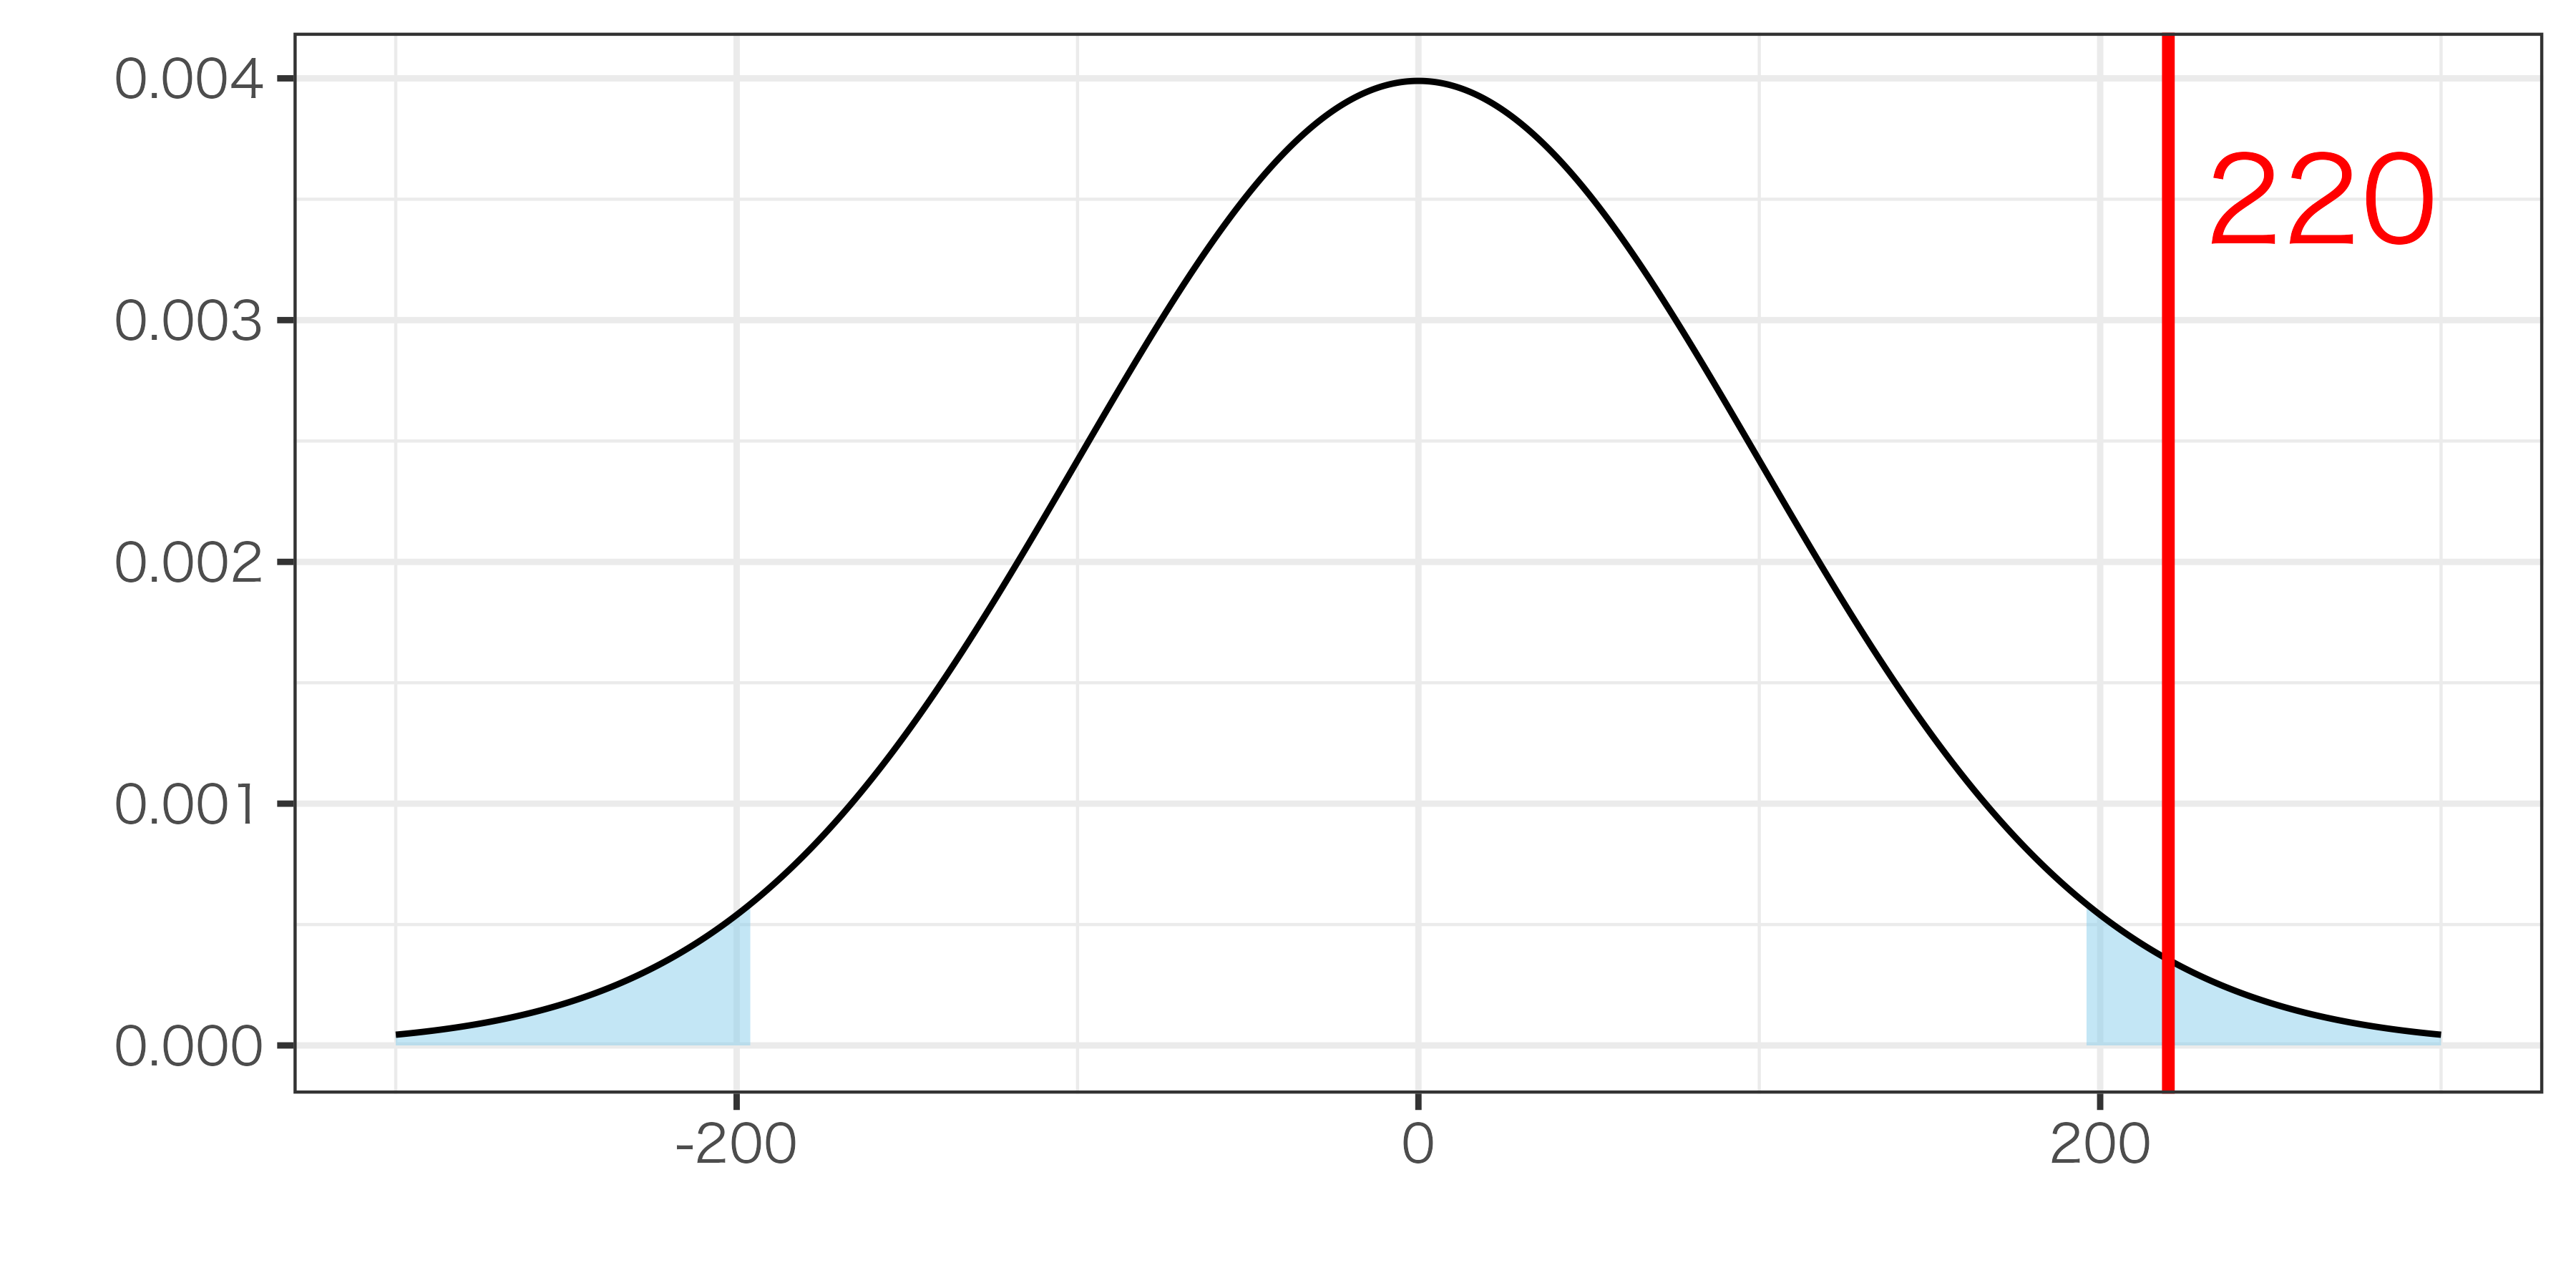
  • 推定された\(\hat{\beta}_{1}\)より大きな/小さな数が出てくる確率が…
    • \(\alpha\)より小さければ帰無仮説を棄却→統計的に有意
    • \(\alpha\)より大きければ帰無仮説を棄却できない→統計的に有意でない

例:身長と賃金

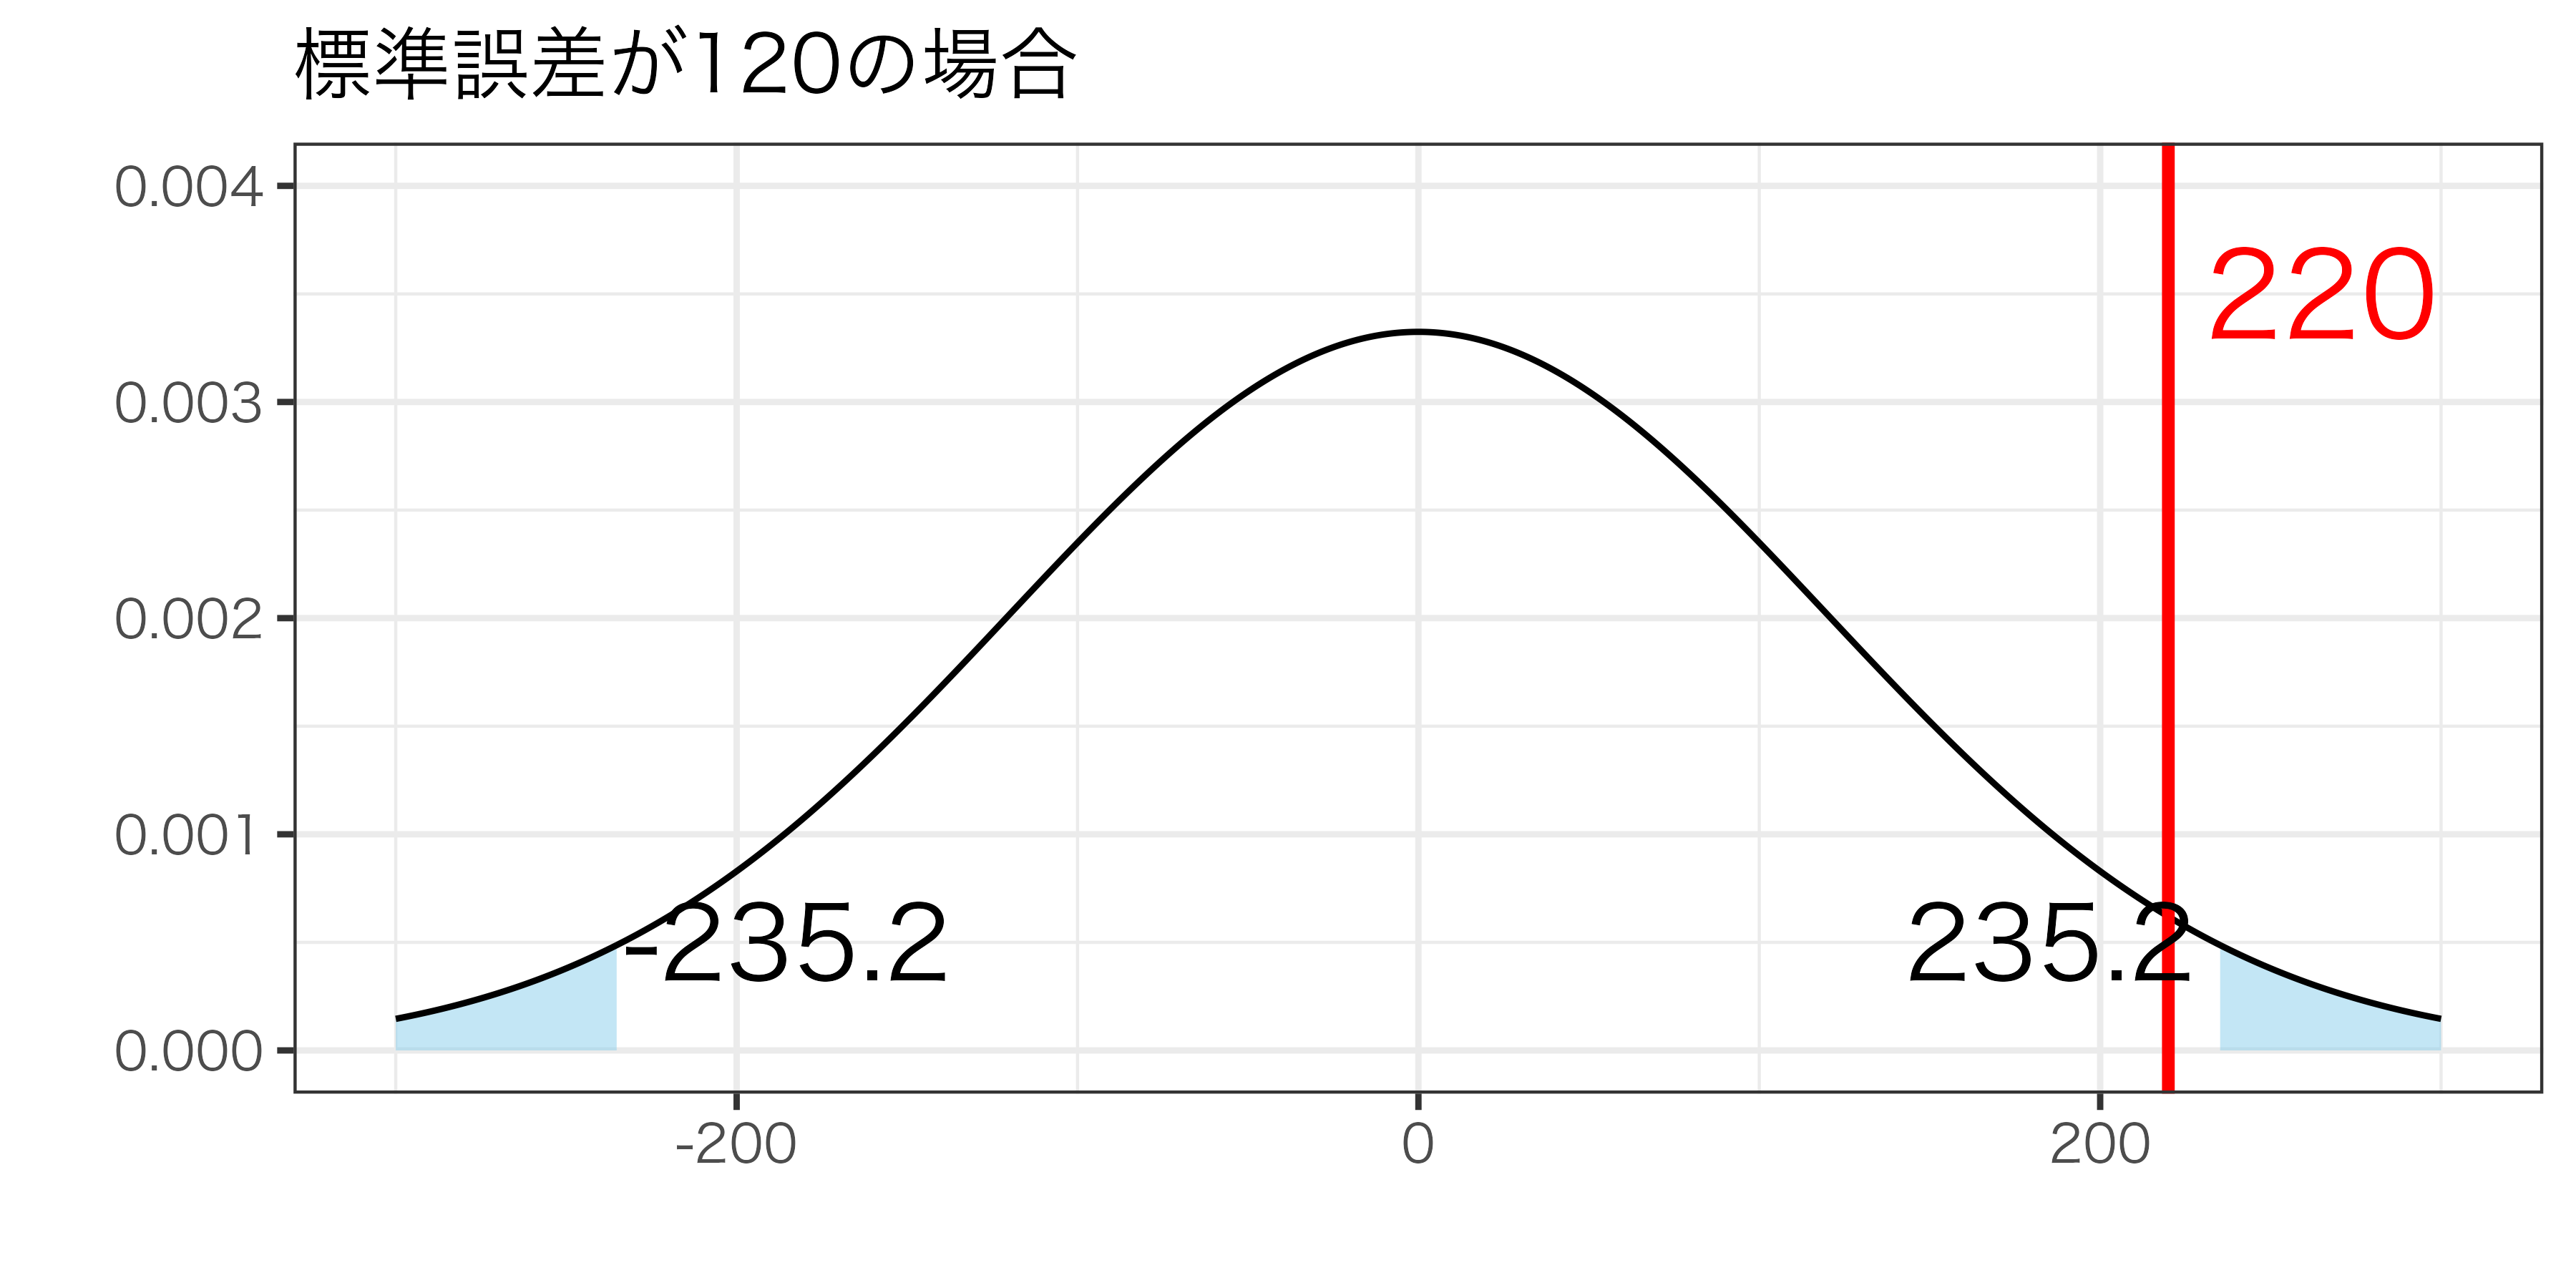
推定された傾きは\(\hat{\beta}_{1}=220\)、標準誤差は\(\operatorname{se}(\hat{\beta}_{1})=100\)であったとすると…
第1種/第2種の過誤
第1種/第2種の過誤

質問

あなたは妊娠検査薬の開発者です。

製品に「妊娠していないのに妊娠していると判定する」という、偽陽性をめぐる苦情が多く寄せられたため、陽性と判定する基準を厳しくすることにしました。

この変更によって、今度はどのような問題が起こる可能性があるでしょうか?(WebClassチャット)

統計的仮説検定と過誤

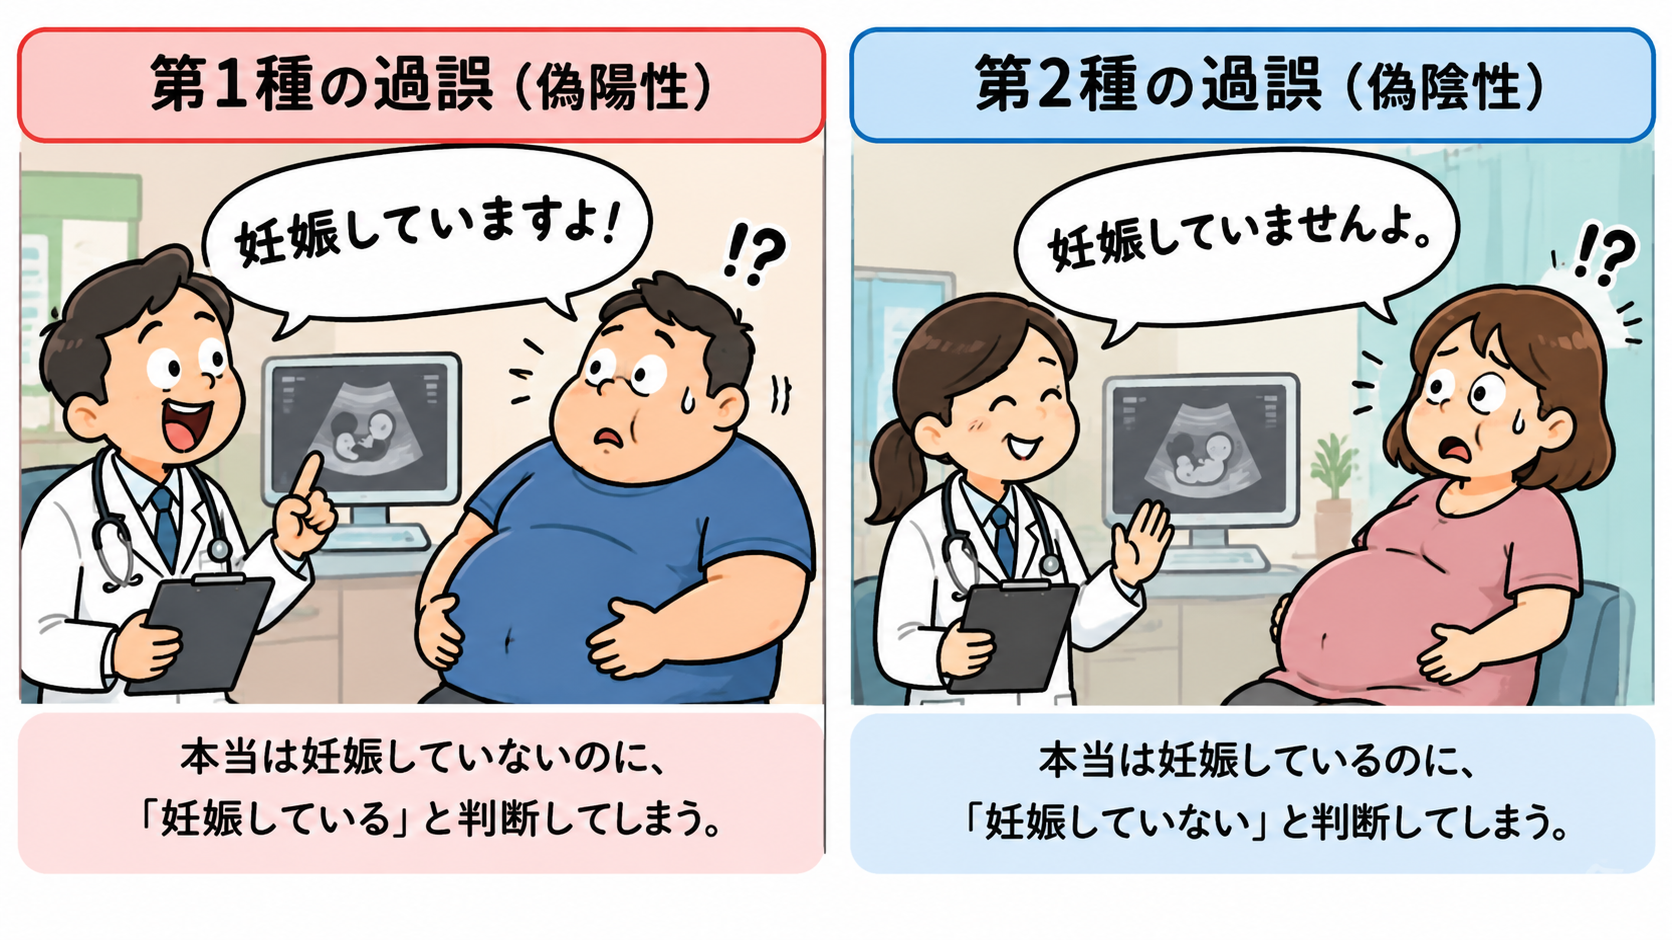
第1種の過誤 (Type I Error)

帰無仮説が正しいのに棄却してしまうこと(偽陽性)

  • 例:本当は身長は賃金に影響しないのに影響すると結論
    • \(H_{0}:\beta_{1}=0\)が正しいのに\(H_{1}:\beta_{1}\ne0\)と判断

第2種の過誤 (Type II Error)

帰無仮説が誤っているのに棄却しないこと(偽陰性)

  • 例:本当は身長は賃金に影響するのに影響しないと結論
    • \(H_{1}:\beta_{1}\ne0\)が正しいのに\(H_{0}:\beta_{1}=0\)と判断

第1種の過誤と第2種の過誤の間にはトレードオフがある

有意水準と第1種の過誤

有意水準\(\alpha\)は第1種の過誤を犯す確率である。
t検定

t検定 (t-test)

実際のOLS推定値の仮説検定では、\(\hat{\beta}_{1}\)そのものではなく標準誤差で割った\(\frac{\hat{\beta}_{1}}{\operatorname{se}(\hat{\beta}_{1})}\)で検定を行う

  • \(\frac{\hat{\beta}_{1}}{\operatorname{se}(\hat{\beta}_{1})}\)を\(t\)値といい、\(t\)値は正規分布ではなく\(t\)分布にしたがう
    • \(t\)分布は1908年にウィリアム・ゴセットが発見1
  • \(t\)検定はすごくわかりやすい
    • \(t\)値がだいたい2以上/-2以下なら統計的有意
    • そうでないなら統計的有意でない

William Gosset (1876-1937)

t値を使う理由

同じ\(\hat{\beta}_{1}\)の値でも、標準誤差に応じてその珍しさは変わる
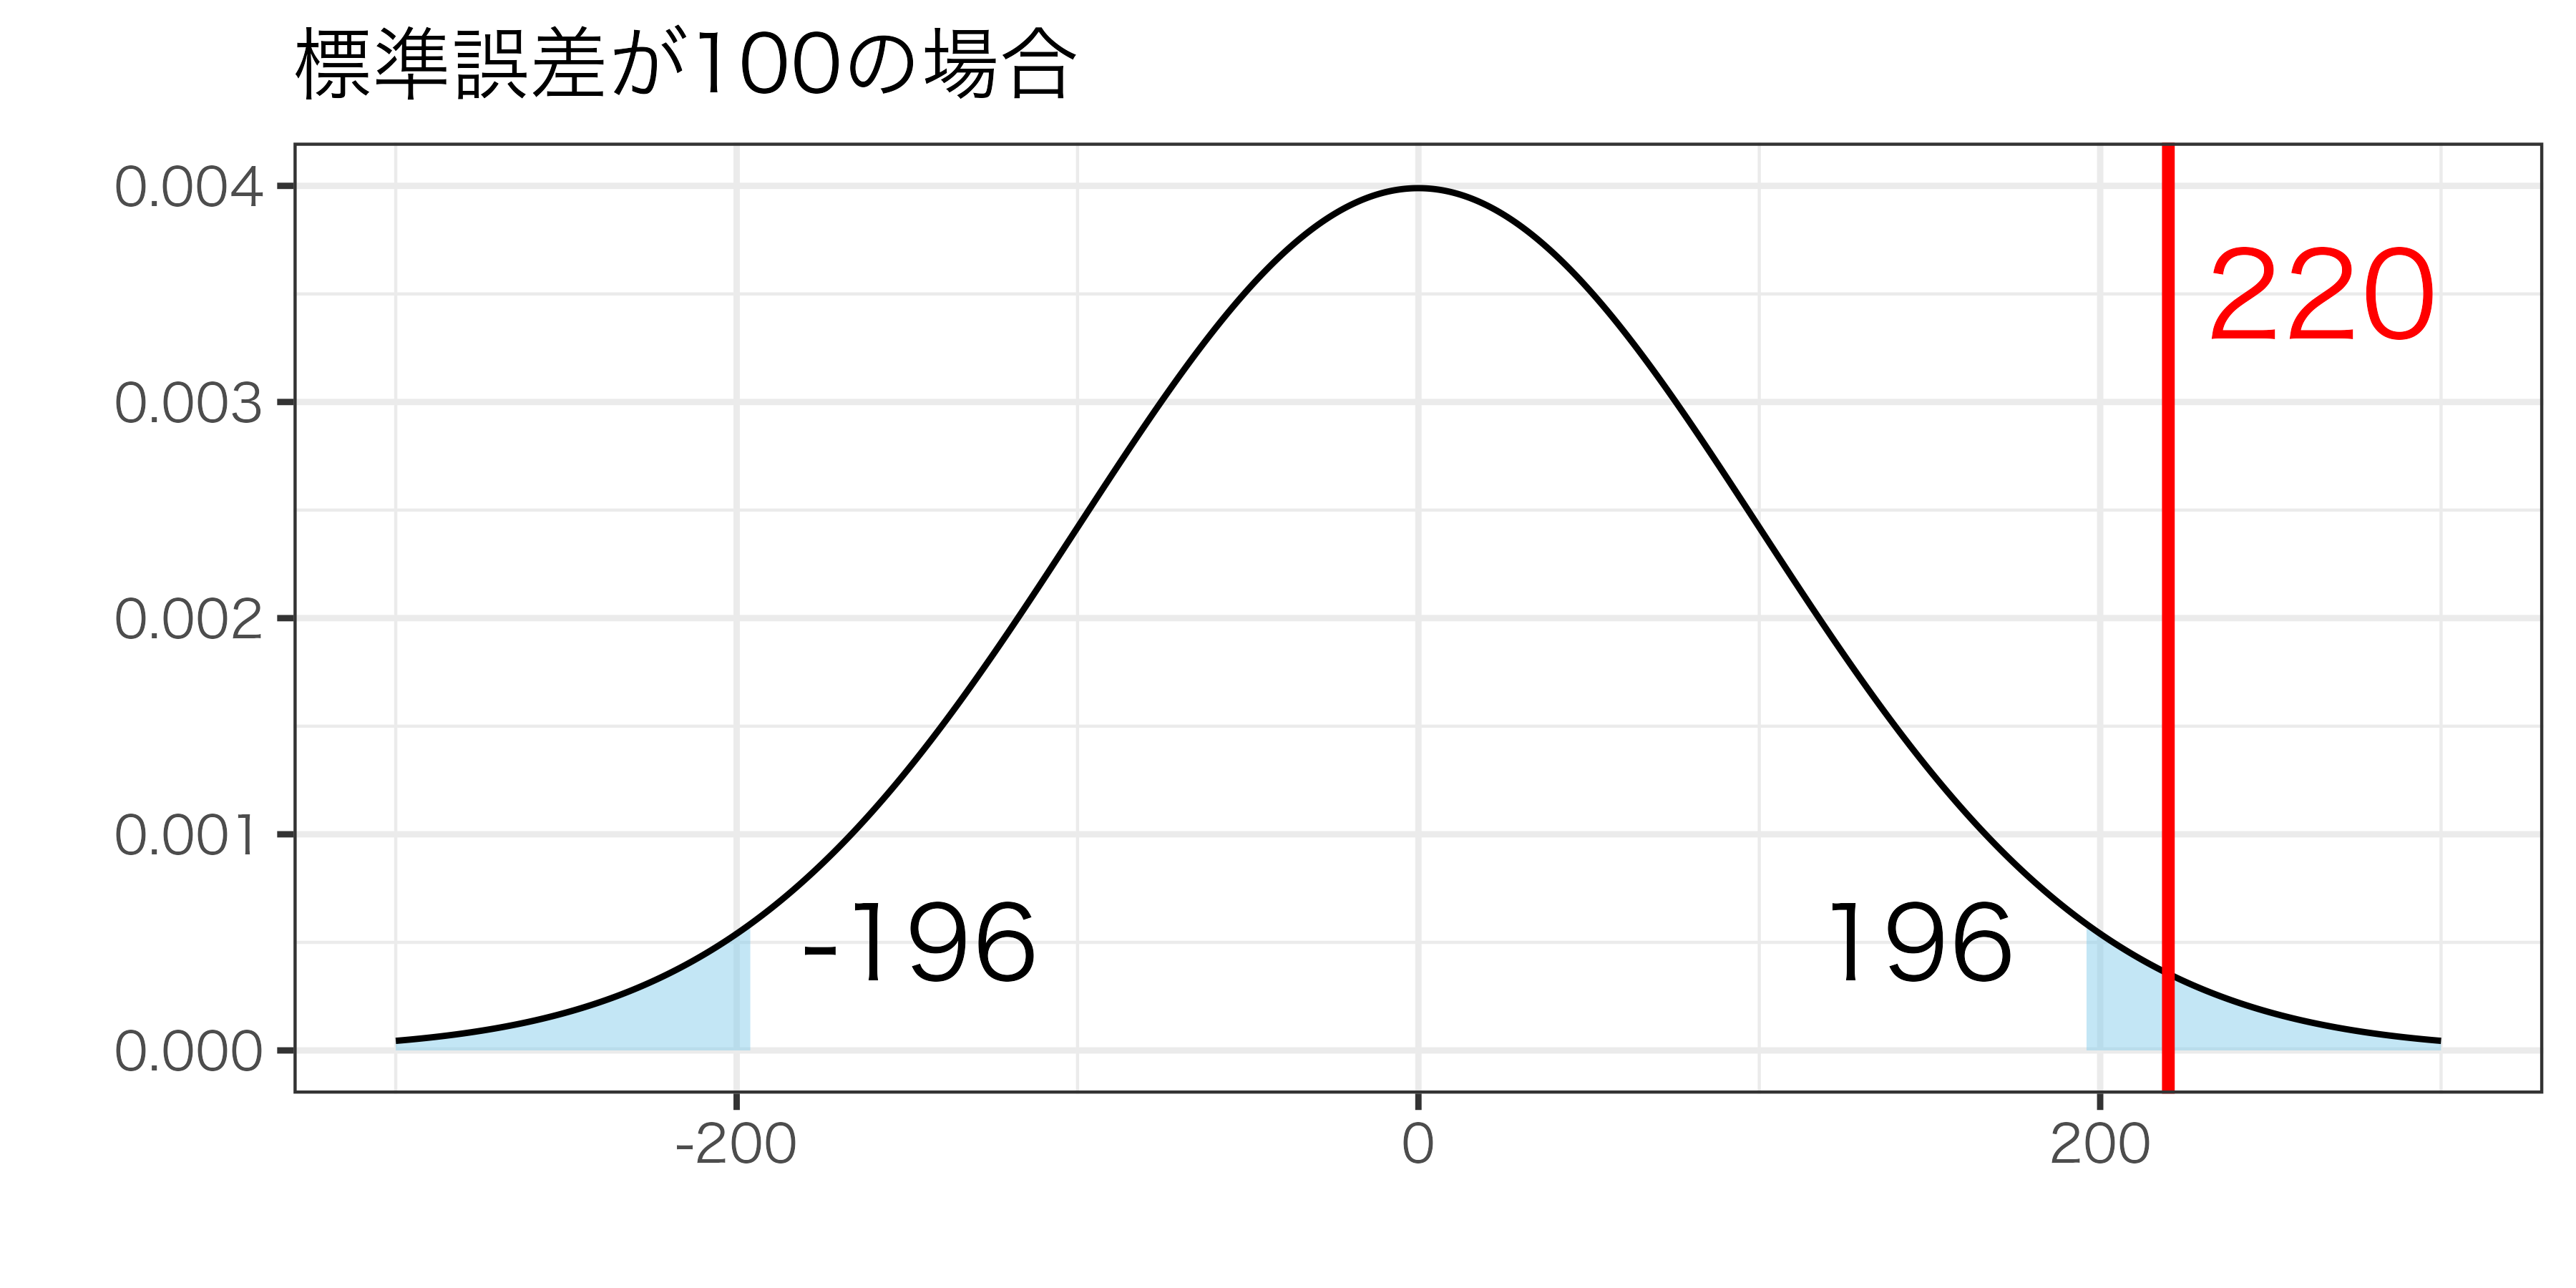
→標準誤差で割って尺度を統一し、有意性の判断が容易に

t分布

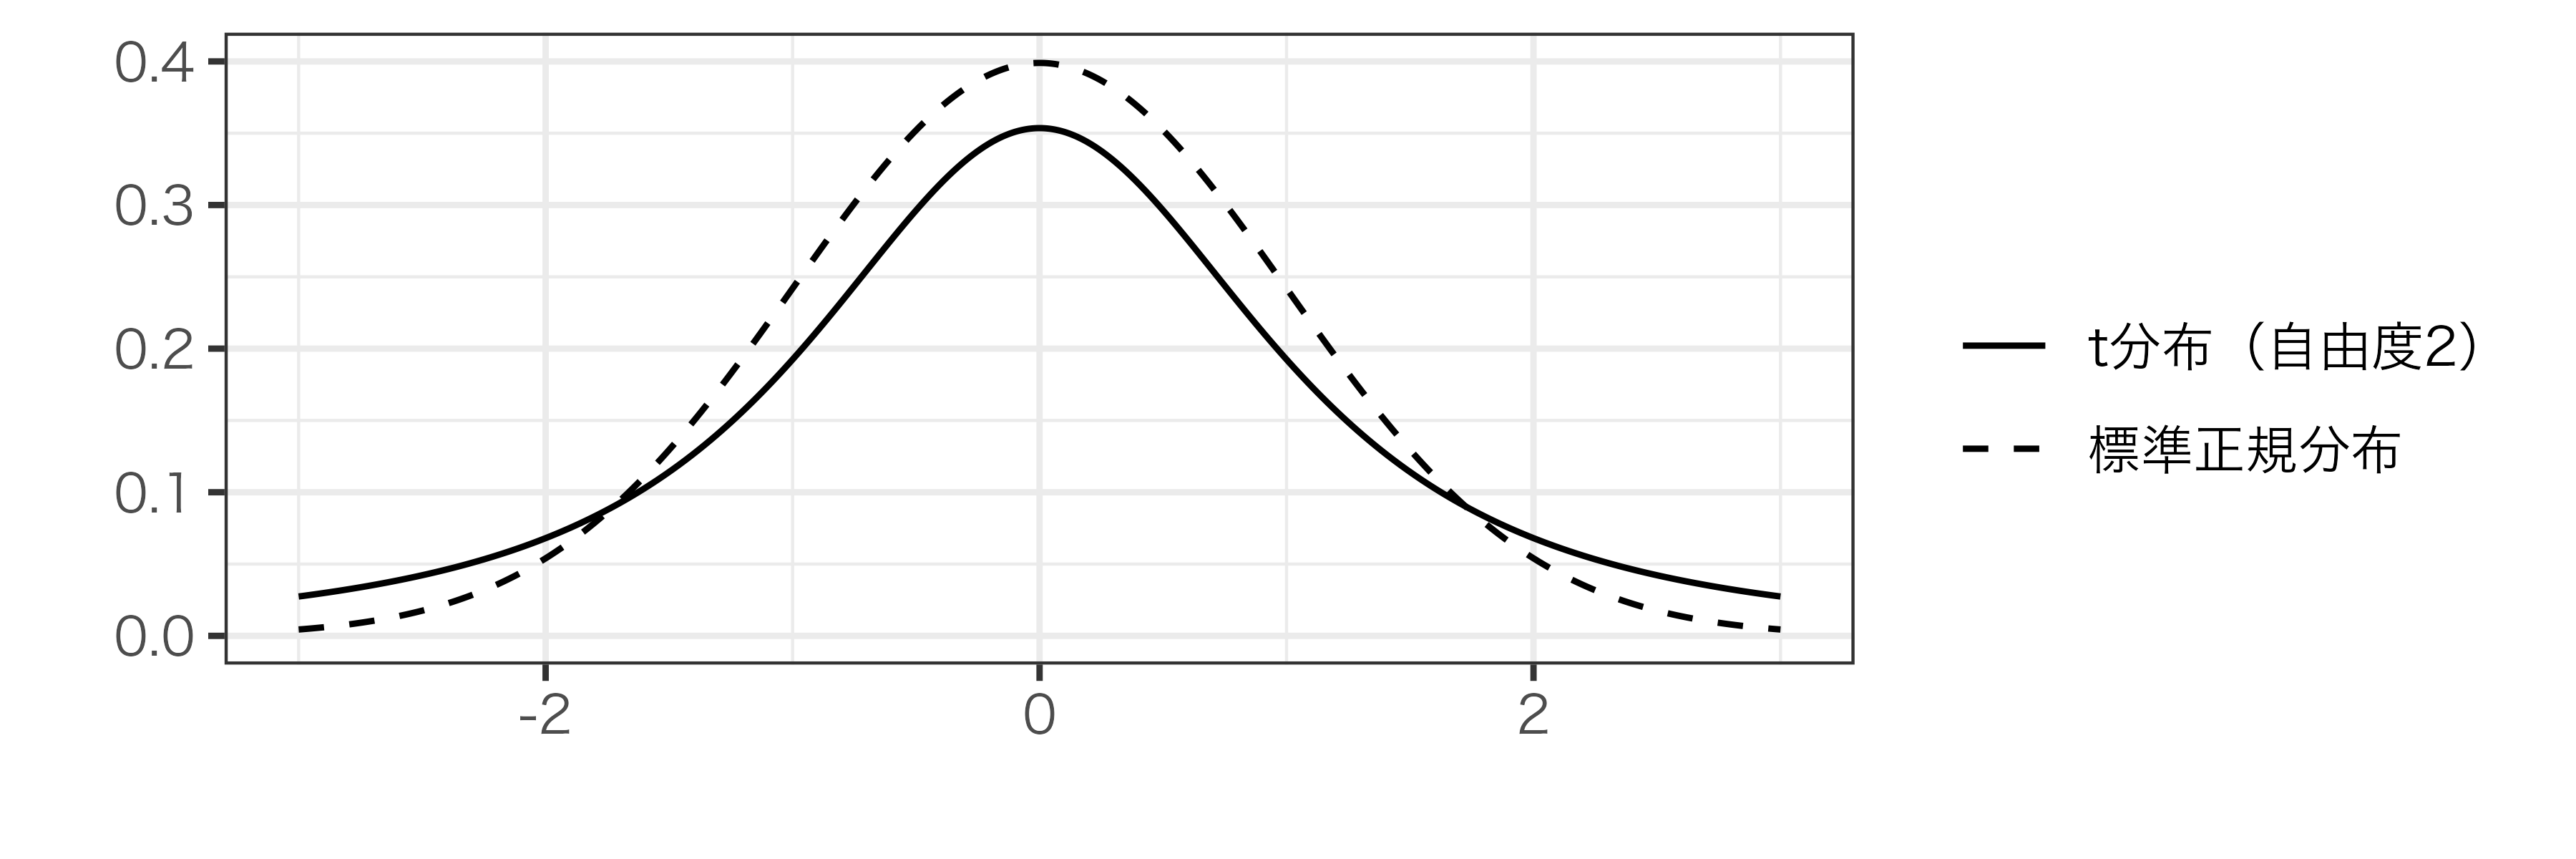
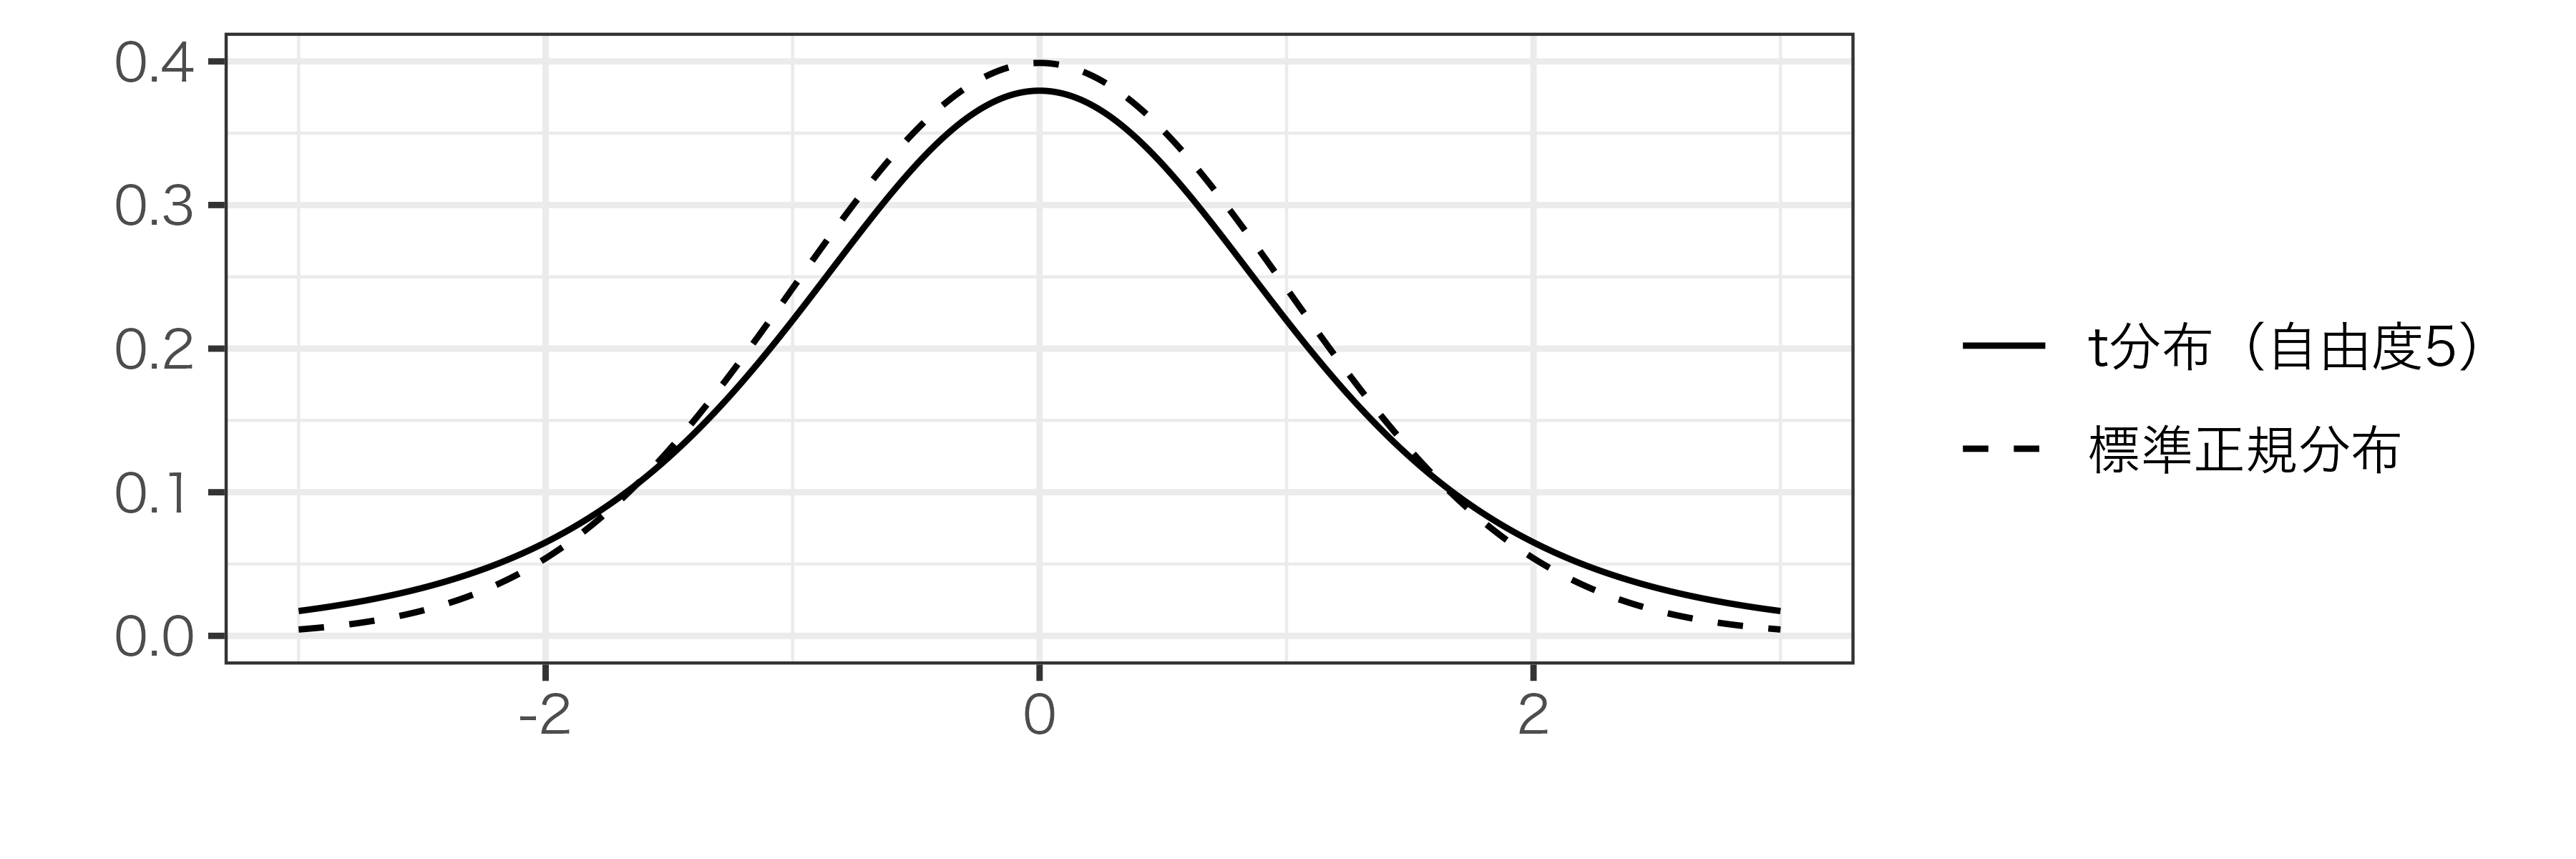
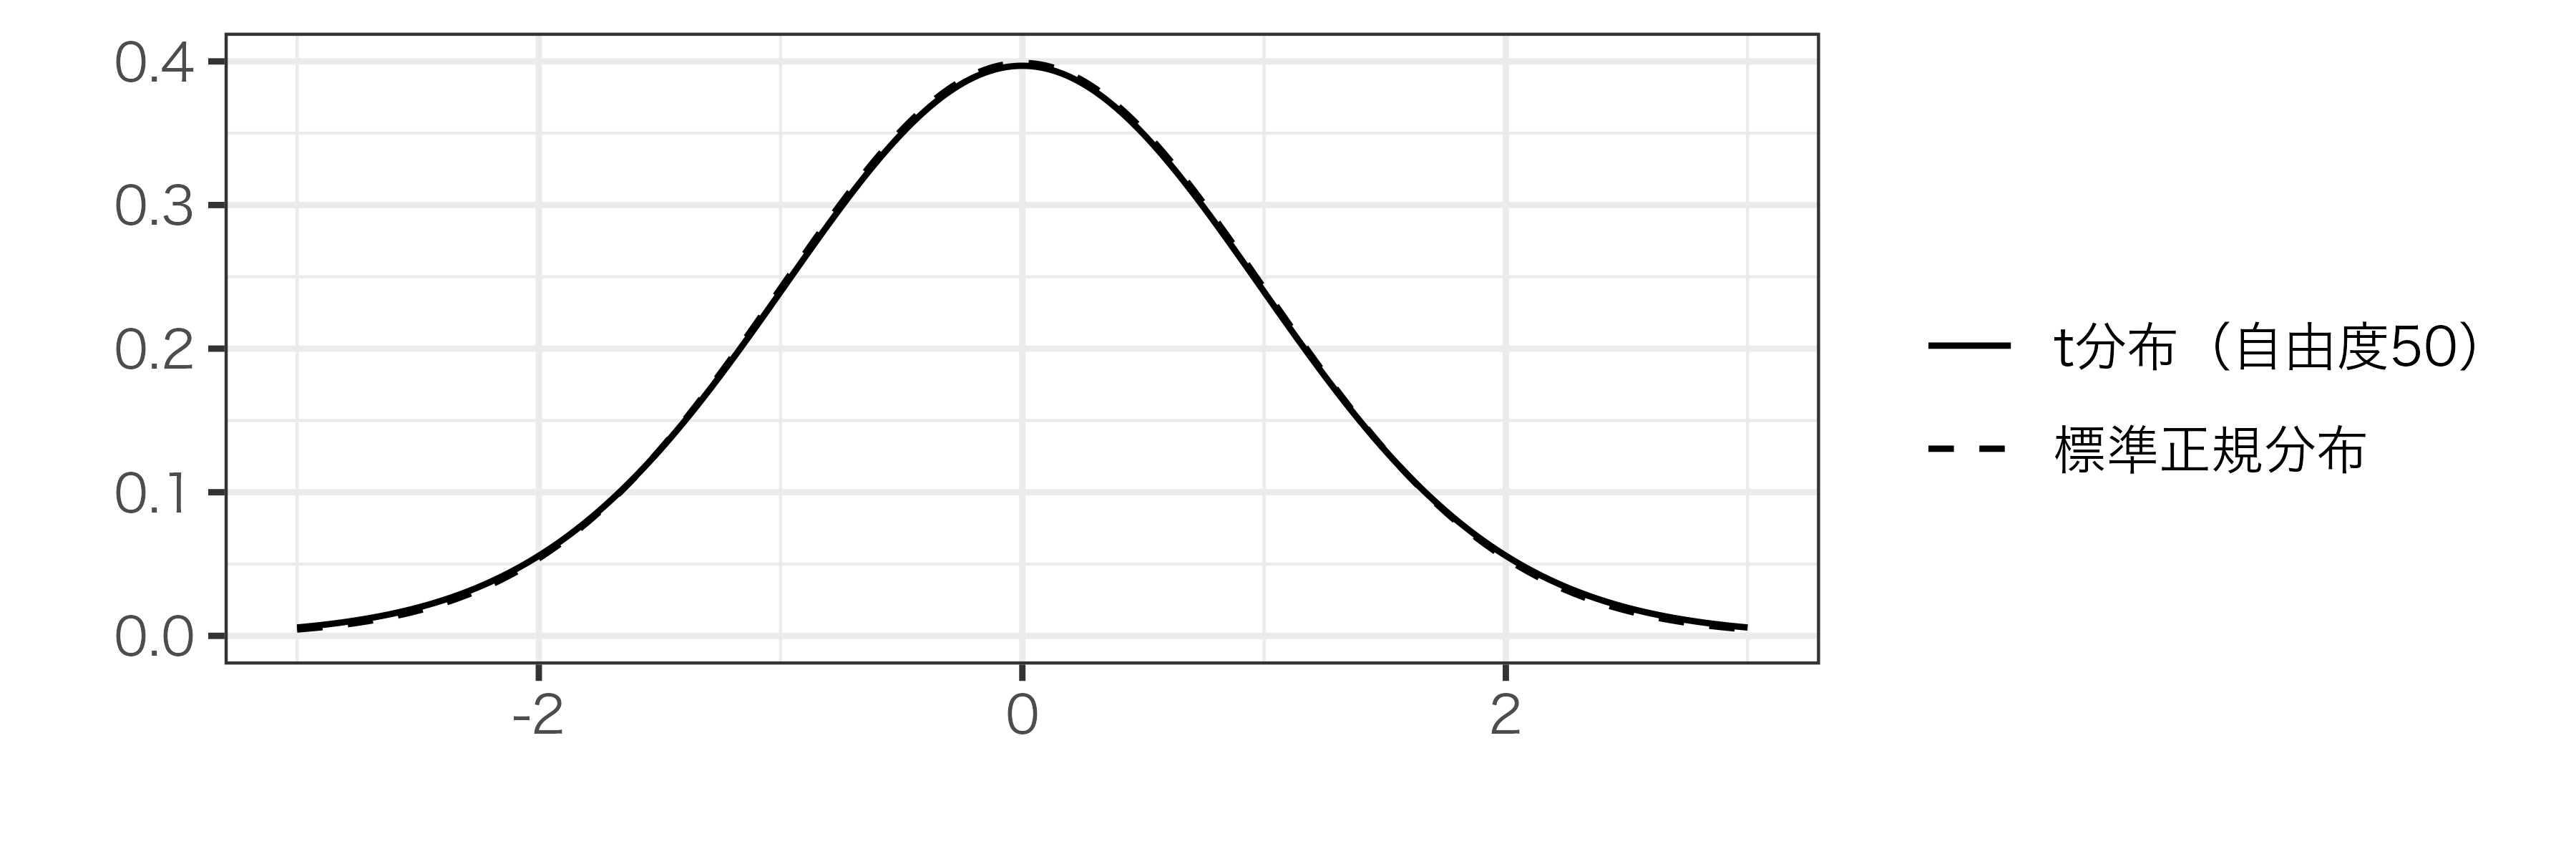
\(t\)分布は正規分布に似ているが、一応別の分布

  • 自由度(\(N-k\))によって形が変わる
    • \(N\)はサンプルサイズ、\(k\)は変数の数
  • 自由度が小さい時は裾が厚く、自由度が大きくなるにつれて標準正規分布1に近づく
    • サンプルが十分大きければ、標準正規分布とみなしてよい

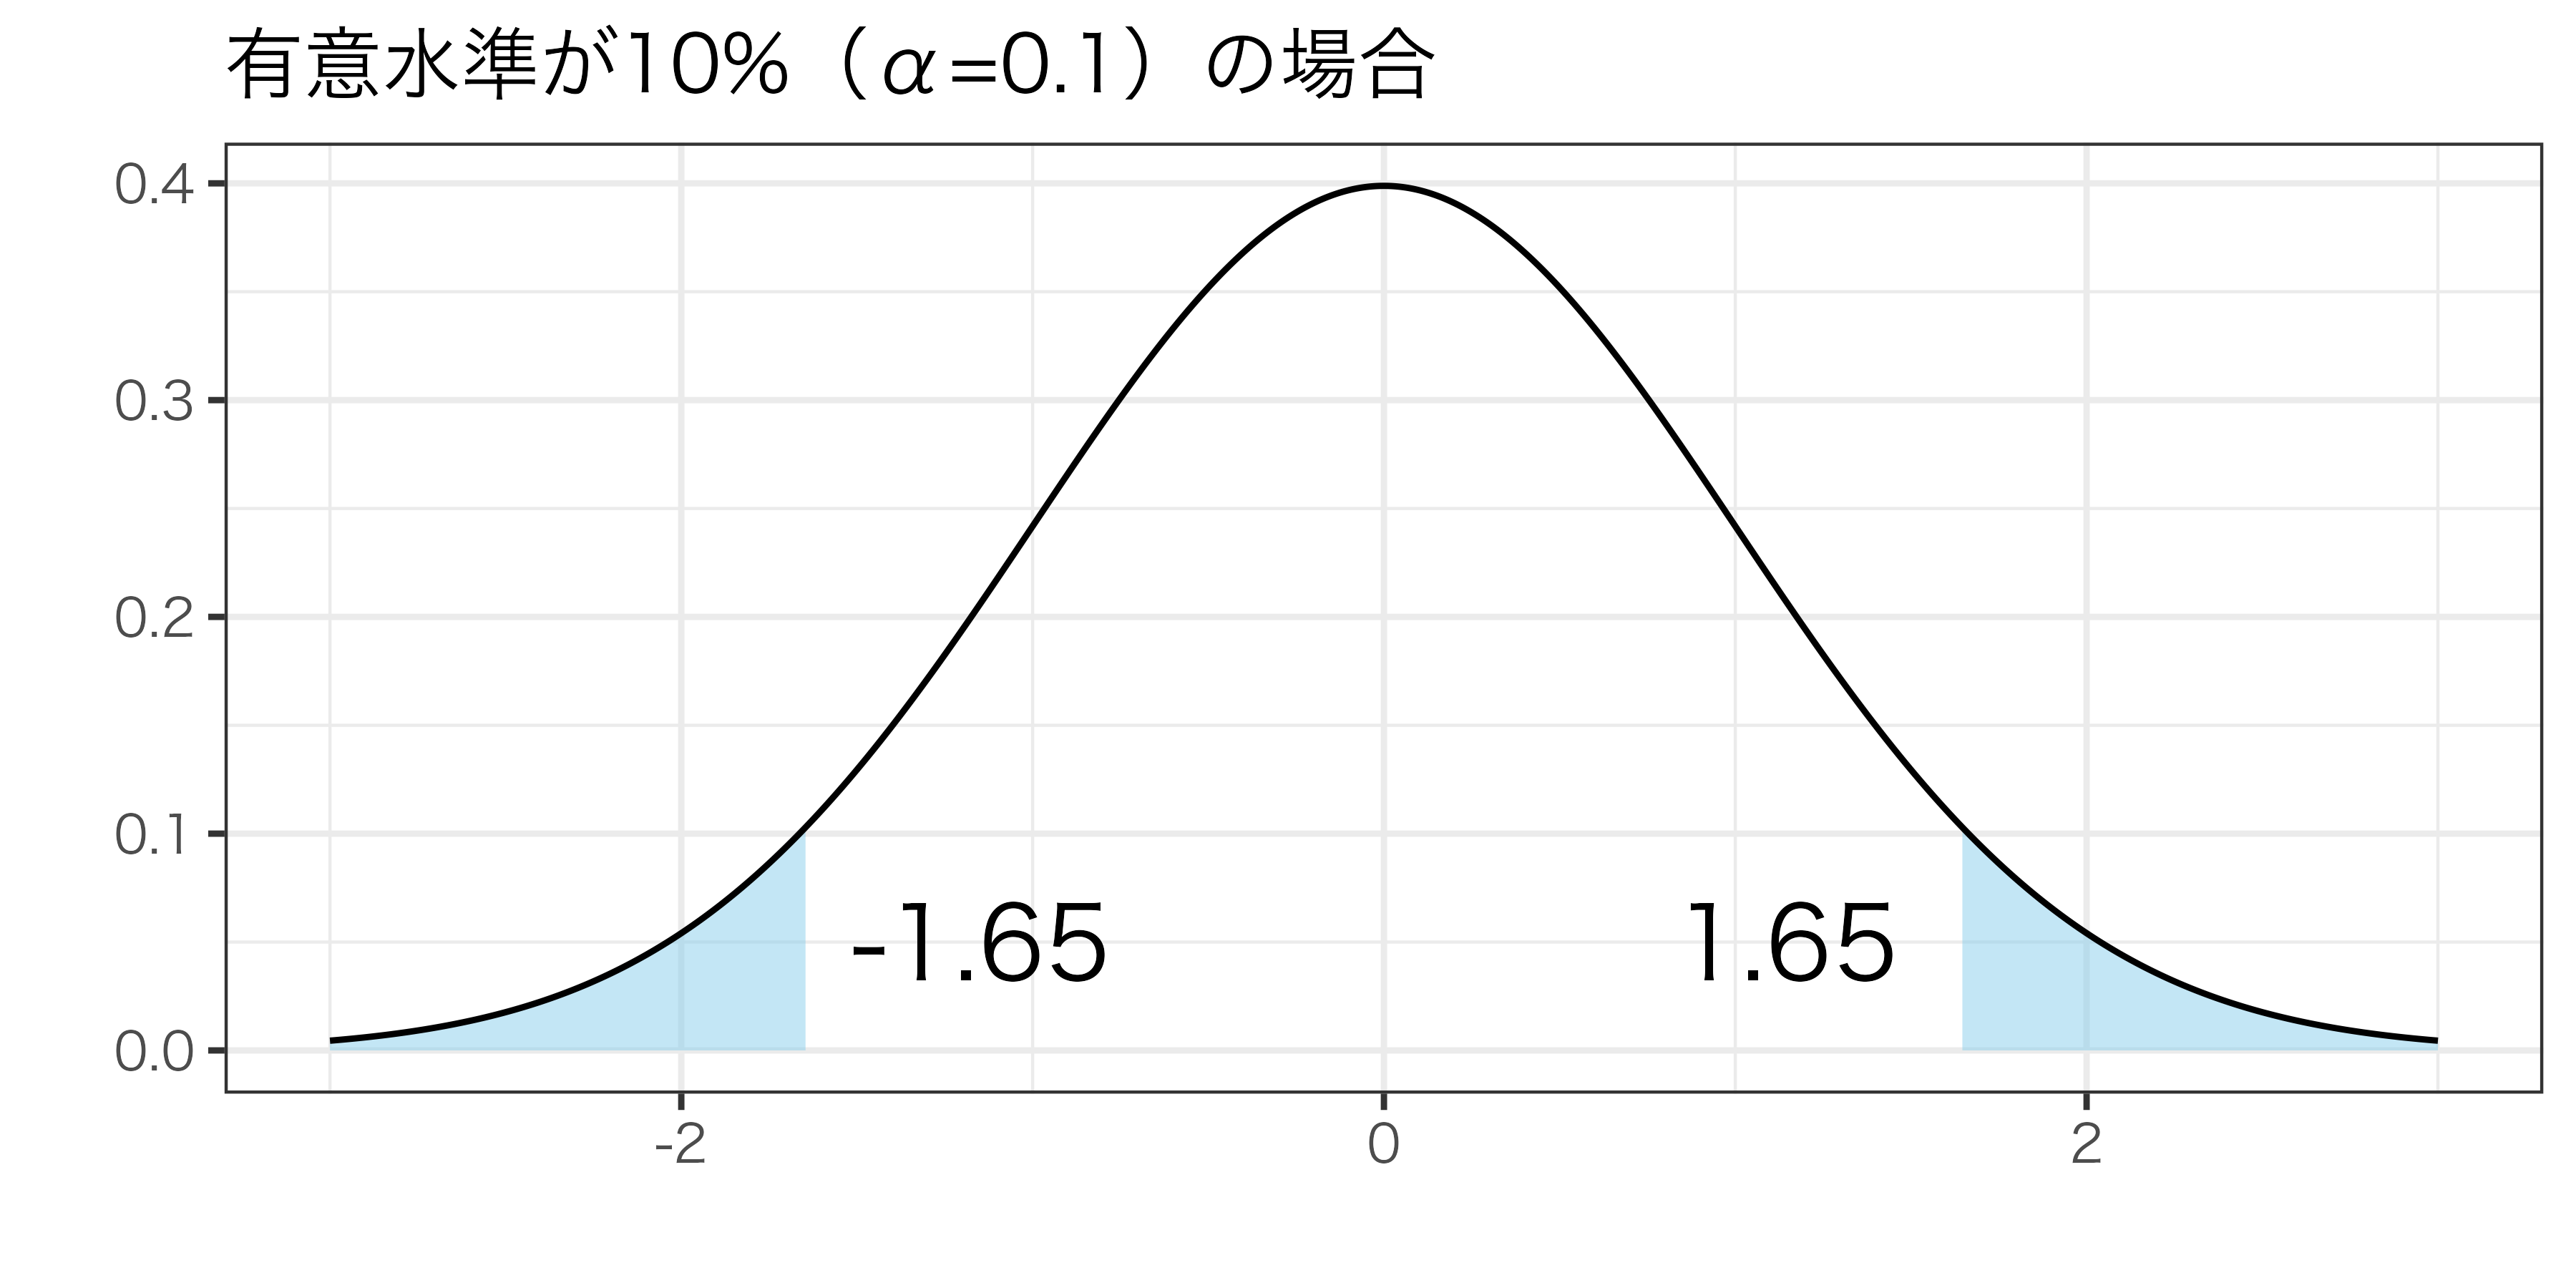
臨界値

統計的に有意かどうかを判断するための閾値
例:大統領選挙

アメリカ大統領選挙のデータを使って、以下のモデルを推定

\[ 得票率_t=\beta_{0}+\beta_{1}所得の変化率_t+\varepsilon_{t} \]

結果は次のとおり

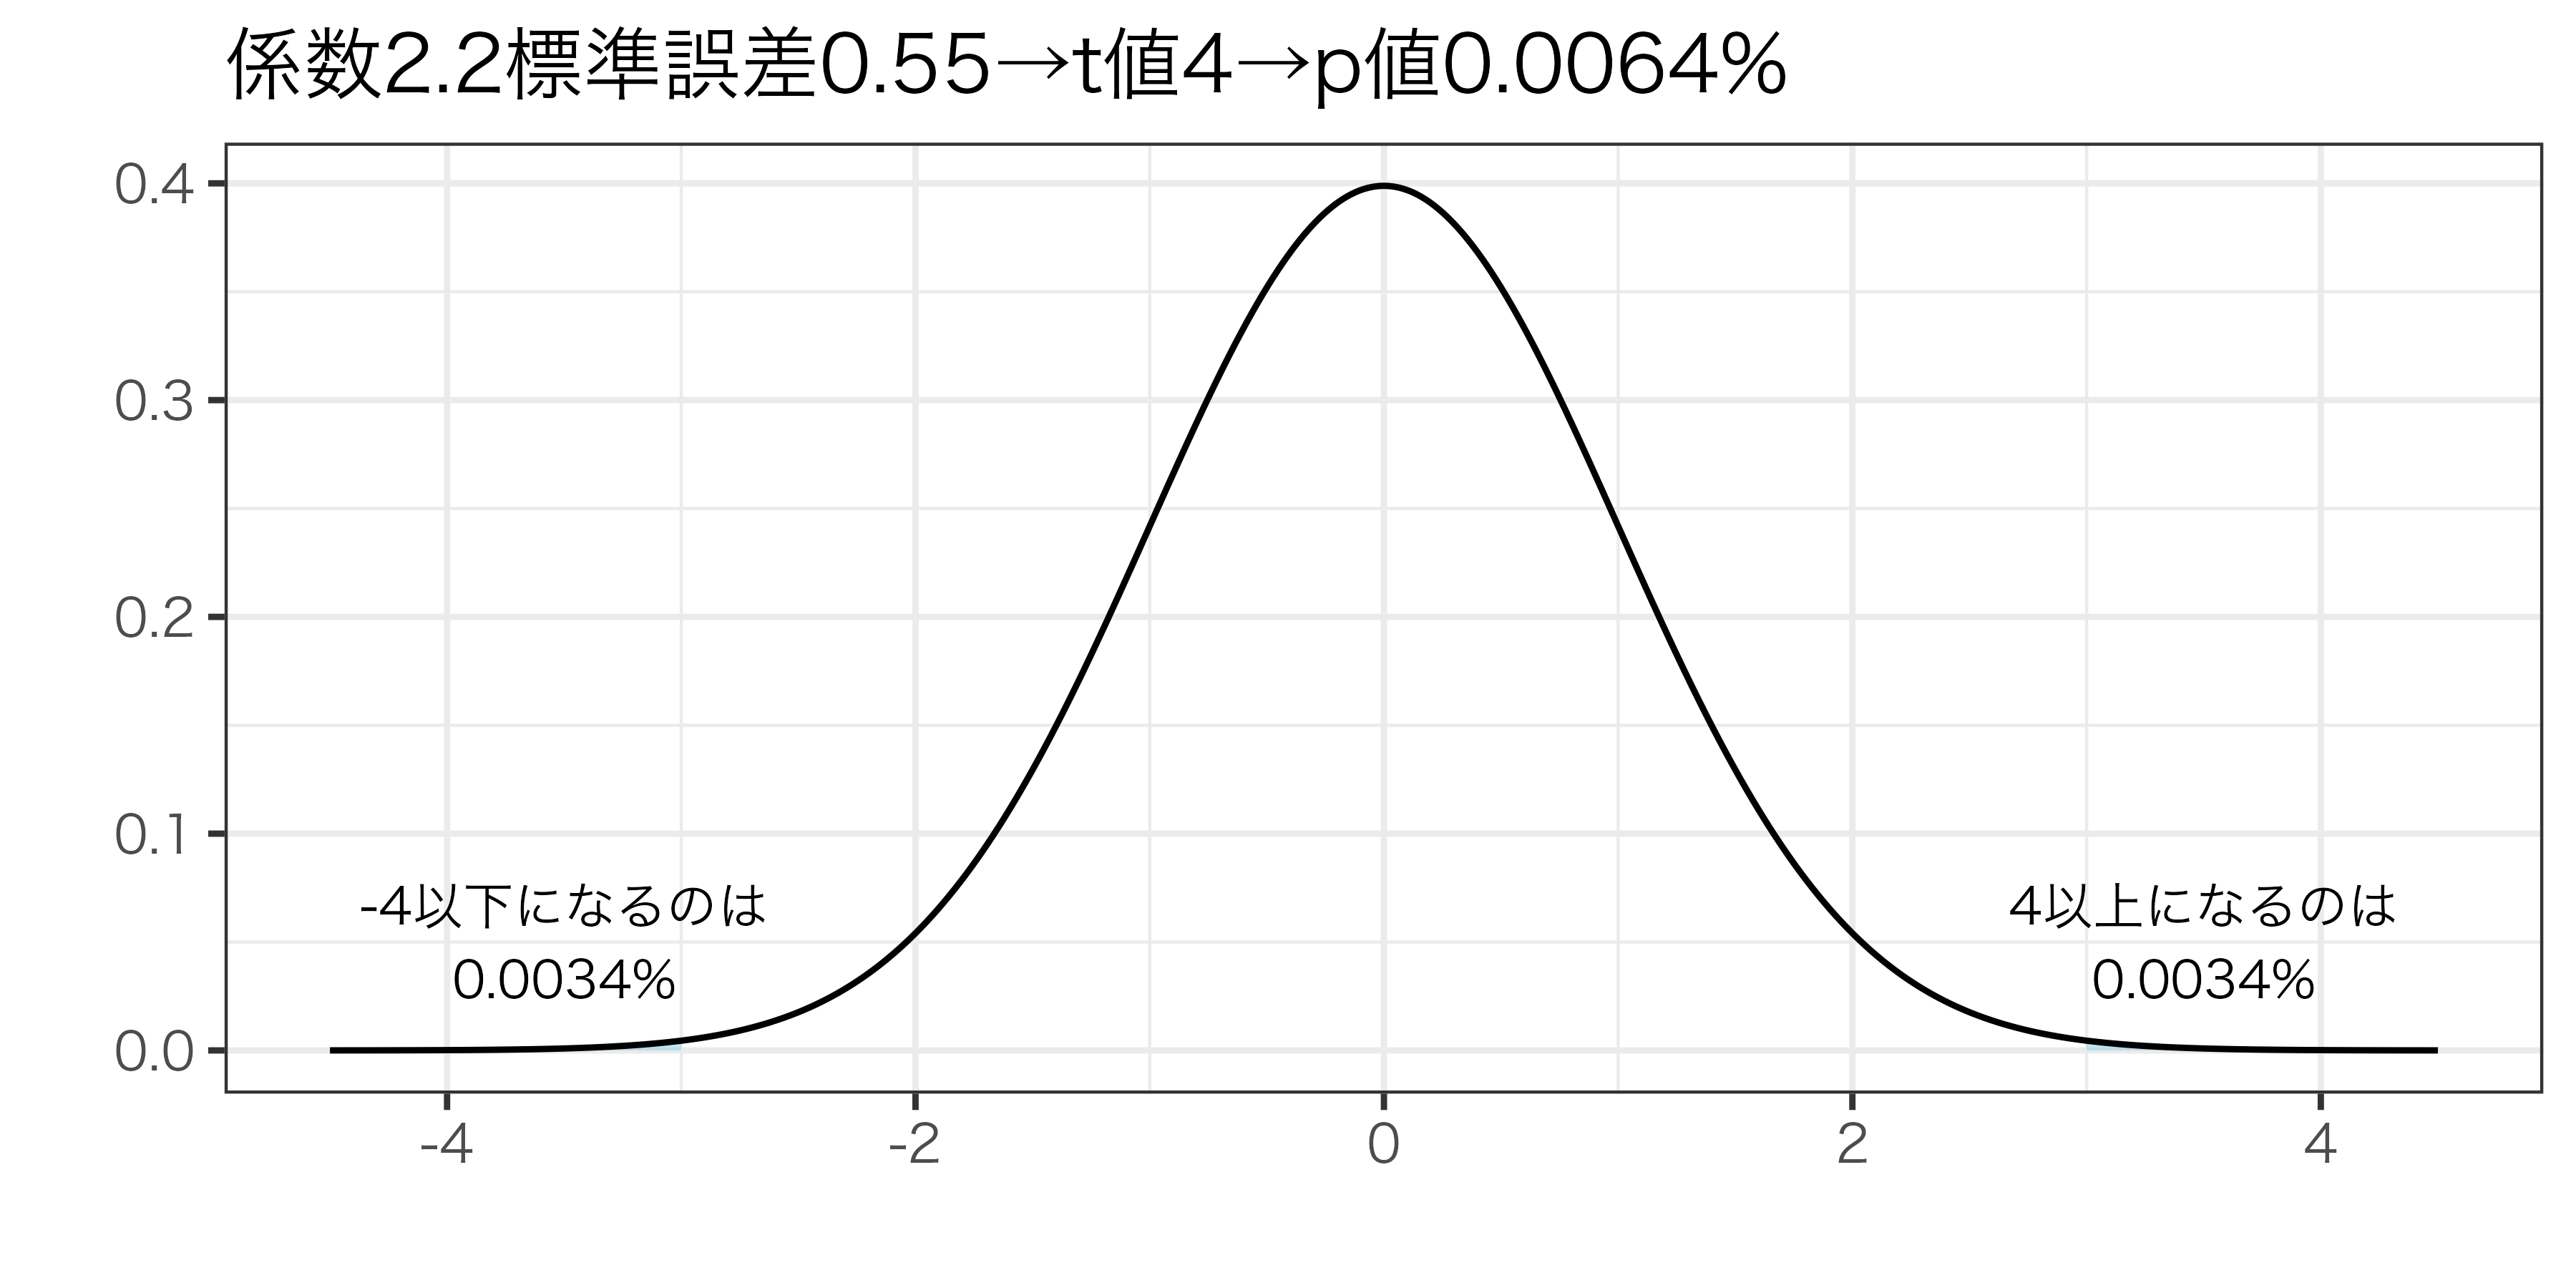
  • 傾きは\(\hat{\beta}_{1}=2.2\)、標準誤差は\(\operatorname{se}(\hat{\beta}_{1})=0.55\)
  • \(t\)値は\(\frac{\hat{\beta}_{1}}{\operatorname{se}(\hat{\beta}_{1})}\approx\frac{2.2}{0.55}=4>1.96\)→5%水準で統計的に有意

p値

p値(p-value)

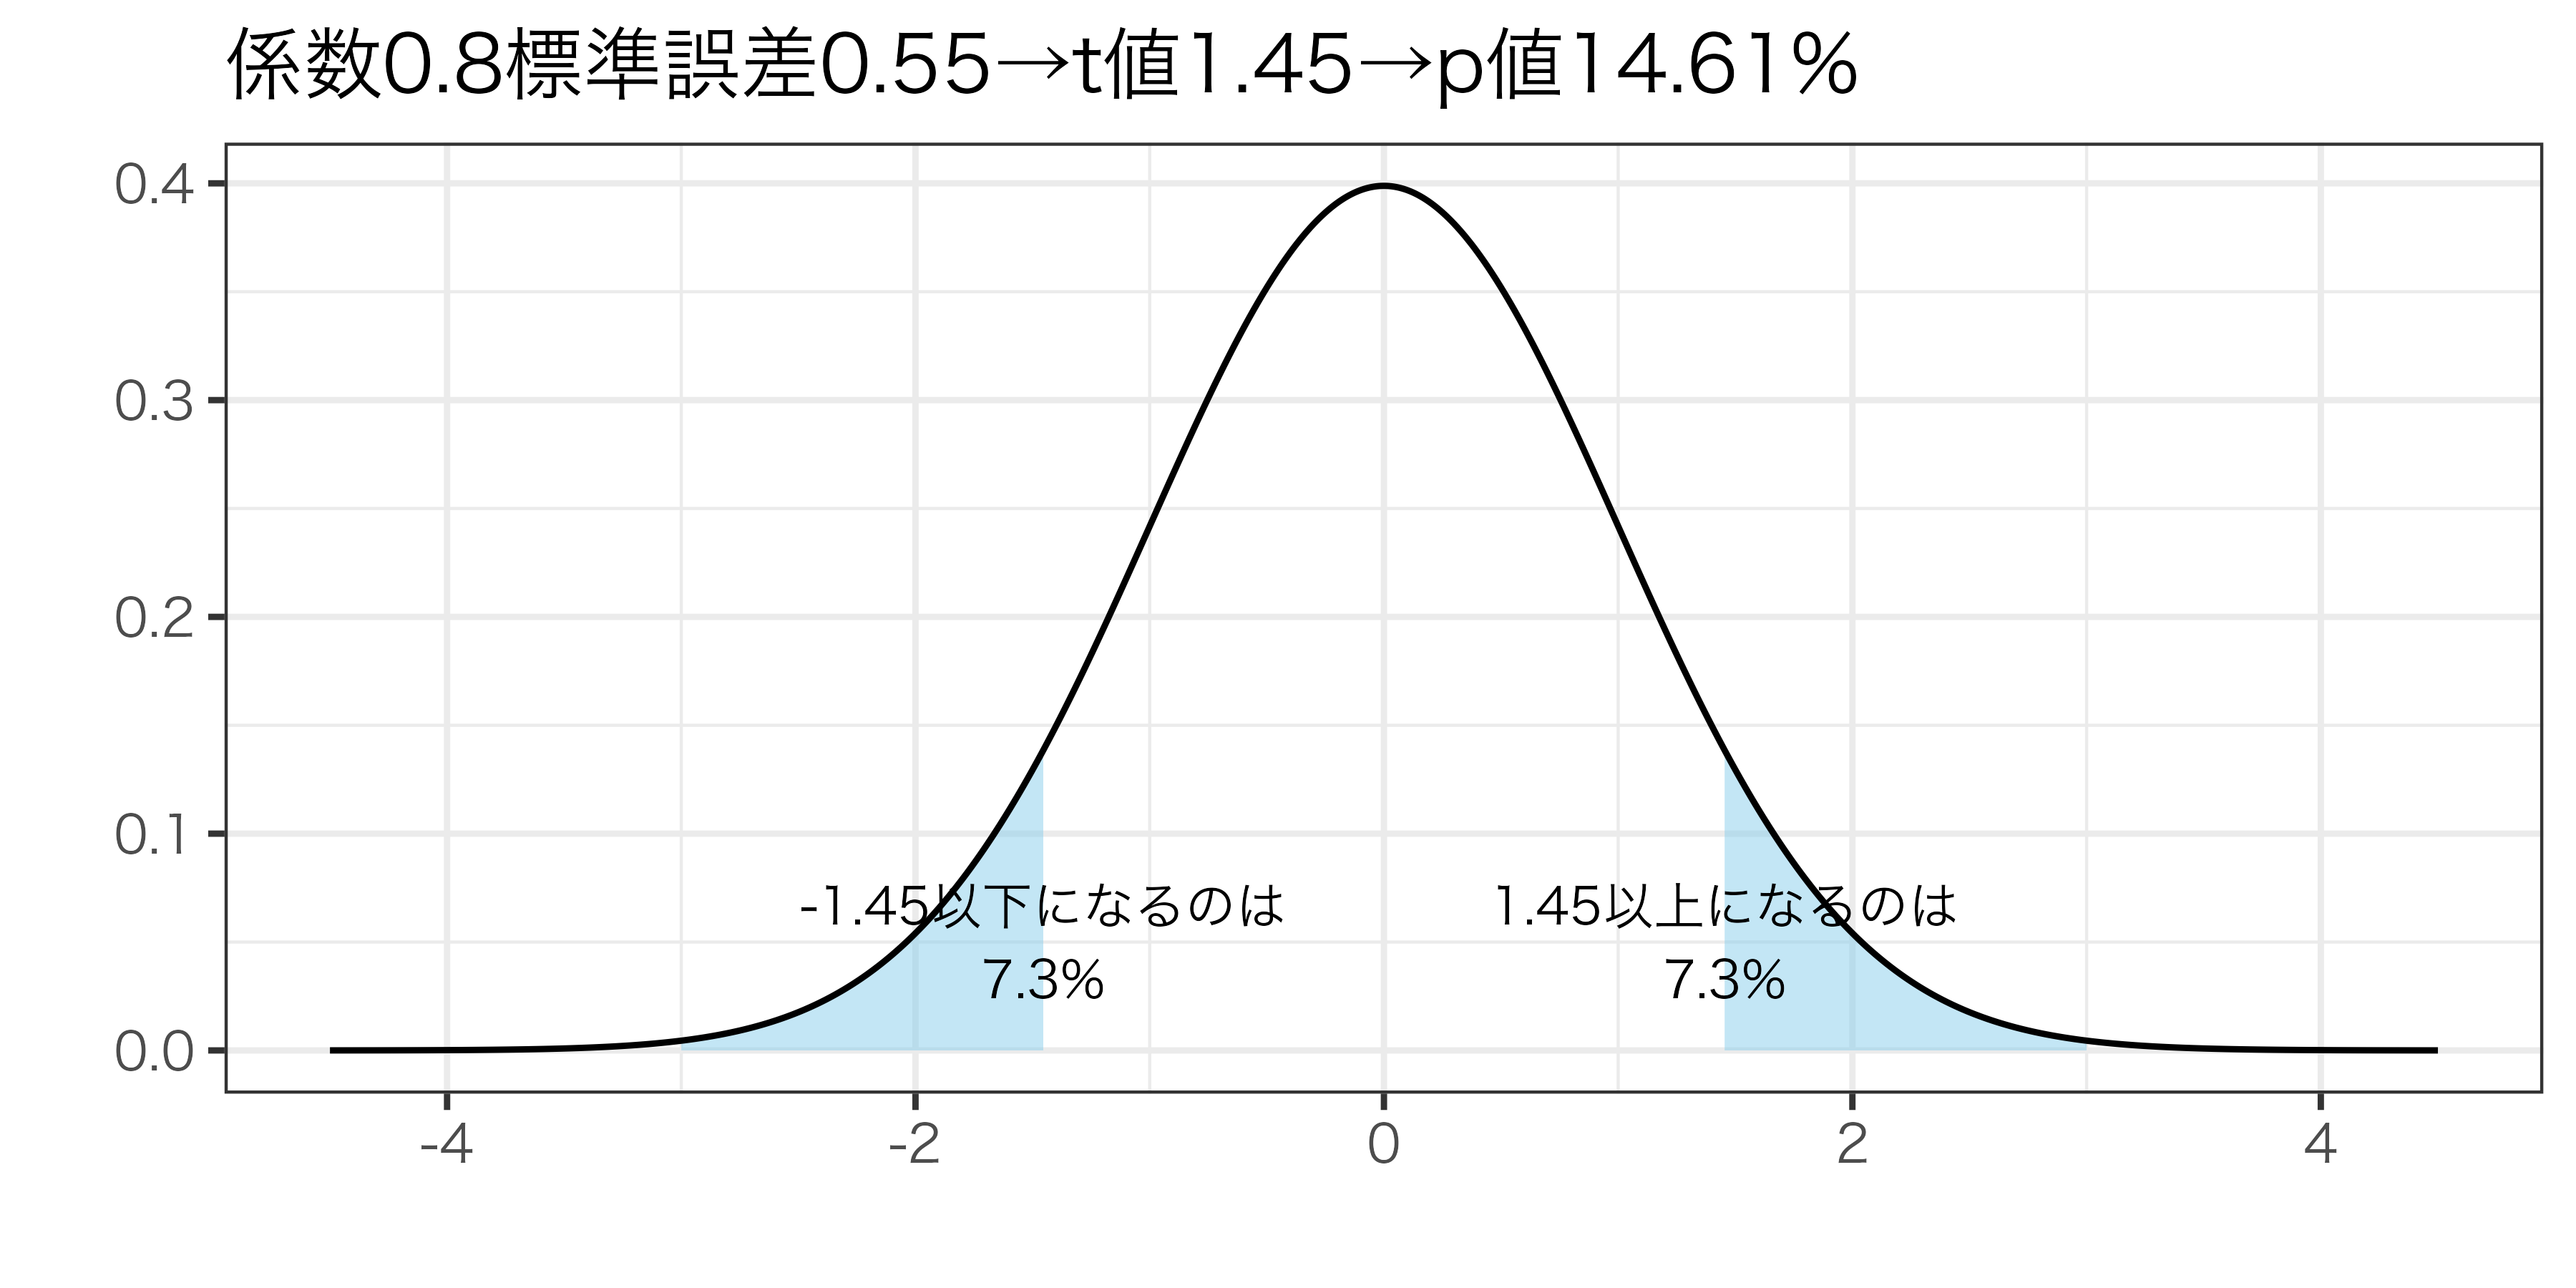
帰無仮説が正しいとして、推定された傾きの値よりも極端な値を観察する確率

  • \(p\)値が有意水準\(\alpha\)より下回っていれば統計的に有意
まとめ

本日の目的と到達目標

目的

統計的仮説検定の枠組みを学ぶ。仮説検定の基本的な手順を紹介し、帰無仮説や対立仮説、第1種/第2種の過誤など基本的な概念を習得する。続いてOLS推定値における仮説検定である\(t\)検定の手順について学び、その中でも最も重要な\(p\)値という概念を理解する。

到達目標

  1. 帰無仮説・対立仮説・有意水準という言葉を用いて、統計的仮説検定の基本的な手順を説明できる。
  2. 第1種/第2種の過誤の違いと、両者の関係を説明できる。
  3. OLSの係数と標準誤差に言及しつつ、\(t\)検定の基本的な考え方を説明できる。
  4. \(p\)値の意味を説明し、それを用いて統計的有意性を判断できる。
  5. OLSの推定結果から統計的有意性を判断し、その結果を適切に解釈できる。

次回までに

事後学習

  • 授業資料を見直し、目標到達をセルフチェック
  • WebClass上での確認小テスト(金曜日まで)

事前学習

  • 教科書(第4章4.4-4.5: pp.146-161)を読む。