実習の進行と到達目標
今回の実習ではスライドではなくこちらのファイルに沿って行う。到達目標は以下の通り。
WebClass上の出席登録も忘れずに!
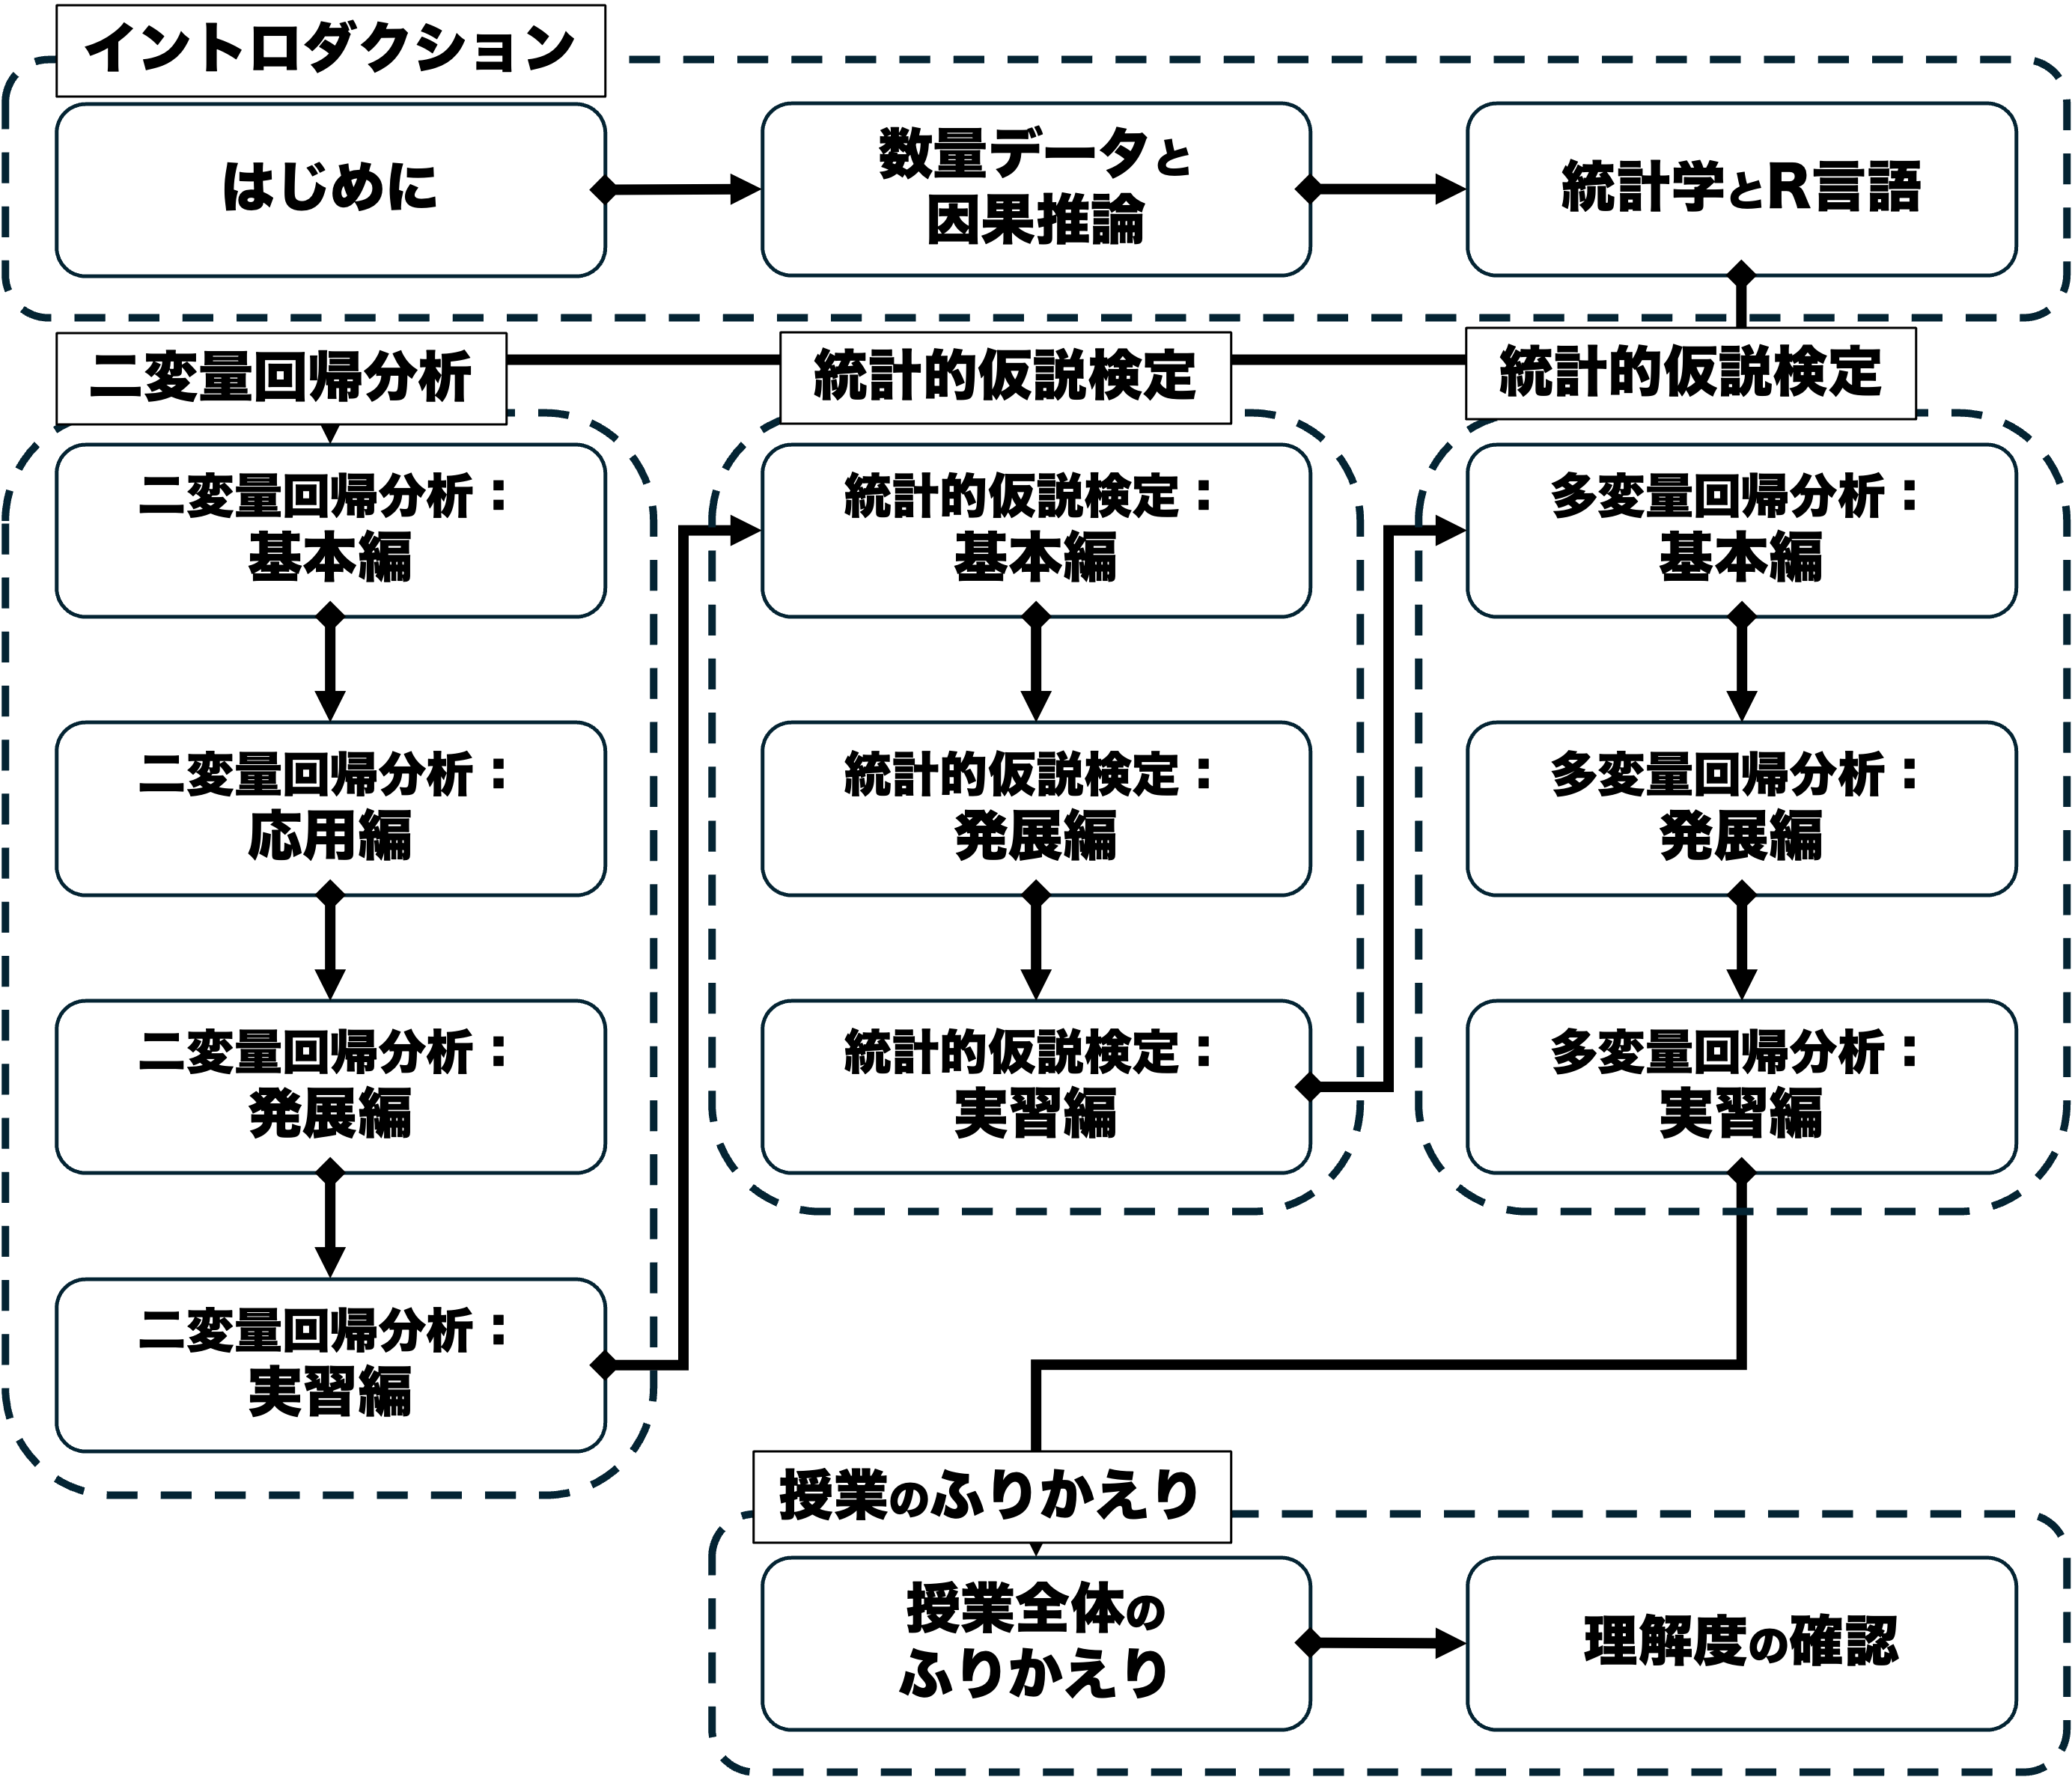
本日の授業の位置付け
小テストの講評
受験者数188人
平均5.38/6点
標準偏差1.14点
最小値1点
最大値6点
大変良くできました。注意なのは問5と問6(→正答 )
実習の準備
Posit Cloudの準備
Posit Cloudにログインし、前回のWorkspace(例えば「ICPA2」)に入ったら、以下の準備を行おう。
セッションのリスタート:最上部ツールバーのSession>Restart R
オブジェクトのクリア:右上Environmentの🧹をクリック
コンソールのクリア:Consoleペーン右上の🧹をクリック(色が見づらいが🔍の隣にある)
新しいスクリプトの作成と保存:ツールバーFile直下のアイコンからR Script
データのインポート
次に今回の実習で使うドーナツデータ(donuts.RDS)をダウンロードしインポートする
WebClassにアクセスし「第7回R実習データ(ドーナツ)」からデータをダウンロード
PositCloud上にアップロードした上でdta <- readRDS("donuts.RDS")を実行しインポート
データフレームオブジェクト
ここまで済んだら、ドーナツデータはdtaというオブジェクト に保存されていることがEnvironmentペーンを見るとわかる。復習になるがオブジェクトとは数値やデータを格納しておく箱のようなもので、後で自由自在に呼び出すことができる。今回のdtaはオブジェクトの中でもデータフレーム という形で保存されている。データフレームであれば以下のようにデータ構造を把握できる。
head (dta) # 上から6行目までのデータが表示される
            name male child donuts    weight
1          Homer    1     0  14.00 124.71655
2          Marge    0     0   0.00  63.94558
3           Lisa    0     1   0.00  31.74603
4           Bart    1     1   5.00  34.01361
5 Comic Book Guy    1     0  20.50 140.58957
6      Mr. Burns    1     0   0.75  36.28118
データを見ると5つの変数が含まれていることがわかる。コードブックは以下の通り。
name: 名前
male: その人が男性なら1、女性なら0を表すダミー変数
child: その人が子供なら1、大人なら0を表すダミー変数
donuts: その人が1週間あたりに食べるドーナツの数(個)
weight: その人の体重(kg)
記述統計
記述統計
データを入手したらまず行うことは記述統計の作成である。以下のコマンドで体重の記述統計の作成を行える。
sum (is.finite (dta$ weight)) # 観察数:体重 mean (dta$ weight, na.rm = TRUE ) # 平均:体重 sd (dta$ weight, na.rm = TRUE ) # 標準偏差:体重 min (dta$ weight, na.rm = TRUE ) # 最小値:体重 max (dta$ weight, na.rm = TRUE ) # 最大値:体重
Rの関数と引数
ここで平均を計算するmean()関数を見てみよう。一般に関数の中に書き込むもの引数 (ひきすう:argument)と呼ぶ。mean()の最初の引数には平均を計算したいベクトル形式のオブジェクトを書き込む。次のna.rm = TRUEは欠損値を無視するというオプションを指定する引数である。
なおここで今回の第一引数はdta$weightとなっている。$演算子を使うことで、データフレームの中の変数ベクトルを取り出すことができる。したがって変数をドーナツに変える場合は以下のようにする。
sum (is.finite (dta$ donuts)) # 観察数:ドーナツ mean (dta$ donuts, na.rm = TRUE ) # 平均:ドーナツ sd (dta$ donuts, na.rm = TRUE ) # 標準偏差:ドーナツ min (dta$ donuts, na.rm = TRUE ) # 最小値:ドーナツ max (dta$ donuts, na.rm = TRUE ) # 最大値:ドーナツ
散布図の作成
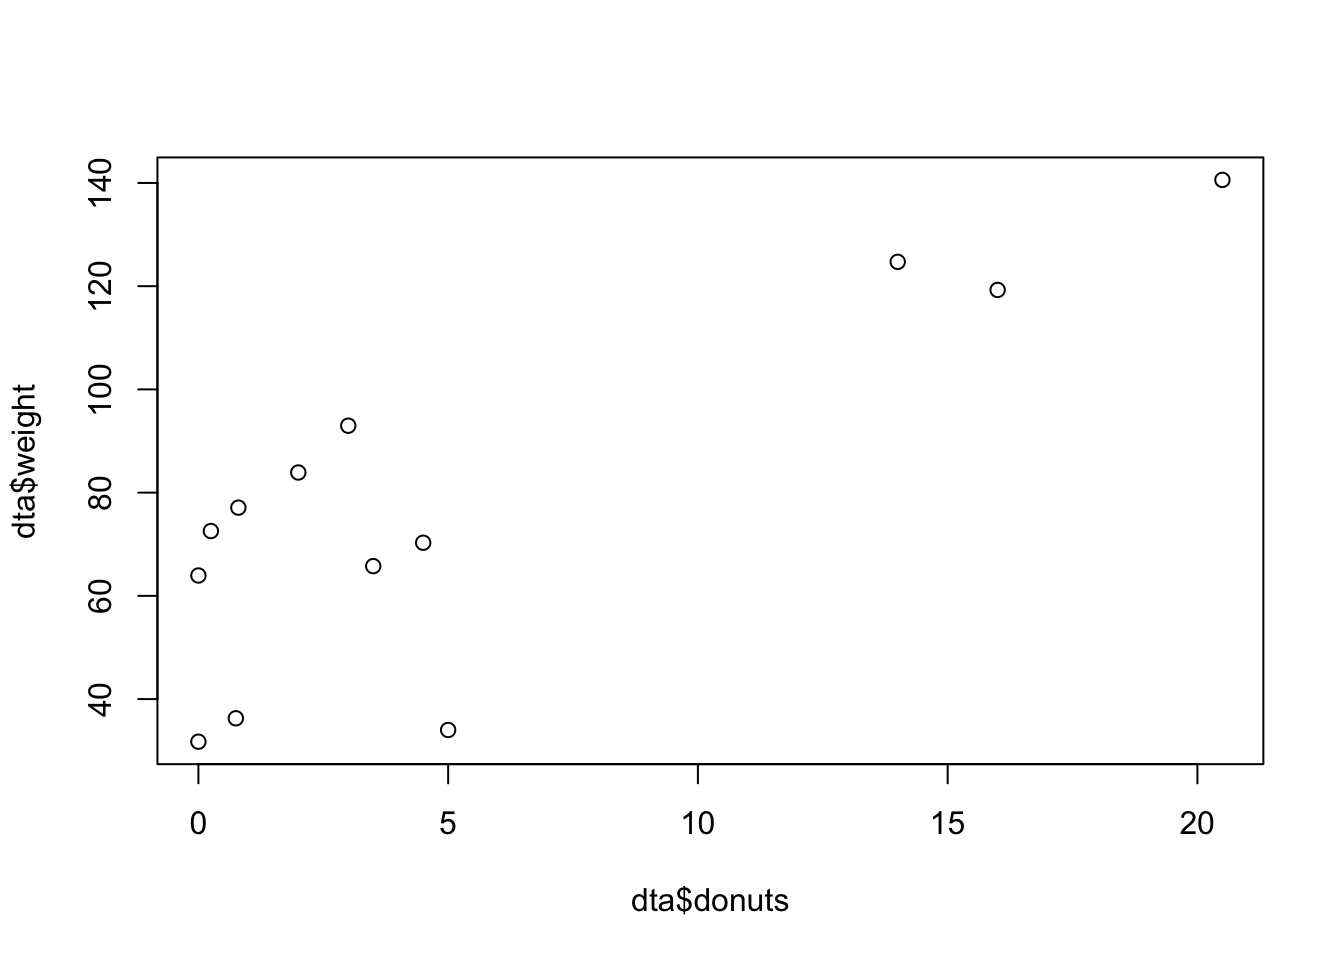
記述統計の次に行うべきは散布図の確認である。ドーナツを食べるほど体重は増えるのか、散布図をプロットして変数間の関係を確認できる。また、どれが外れ値なのかも確認できる。以下のコマンドと実施結果を見る限り、ドーナツを食べると体重は増えそうである。外れ値はなさそうである。
plot (dta$ donuts, dta$ weight)
二変量回帰分析
二変量モデルのOLS推定
独立変数\(X\) と従属変数\(Y\) を以下のようにモデル化する。
\[
Y_i=\beta_{0}+\beta_{1}X_i+\varepsilon_{i}
\]
この時、\(\beta_{0}\) は切片で、\(X\) の値が0の時の\(Y\) 、\(\beta_{1}\) は傾きで\(X\) の値が1単位増大した時に\(Y\) がどれくらい増えるか、\(\varepsilon\) は誤差項で、\(X\) 以外に\(Y\) に影響を与える要因全てである。
傾き\(\beta_{1}\) と切片\(\beta_{0}\) をそれぞれ最小二乗法 (OLS)を使って推定した値をそれぞれ\(\hat{\beta}_{0}\) と\(\hat{\beta}_{1}\) とすると、以下の通り計算される(\(\bar{X}\) と\(\bar{Y}\) はそれぞれ\(X\) と\(Y\) の平均)。
傾き:\(\hat{\beta_{1}}=\frac{\sum(X_i-\bar{X})(Y_i-\bar{Y})}{\sum(X_i-\bar{X})^2}\)
切片:\(\hat{\beta_{0}}=\bar{Y}-\hat{\beta_{1}}\bar{X}\)
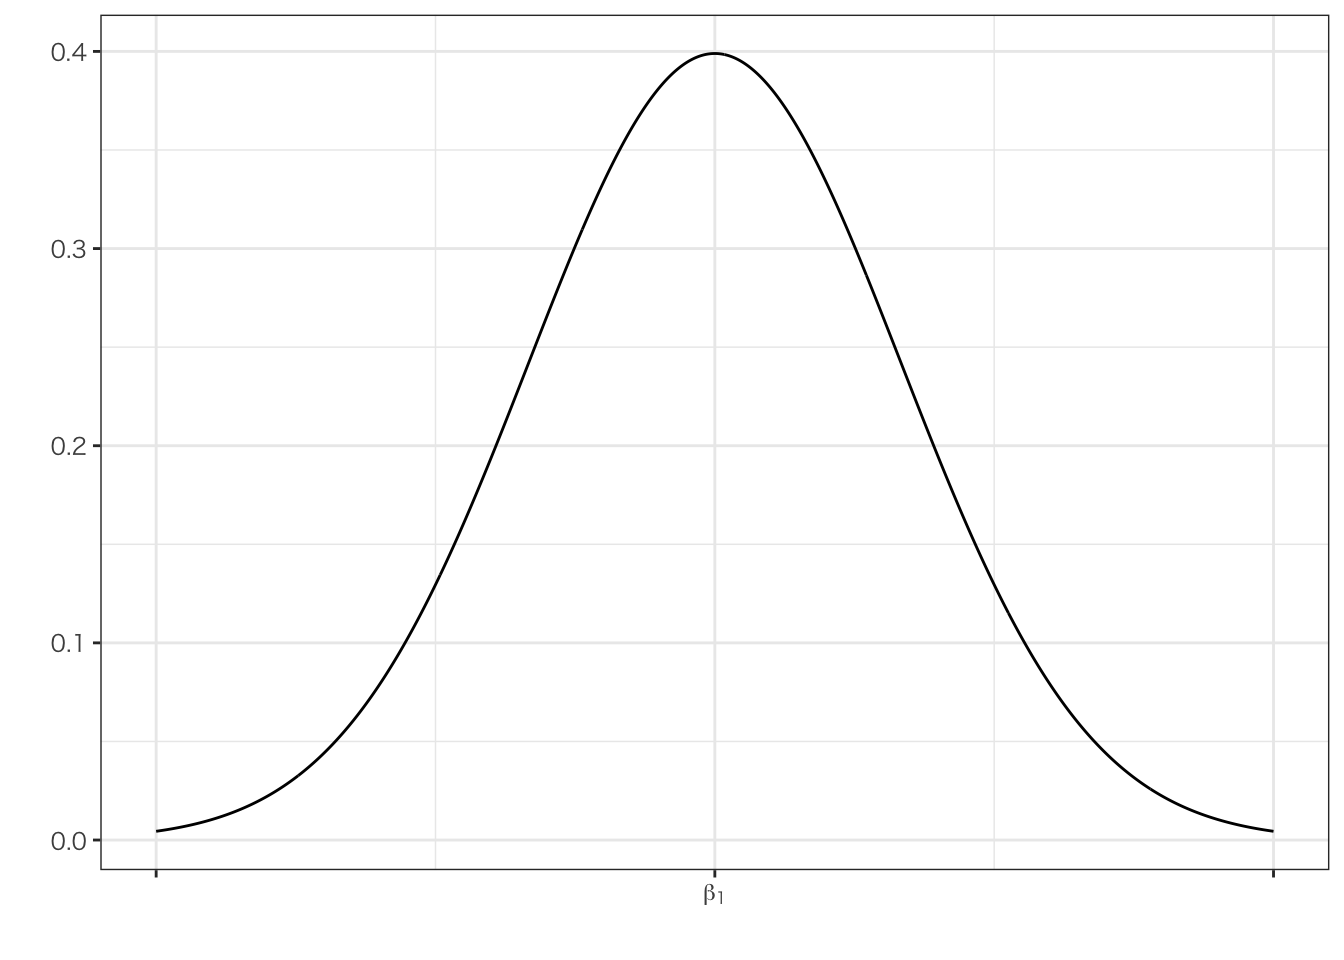
上記のOLS推定値のばらつきを標準誤差 (standard error)と呼ぶ。一定の条件を満たす場合、傾き\(\hat{\beta_{1}}\) の標準誤差は\(\operatorname{se}(\hat{\beta_{1}})=\sqrt{\operatorname{var}(\hat{\beta_{1}})}=\sqrt{\frac{\hat{\sigma}^2}{N\times\operatorname{var}(X)}}\) で計算できる。母集団における真の傾きを\(\beta_{1}\) とした場合、推定される\(\hat{\beta_{1}}\) は\(\beta_{1}\) を期待値、\(\operatorname{se}(\hat{\beta_{1}})=\sqrt{\frac{\hat{\sigma}^2}{N\times\operatorname{var}(X)}}\) を標準偏差とする正規分布にしたがう。
OLSの実装と解釈
OLS推定をR上で実施するにはlm()関数を使う。lm()関数に限らず、Rではコマンドのヘルプを?関数で閲覧できる。?lmと入力すると、lm()関数の使い方が載っている。lm()関数の第一引数はformulaであり、y ~ xのように従属変数と独立変数をモデル化する。data引数では使うデータを指定する。
ここでドーナツデータを使い、ドーナツと体重の二変量モデルをOLS推定してみよう。以下のコマンドで推定を実施し、OLS_resultというオブジェクトに保存できる。
<- lm (weight ~ donuts, data = dta)
このOLS_resultオブジェクトをもう一度コンソールに打ち込んでも良いが、これだと結果がシンプルすぎる。以下のようにsummary()を使って結果をわかりやすく表示できる。
Call:
lm(formula = weight ~ donuts, data = dta)

Residuals:
    Min      1Q  Median      3Q     Max
-42.238  -4.299   0.343  15.922  24.976

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)  55.6080     7.4200   7.494 1.21e-05 ***
donuts        4.1287     0.8707   4.742 0.000608 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 20.68 on 11 degrees of freedom
Multiple R-squared:  0.6715,    Adjusted R-squared:  0.6416
F-statistic: 22.48 on 1 and 11 DF,  p-value: 0.0006078
上記で注目すべきはまずCoefficietsの欄である。
Estimateはそれぞれ切片(intercept)とdonutsの傾きを表している。(intercept)が55.6ということは、ドーナツを全く食べていない場合の平均体重は55.6キロ程度ということである。donutsの傾きは4.13だが、これはドーナツを週一個多く食べるごとに体重が4.13キロ増えることを意味する。Std. Errorでは切片および傾きの標準誤差が表示されている。donutsの標準誤差を見ると0.87程度だが、これが傾きの推定値のばらつきを表している。t valueとPr(>|t|)は統計的仮説検定に関わる。詳細は次週以降。
次に決定係数\(R^2\) もわかる。下から2行目のMultiple R-squaredがそれで、この結果では0.67くらいである。体重のばらつきの67%がこのモデルで説明されていることを意味する。
分析結果を散布図上に書き込む
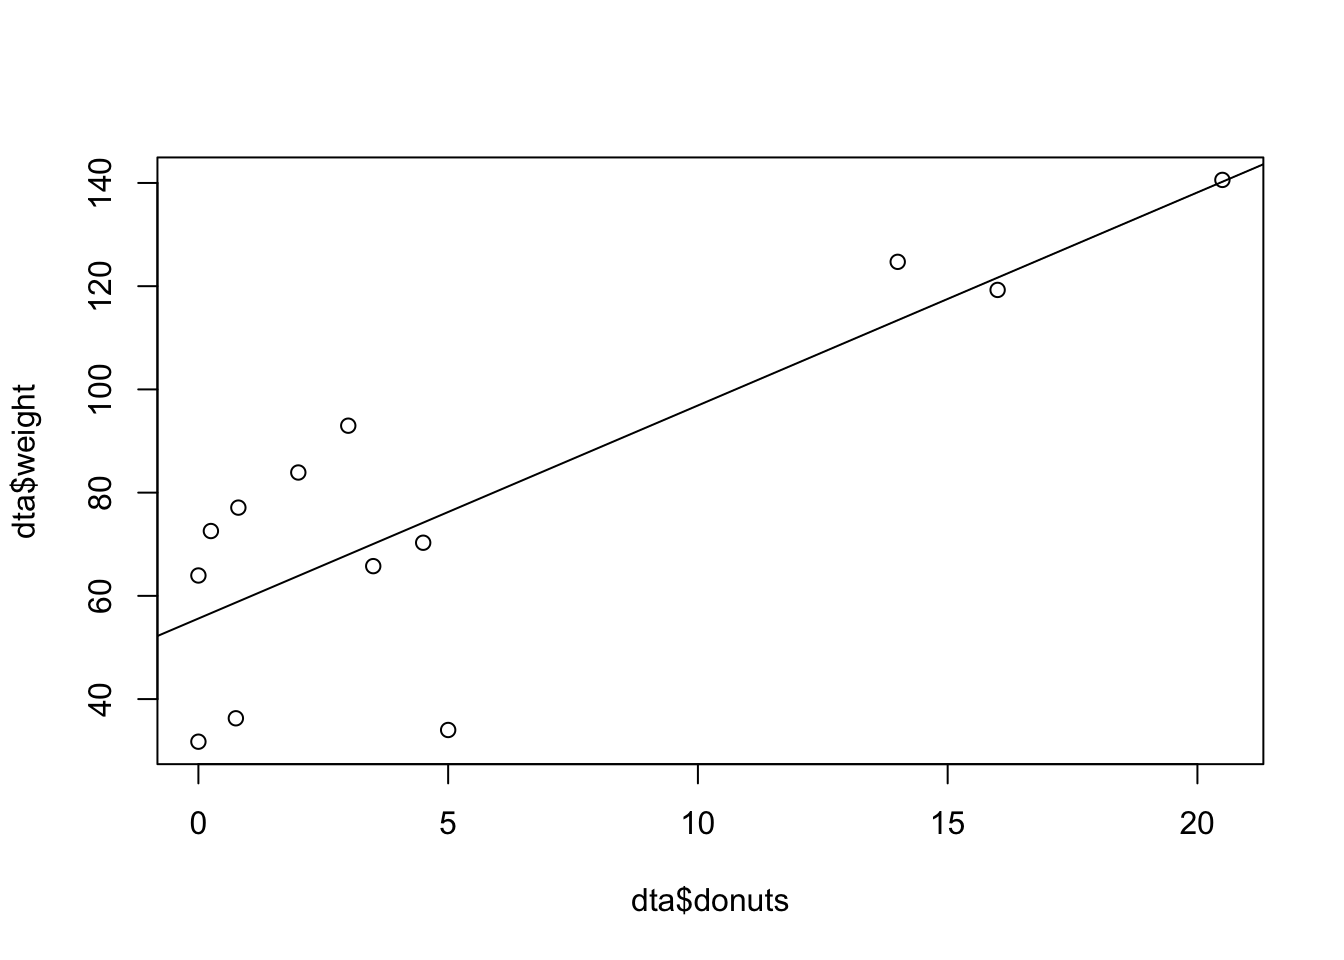
以上の分析から、ドーナツと体重の関係は\(体重_{i}=55.6+4.13\timesドーナツ_{i}\) であると推定された。この式が表す直線は以下のコマンドで散布図上に描ける。
plot (dta$ donuts, dta$ weight)abline (OLSresult)
一部のデータを使った分析
上記の分析では13人全員分のデータを使ってOLS推定を行ったが、lm()関数のsubsetオプションを使えば条件にあった一部のデータだけを使って推定できる。
例えば、男性だけで分析したい場合は以下のコマンドでできる。今回は切片が60.14、傾きが3.86になっているのに注意。
<- lm (weight ~ donuts, data = dta,subset = (male == 1 )) # ==と2回続けるのに注意 summary (OLSresult_Male)
Call:
lm(formula = weight ~ donuts, data = dta, subset = (male == 1))

Residuals:
   Min     1Q Median     3Q    Max
-45.40  -2.54  10.61  13.87  21.27

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)   60.140     10.883   5.526 0.000882 ***
donuts         3.855      1.081   3.565 0.009164 **
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 23.7 on 7 degrees of freedom
Multiple R-squared:  0.6448,    Adjusted R-squared:  0.594
F-statistic: 12.71 on 1 and 7 DF,  p-value: 0.009164
例えば、大人だけで分析したい場合は以下のコマンドで。切片は63.64、傾きは3.79になった。
<- lm (weight ~ donuts, data = dta,subset = (child == 0 )) # ==と2回続けるのに注意 summary (OLSresult_Adult)
Call:
lm(formula = weight ~ donuts, data = dta, subset = (child ==
    0))

Residuals:
     Min       1Q   Median       3Q      Max
-30.2010  -7.6807   0.3041   9.2366  17.9660

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)  63.6414     5.7463  11.075 1.52e-06 ***
donuts        3.7877     0.6287   6.025 0.000196 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 14.49 on 9 degrees of freedom
Multiple R-squared:  0.8013,    Adjusted R-squared:  0.7792
F-statistic:  36.3 on 1 and 9 DF,  p-value: 0.0001964
Homerを除外する場合は以下。切片は55.69、傾きは3.91。
<- lm (weight ~ donuts, data = dta,subset = (name != "Homer" )) # 名前は文字列なので""は忘れない。 # また!=はノットイコールを意味する。 summary (OLSresult_NoHomer)
Call:
lm(formula = weight ~ donuts, data = dta, subset = (name != "Homer"))

Residuals:
    Min      1Q  Median      3Q     Max
-41.229  -8.296   2.866  16.494  25.551

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)  55.6862     7.6486   7.281 2.66e-05 ***
donuts        3.9112     0.9688   4.037  0.00237 **
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 21.31 on 10 degrees of freedom
Multiple R-squared:  0.6198,    Adjusted R-squared:  0.5817
F-statistic:  16.3 on 1 and 10 DF,  p-value: 0.002371
頑健標準誤差(時間があれば)
傾き\(\hat{\beta_{1}}\) の標準誤差は基本的に\(\operatorname{se(\hat{\beta_{1}})}=\sqrt{\frac{\hat{\sigma}^2}{N\times\text{var}(X)}}\) で計算できるが、誤差項の均一分散や誤差項同士の相関がない場合に限られる。不均一分散や誤差項同士の相関が生じている場合には、頑健標準誤差 (robust standard errors)という別の計算式を使った標準誤差を使う。
実は頑健標準誤差はRのデフォルト機能では計算できない。ここで使うのはパッケージ である。パッケージとはRに機能を追加するもので、ゲームで言ったらMODとかに近い(多分)。今回はAERパッケージをインストールし、Rに組み込む。インストールはinstall.packages()でできるが、これは基本一回やればよい。その上でlibrary()コマンドを実行して、Rに組み込む。library()コマンドで組み込んだパッケージはセッションを立ち上げるたびにリセットされるので、その度に実行し直すこと。
install.packages ("AER" ) # これは一度だけで大丈夫
The downloaded binary packages are in
    /var/folders/hy/0rwqjktd7mb2ycrqdj1w7pgc0000gn/T//RtmpHhCSbp/downloaded_packages
library (AER) # これはセッションのたびに実行
Loading required package: car
Loading required package: carData
The following object is masked from 'package:dplyr':

    recode
The following object is masked from 'package:purrr':

    some
Loading required package: lmtest
Loading required package: zoo
The following objects are masked from 'package:base':

    as.Date, as.Date.numeric
Loading required package: sandwich
Loading required package: survival
以上ができたら、coeftest()関数で頑健標準誤差を計算できる。vcov = vcovHCオプションで不均一分散を考慮した標準誤差を指定している
summary (OLSresult) # デフォルトの分析結果
Call:
lm(formula = weight ~ donuts, data = dta)

Residuals:
    Min      1Q  Median      3Q     Max
-42.238  -4.299   0.343  15.922  24.976

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)  55.6080     7.4200   7.494 1.21e-05 ***
donuts        4.1287     0.8707   4.742 0.000608 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 20.68 on 11 degrees of freedom
Multiple R-squared:  0.6715,    Adjusted R-squared:  0.6416
F-statistic: 22.48 on 1 and 11 DF,  p-value: 0.0006078
# 頑健標準誤差を使った分析結果 coeftest (OLSresult, vcov = vcovHC (OLSresult, type = "HC1" ))
t test of coefficients:

            Estimate Std. Error t value  Pr(>|t|)
(Intercept) 55.60799    7.68225  7.2385 1.668e-05 ***
donuts       4.12871    0.48053  8.5920 3.293e-06 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
最初のモデルと結果を見比べると、切片と係数の値(Estimate)自体は同じである一方、標準誤差Std. Errorの値が変わっている。
次回までに
事後学習
授業資料を見直し、目標到達をセルフチェック
WebClass上でのR実習課題(日曜日まで)
事前学習
教科書(第4章冒頭および4.1-4.3: pp.125-146)を読む。